
遇见数据集

NuTonic/sat-vl-sft-training-ready-v1

收藏
Hugging Face2026-04-30 更新2026-05-03 收录
官方服务:

资源简介:

`NuTonic/sat-bbox-metadata-sft-v1`是一个基于现有“sat-bbox”风格数据集树构建的元数据优先、程序化的视觉语言模型(VLM)监督微调(SFT)数据集。数据集的目标是为多模态聊天模型提供高质量的监督信号,包括卫星图像的标注、地物区域的定位(边界框)、特定地物类别的描述和缺失检查、跨视图推理以及类似生产环境的分析总结。数据集通过确定性、基于规则的合成方法构建,用于指令调优和格式/行为对齐,而非作为科学测量的真实数据。数据集包含多种任务类型,如生产分析、标注、定位、类别聚焦、缺失检查和跨视图推理等。数据格式为JSONL,包含聊天格式的消息列表,支持多图像和文本的交互。数据集还包括卫星图像、Mapbox静态图像(可选)和生成的分析图像。

`NuTonic/sat-bbox-metadata-sft-v1` is a metadata-first, procedural VLM SFT dataset built from an existing “sat-bbox” style dataset tree (Sentinel‑2 chips + per-tile JSON metadata sidecars, optionally paired Mapbox stills). The goal is to create high-signal, production-shaped supervision for multimodal chat models, including captioning for satellite chips, grounding (bounding boxes) for land-cover regions, class-focused captions and absence checks, cross-view reasoning, and production-like analytical summaries. The dataset is generated using deterministic, rule-based construction for instruction tuning and format/behavior alignment, not as ground-truth scientific measurements. It includes multiple task types such as production_analysis, caption, grounding_all, grounding_per_class, class_focus, absence, and cross_view. The data format is JSONL with a chat-style messages list supporting multi-image and text interactions. The dataset also includes satellite images, optional Mapbox stills, and generated analysis images.
提供机构:
NuTonic
搜集汇总
数据集介绍
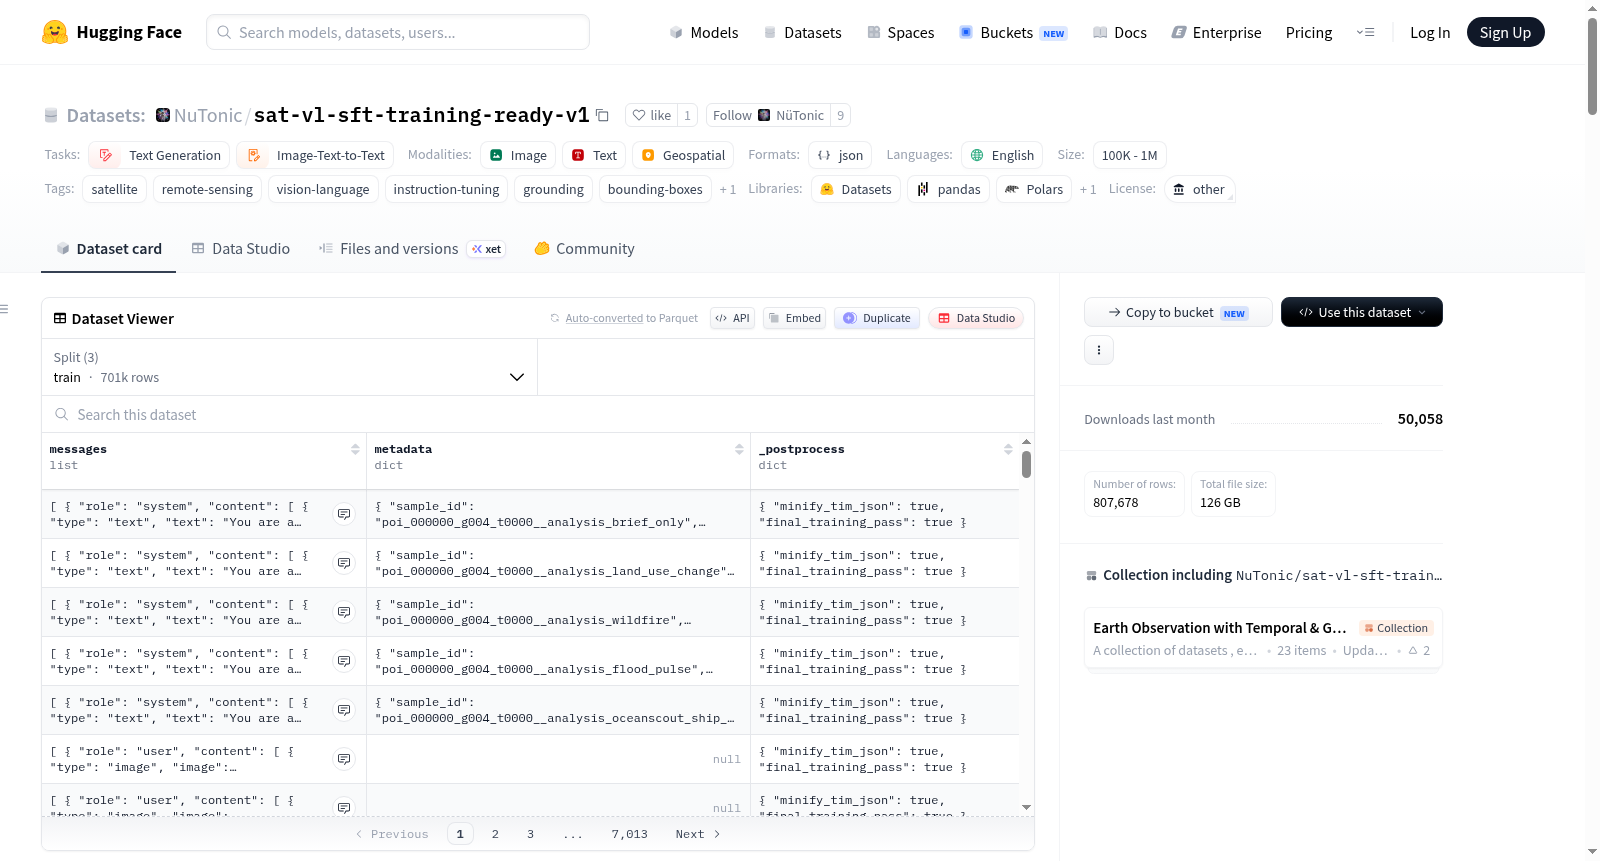
NuTonic/sat-vl-sft-training-ready-v1 数据集图片
构建方式
该数据集基于已有的卫星边界框(sat-bbox)元数据树构建,采用确定性规则与合成方法进行程序化生成。构建过程从输入数据根目录中的元数据侧车文件出发,通过遍历metadata/**/*.json文件并与data/*.jsonl文件依据tile_stem字段进行关联,为每个瓦片生成多个监督式微调任务。数据集无需调用Mapbox API,仅依赖输入数据集中已存在的路径,通过转换元数据侧车中的信息,生成包括标题、边界框定位、类别聚焦、缺失检测及跨视角推理在内的多类型训练样本。最终输出为符合聊天格式的JSONL文件,并附带分析图像与元数据侧车以供溯源。
特点
该数据集的核心特点在于其元数据优先的程序化构建范式,为多模态聊天模型提供高信号、生产级形态的监督信号。数据集覆盖遥感领域的多种任务类型,包括卫星影像的标题生成、基于归一化坐标的边界框定位、特定土地覆盖类别的聚焦描述与缺失检验,以及可选的跨视角推理。此外,生产分析任务集成了哨兵二号影像、程序化生成的分析图像与紧凑的TiM格式分析JSON块,生成面向特定应用场景(如土地利用变化、野火、洪水脉冲)的分析摘要。土地覆盖类别遵循Google Dynamic World v1体系,共划分9类,确保语义一致性。
使用方法
该数据集适用于多模态聊天模型的指令微调与行为对齐。数据以JSONL格式存储,每行包含一个messages列表,遵循通用的视觉语言模型SFT流水线格式,支持system、user与assistant角色的交替对话。图像通过相对路径引用,用户可根据需要加载影像、地图底图及分析图像。数据集已按HuggingFace Hub的目录文件限制进行分片处理,确保各子目录文件数不超过9000个。使用时需注意,许多标注目标为程序化合成信号,边界框源于元数据而非人工标注,跨视角推理任务依赖于输入数据集中是否存在地图底图路径。
背景与挑战
背景概述
sat-vl-sft-training-ready-v1数据集由NuTonic团队于近年来构建,旨在为遥感领域的多模态对话模型提供高质量的监督微调数据。该数据集基于Sentinel-2卫星影像和元数据侧边文件,通过程序化方法生成,核心研究问题在于如何利用结构化元数据生成涵盖描述、目标检测、跨视角推理等任务的指令微调样本,从而提升视觉语言模型在动态世界土地覆盖分类与变化分析中的表现。其影响力体现在为遥感基础模型与领域智能体的对齐训练提供了规模化、可复现的数据范式。
当前挑战
该数据集主要挑战包括:1)遥感图像细粒度理解问题,如土地覆盖类别的精确边界检测与语义描述,需应对地物尺度多变、云层遮挡等影像质量干扰;2)构建过程中,元数据向多任务监督信号的转换依赖确定性规则与合成方法,缺乏人工标注的校准,易引入格式偏差;3)跨视角推理任务受限于Mapbox影像的可用性,数据覆盖不均衡,且分析型摘要需兼顾领域术语的准确表达与模型可读性,避免误导性科学推断。
常用场景
经典使用场景
在遥感视觉语言模型的指令微调领域,sat-vl-sft-training-ready-v1数据集被广泛用于构建多模态对话系统的训练基准。该数据集通过程序化生成策略,将哨兵二号影像与元数据侧边文件相结合,提供了涵盖影像描述、目标接地(归一化坐标边界框)、类别聚焦描述和缺失检测等多种监督信号。其典型用法是作为大规模多模态大语言模型的指令微调数据源,支持模型学习如何根据卫星影像生成结构化的分析和交互输出,尤其是在需要同时处理图像与文本信息的复杂对话任务中表现突出。
解决学术问题
该数据集有效解决了遥感领域中视觉语言模型缺乏大规模、高质量指令微调数据的学术难题。传统的遥感数据集多侧重于单一的分类或检测任务,难以支撑多模态模型在复杂语义理解与生成方面的需求。sat-vl-sft-training-ready-v1通过程序化构建,提供了多种任务格式的对齐数据,使研究者能够系统性地研究模型在接地描述、跨视图推理、缺失类别判断等子问题上的性能。其意义在于推动了遥感智能从简单的感知任务向深层次的语义交互与决策支持迈进,为地理空间人工智能的发展奠定了数据基础。
衍生相关工作
围绕该数据集已衍生出一系列具有影响力的研究工作,包括基于程序化数据构建的多模态指令微调方法、面向遥感影像的接地描述生成模型,以及跨视图推理框架。此外,数据集引入的生产式分析JSON结构与分析图像生成策略,启发了后续在时序预测和多任务联合学习方面的探索。研究者们还借鉴其元数据优先的设计理念,开发出针对特定领域(如城市扩张监测、生态退化评估)的定制化微调数据集,进一步拓展了遥感视觉语言模型在复杂地学问题中的应用边界。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

