
遇见数据集

Douyin TikTok Story Database

收藏
github2026-08-05 更新2026-08-07 收录
官方服务:

资源简介:

一个供douyin-tiktok-story-skill使用的本地SQLite数据库,包含172个去重后可检索脚本,已移除敏感信息并执行VACUUM。

A local SQLite database intended for the douyin-tiktok-story-skill, containing 172 deduplicated and retrievable scripts, with sensitive information removed and a VACUUM operation performed.

创建时间:
2026-08-05
原始信息汇总

数据集名称:Douyin TikTok Story Database(抖音TikTok故事数据库)

数据集简介
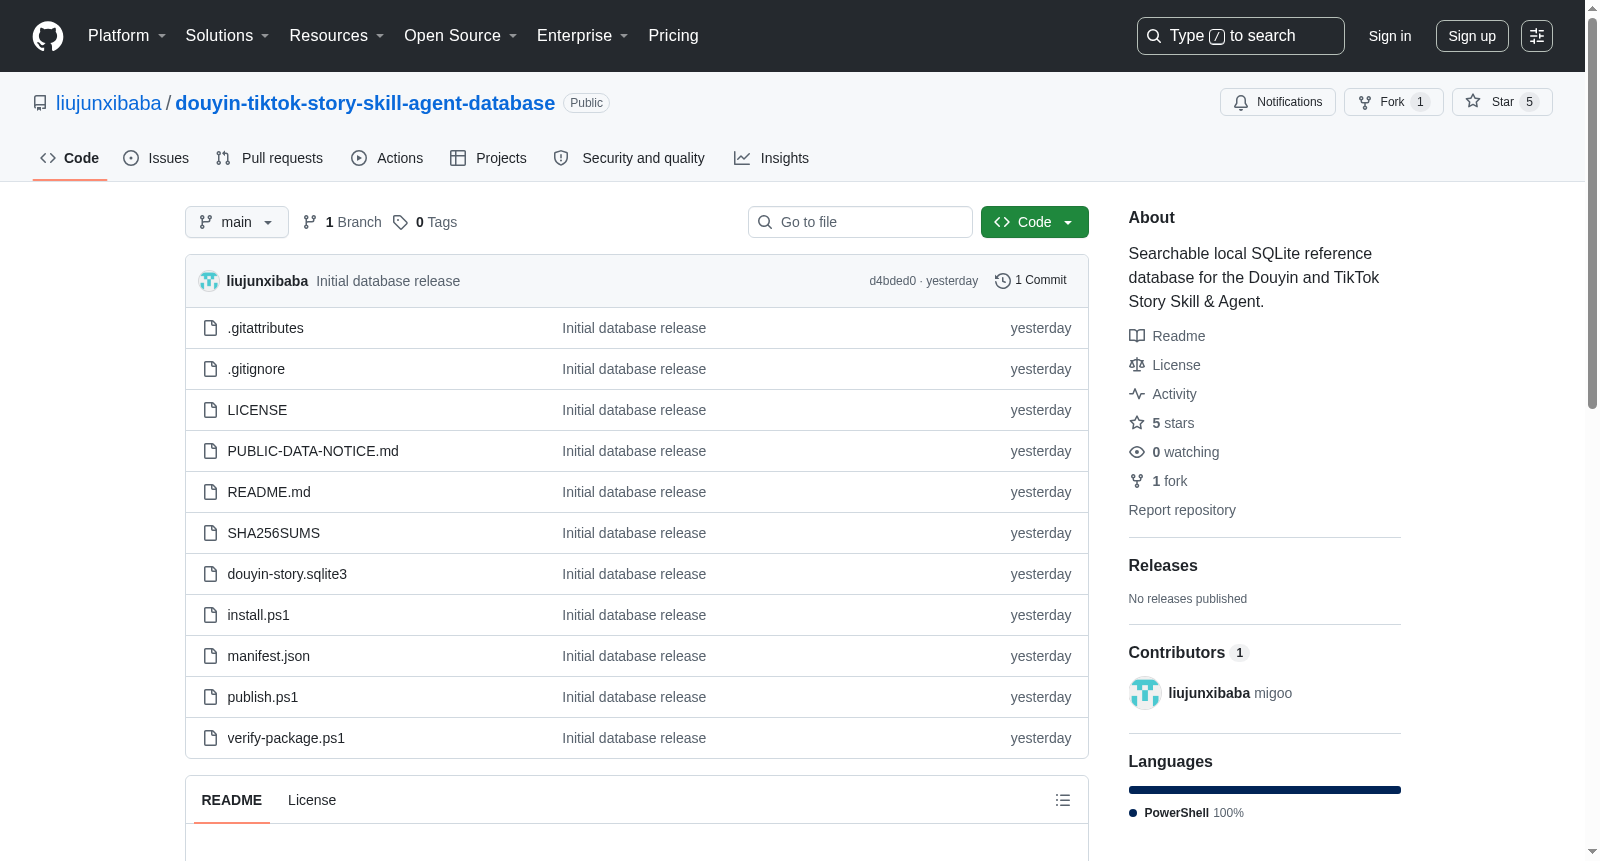
该数据集是一个专供 douyin-tiktok-story-skill 使用的本地SQLite数据库,不包含Skill运行代码,仅提供数据支持。

数据规模与组成

  • 原始文档记录:178条
  • 去重后可检索脚本:172个
  • 中文全文检索(FTS)索引:172条
  • 数据库文件:douyin-story.sqlite3

数据预处理说明

  • 已移除本机绝对路径、源素材目录、URL、邮箱和手机号,确保数据清洁与隐私安全。
  • 数据库已执行VACUUM操作,避免旧路径残留在空闲页。

安装与组合方式
该数据库需与 douyin-tiktok-story-skill 配合使用,提供两种安装方式:

  1. 从Skill仓库安装:

    cd ..douyin-tiktok-story-skill .install.ps1 -DatabaseRepoPath ..douyin-tiktok-story-database

  2. 从数据库仓库反向安装:

    .install.ps1 -SkillPath "$HOME.codexskillsdouyin-tiktok-story-skill"

许可证
数据库及仓库内可受版权保护的内容采用 CC BY 4.0 许可证。再发布或改编时需保留署名、许可链接,并说明是否修改。建议署名格式:
Douyin TikTok Story Database by douyin-tiktok-story contributors, licensed under CC BY 4.0.

搜集汇总
数据集介绍
Douyin TikTok Story Database 数据集图片
构建方式
在短视频内容生态日益丰富的当下,叙事性脚本作为内容创作的核心要素,其系统化整理与高效检索显得尤为关键。该数据集以SQLite数据库形式构建,旨在为‘douyin-tiktok-story-skill’技能提供本地化数据支撑。原始文档共计178条,经过去重处理,保留了172个可检索脚本,并为其建立中文全文索引(FTS),确保检索的全面性与准确性。构建过程中,严格移除了本机绝对路径、源素材目录、URL、邮箱及手机号等敏感信息,并执行VACUUM操作,避免旧路径残留于空闲页,保障数据纯净与安全。
特点
该数据集的核心优势在于其高度结构化与安全性的双重保障。以单一SQLite文件(douyin-story.sqlite3)封装,便于部署与迁移。索引机制依托中文FTS,能够高效响应关键词查询,满足对脚本内容的深度检索需求。数据经过去重与净化处理,排除了冗余及隐私信息,提升了数据质量。许可协议采用CC BY 4.0,允许在署名条件下自由使用与改编,为学术研究与内容创作提供了合规的开放资源。数据集与配套Skill解耦,保持了组件的轻量化与可维护性。
使用方法
使用该数据集时,需与‘douyin-tiktok-story-skill’技能协同运作。典型安装流程为:在技能仓库目录下执行install.ps1脚本,并指定数据库仓库路径,实现自动关联。亦可在数据库仓库中反向安装,通过-SkillPath参数指向已部署的技能目录,灵活适配不同开发环境。数据库文件可直接通过SQLite客户端打开,利用其内建全文索引执行查询,也可由技能运行时动态调用,以支持即时内容生成。鉴于数据已脱敏,使用过程中无需额外处理隐私事宜,且依据CC BY 4.0许可,在再发布或改编时,需保留原始署名与许可声明。
背景与挑战
背景概述
Douyin TikTok Story Database 是由 douyin-tiktok-story 贡献者创建于近期的一个结构化数据集,旨在为同名技能(Skill)提供本地化、去隐私化的短视频故事检索支持。该数据库收录了178条原始文档记录,经清洗去重后保留172条可检索脚本,并构建了中文全文索引(FTS),服务于抖音/TikTok 平台上的故事内容挖掘与分析。其核心研究问题在于如何构建一个高效、安全、可复用的本地语料库,以支撑下游自动化故事生成与检索任务。该数据库遵循 CC BY 4.0 许可,鼓励在保留署名的前提下进行再发布与改编,对短视频内容研究、隐私保护实践及本地化自然语言处理工具链的发展具有参考价值。
当前挑战
该数据集面临的挑战涵盖领域应用与构建过程两个层面。在领域层面,短视频故事内容具有口语化强、语境依赖度高、主题碎片化等特性,使得文本检索与语义理解难度大,单纯依赖关键词匹配难以保证召回率与精准度;同时,涉及用户生成内容时,隐私与版权问题尤为突出,如何在数据共享与合规使用之间取得平衡成为关键。在构建过程中,团队需处理原始文档中的噪音、冗余及敏感信息(如本机路径、URL、邮箱、手机号),并在不损失语义的前提下完成去隐私化与去重,这要求精细的数据清洗流程;此外,数据库需兼容特定 Skill 的调用规范,并确保经过 VACUUM 后无陈旧路径残留,维护了数据完整性与可移植性,但增加了工程实现上的复杂度。
常用场景
经典使用场景
该数据集以SQLite数据库形式,收录了172条经过去重与全文索引的短视频脚本,专为与douyin-tiktok-story-skill协同使用而设计。在经典使用场景中,研究者与开发者可将其作为本地知识库,通过FTS索引高效检索故事脚本,用于训练与评估内容生成模型,或构建短视频自动创作工具。数据集的轻量化结构(单一文件)与隐私清洗处理,使其成为可复现实验的理想数据源,支撑从脚本语义分析到叙事结构挖掘的多维度研究。
解决学术问题
该数据集解决了短视频脚本数据分散、格式不统一且包含敏感信息等学术研究中的数据获取难题。通过去除本机路径、URL及联系方式,并执行VACUUM清理残留,保障了数据合规性与纯净性,为自然语言处理、计算叙事学等领域提供了可靠的语料基础。其全文索引支持快速检索,显著降低数据预处理成本,使研究者能聚焦于内容生成、风格迁移及情感分析等核心问题,推动短视频内容理解与自动生成方向的研究进展。
衍生相关工作
该数据集衍生出一系列后续工作,包括开发配套的Skill插件以优化检索与生成交互流程,以及基于SQLite FTS构建轻量级脚本知识管理系统。在学术层面,研究者围绕其脚本语料开展叙事结构分析、风格模仿生成等课题,产出相关论文与方法论。社区亦贡献了数据可视化工具与多语言扩展版本,进一步挖掘数据潜力,形成从数据到应用、从研究到实践的良性生态。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

