gauge-orbit-quantization-results
收藏资源简介:
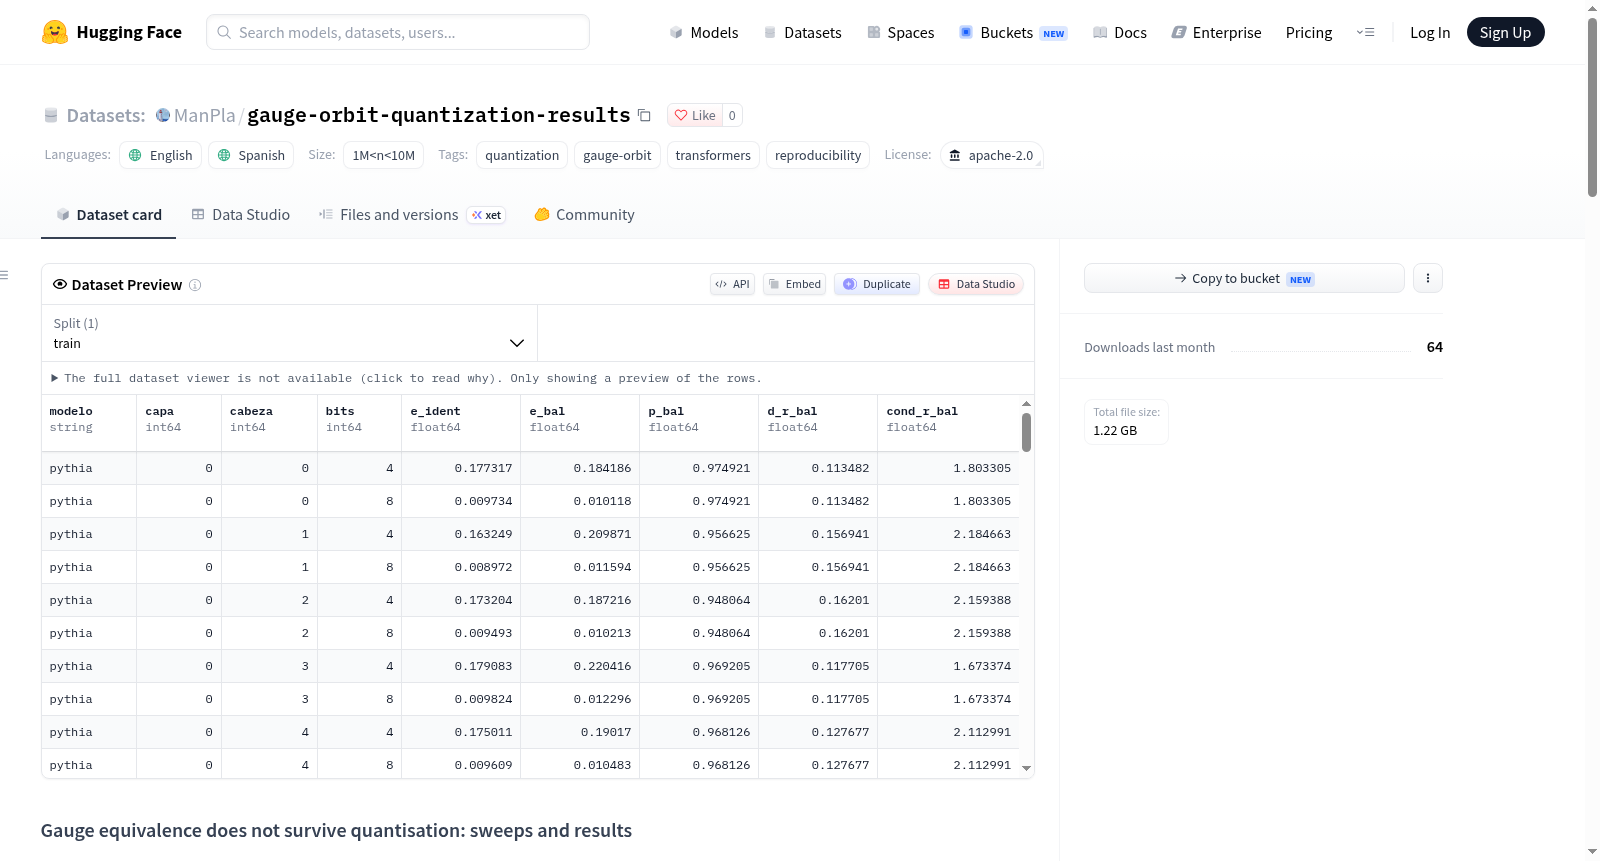
该数据集是论文《Gauge equivalence does not survive quantisation: value-output orbit, norm-product bound, and consequences for rotational methods》的配套数据,包含量化下规范等价性研究的原始扫描结果、端到端向量以及论文引用的所有读取表。数据集分为两个版本:第一版基于两个具有d_h=64的模型(ViT-B/16),提供扫描实验(如规范扫描、条件扫描等)以及端到端正确性向量;第二版扩展至八个语言模型(参数从4亿到82亿不等),包括Pythia-410M、Pythia-6.9B、RedPajama-7B、Llama-2-7B、Llama-3.1-8B、Mistral-7B、Qwen2.5-7B和Qwen3-8B-Base,总测量数达8,692,320。数据结构包括:量化轨道扫描、条件扫描、对角规范族、平衡点、激活诊断、输出诊断、端到端负对数似然和argmax向量等。所有测量值以CSV和PyTorch张量文件(.pt)形式存储,每行对应不同配置下的结果。数据集不包含模型权重,权重需从原始公开仓库获取。适用于量化、规范等价性、旋转方法、语言模型行为分析等研究任务。
This dataset is the companion data for the paper "Gauge equivalence does not survive quantisation: value-output orbit, norm-product bound, and consequences for rotational methods", containing raw scan results of gauge equivalence studies under quantization, end-to-end vectors, and all reading tables referenced in the paper. The dataset is divided into two versions: the first version is based on two models with d_h=64 (ViT-B/16), providing scanning experiments (such as gauge scans, condition scans, etc.) and end-to-end correctness vectors; the second version extends to eight language models (ranging from 400M to 8.2B parameters), including Pythia-410M, Pythia-6.9B, RedPajama-7B, Llama-2-7B, Llama-3.1-8B, Mistral-7B, Qwen2.5-7B, and Qwen3-8B-Base, with a total of 8,692,320 measurements. Data structures include quantized orbit scans, condition scans, diagonal gauge families, equilibrium points, activation diagnostics, output diagnostics, end-to-end negative log-likelihood and argmax vectors, etc. All measurements are stored as CSV and PyTorch tensor files (.pt), with each row corresponding to results under different configurations. The dataset does not contain model weights; weights need to be obtained from the original public repositories. Suitable for research tasks such as quantization, gauge equivalence, rotational methods, and language model behavior analysis.
Gauge equivalence does not survive quantisation: sweeps and results
数据集概述
- 许可证:apache-2.0
- 语言:en、es
- 标签:quantization、gauge-orbit、transformers、reproducibility
- 数据规模:1M<n<10M
- 内容定位:该数据集是关于论文《Gauge equivalence does not survive quantisation: value-output orbit, norm-product bound, and consequences for rotational methods》(Manuel Muñoz Plá, 2026, v2.1)的原始 sweep 数据、端到端向量以及读取表格。
- 目录结构:与代码仓库保持一致,可直接覆盖到代码仓库克隆副本上,所有读取脚本无需修改即可运行。
- 代码仓库:https://github.com/mmunozpl/gauge-orbit-quantization (tag
v2.1) - 代码与 PDF 存档:Zenodo,版本 DOI 10.5281/zenodo.23068428,概念 DOI 10.5281/zenodo.22904207
第二版本:八个语言模型
包含八个语言模型(0.4 至 8.2 亿参数)权重中的 8,692,320 次测量,以及每种条件的端到端向量。
数据文件
| 路径 | 行数 | 支撑内容 |
|---|---|---|
artifacts/logs/quant_orbita/quant_orbita_v2.csv |
1,406,496 | regime sweep:恒等、per-head 与共享正交、一般 GL |
artifacts/logs/quant_kappa/quant_kappa_v2.csv |
5,311,488 | 受控条件化 sweep |
artifacts/logs/quant_kappa/quant_familia_v2.csv |
847,392 | 带范数的原始族 |
artifacts/logs/quant_kappa/quant_diagonal_v2.csv |
1,118,208 | 对角 gauge 族(F3) |
artifacts/logs/quant_kappa/punto_balanceado_v2.csv |
8,736 | 平衡点,八个模型与两种位宽 |
artifacts/logs/quant_orbita/diagnostico_activaciones_{model}.csv |
每个 cell 与 gauge | D1,按激活加权的电路误差 |
artifacts/logs/quant_orbita/diagnostico_salida_{model}.csv |
每层与配置 | D2,注意力块输出的误差 |
artifacts/logs/quant_orbita/e2e_v2_{model}.pt |
7 个条件 | WikiText-2 上端到端验证的每窗口 NLL 与每 token argmax |
artifacts/logs/quant_orbita/e2e_extra_v2_{model}_{round}.pt |
每轮 | 轮次 E2 至 E8 的相同向量:Haar 抽取、层、共享、第二量化器、逐层与第二语料 |
artifacts/tables/*.csv |
论文引用的每张读取表格,两个版本均有 | |
artifacts/tables/config_claves_v2.csv |
167 | 配置键、八个模型的仓库与修订版本 |
paper/*.pdf |
由 tag v2.1 冻结的两个 PDF,与 GitHub 和 Zenodo 字节一致 |
|
sello.json |
v2.1 封存部件的 sha256 清单 |
e2e_v2_qwen3-8b_bf16.pt是论文作为精度注记记录的被弃用的半精度测量。
八个模型
权重未在此重新分发,从以下公共仓库的指定修订版本读取;Meta 的模型需要接受其许可证。
| 论文中的模型 | 仓库 | 修订版本 |
|---|---|---|
| Pythia-410M | EleutherAI/pythia-410m |
9879c9b5f8bea9051dcb0e68dff21493d67e9d4f |
| Pythia-6.9B | EleutherAI/pythia-6.9b |
c0e3eee36dc47af0c49f361c74cfe459c09f7f23 |
| RedPajama-7B | togethercomputer/RedPajama-INCITE-7B-Base |
78f7e482443971f4873ba3239f0ac810a367833b |
| Llama-2-7B | meta-llama/Llama-2-7b-hf |
01c7f73d771dfac7d292323805ebc428287df4f9 |
| Llama-3.1-8B | meta-llama/Llama-3.1-8B |
d04e592bb4f6aa9cfee91e2e20afa771667e1d4b |
| Mistral-7B | mistralai/Mistral-7B-v0.3 |
caa1feb0e54d415e2df31207e5f4e273e33509b1 |
| Qwen2.5-7B | Qwen/Qwen2.5-7B |
d149729398750b98c0af14eb82c78cfe92750796 |
| Qwen3-8B-Base | Qwen/Qwen3-8B-Base |
49e3418fbbbca6ecbdf9608b4d22e5a407081db4 |
- 论文的结果表格与图表将 Qwen3-8B-Base(仅预训练检查点)缩写为 Qwen3-8B,此处文件使用键
qwen3-8b。
第一版本:两个 d_h = 64 的模型
| 路径 | 行数 | 支撑内容 |
|---|---|---|
artifacts/logs/quant_orbita/quant_orbita.csv |
170,016 | regime sweep:恒等、per-head 与共享正交、一般 GL |
artifacts/logs/quant_kappa/quant_kappa.csv |
642,048 | 受控条件化 sweep |
artifacts/logs/quant_kappa/quant_familia.csv |
102,432 | 带范数的原始族的重新 sweep |
artifacts/logs/quant_kappa/punto_balanceado.csv |
1,056 | 平衡点,两个模型与位宽 |
artifacts/logs/quant_orbita/aciertos_e2e.pt |
7 × 5,000 | 每个端到端条件的逐图像正确性 |
artifacts/logs/quant_orbita/predicciones_e2e.pt |
7 × 5,000 | 每个条件的逐图像预测类别(argmax) |
- 每个采样 gauge 通过重放 sweep 所消费的生成器序列精确重建;矩阵不存储。
- ViT-B/16 检查点是先前工作(https://doi.org/10.57967/hf/9742)所发布的,此处不重复。
引用
bibtex @software{munozpla2026gaugeequivalence, author = {Muñoz Plá, Manuel}, title = {Gauge equivalence does not survive quantisation: value-output orbit, norm-product bound, and consequences for rotational methods}, year = {2026}, version = {v2.1}, doi = {10.5281/zenodo.22904207}, url = {https://github.com/mmunozpl/gauge-orbit-quantization} }