
MED_SYN0_VA_train
收藏官方服务:
资源简介:
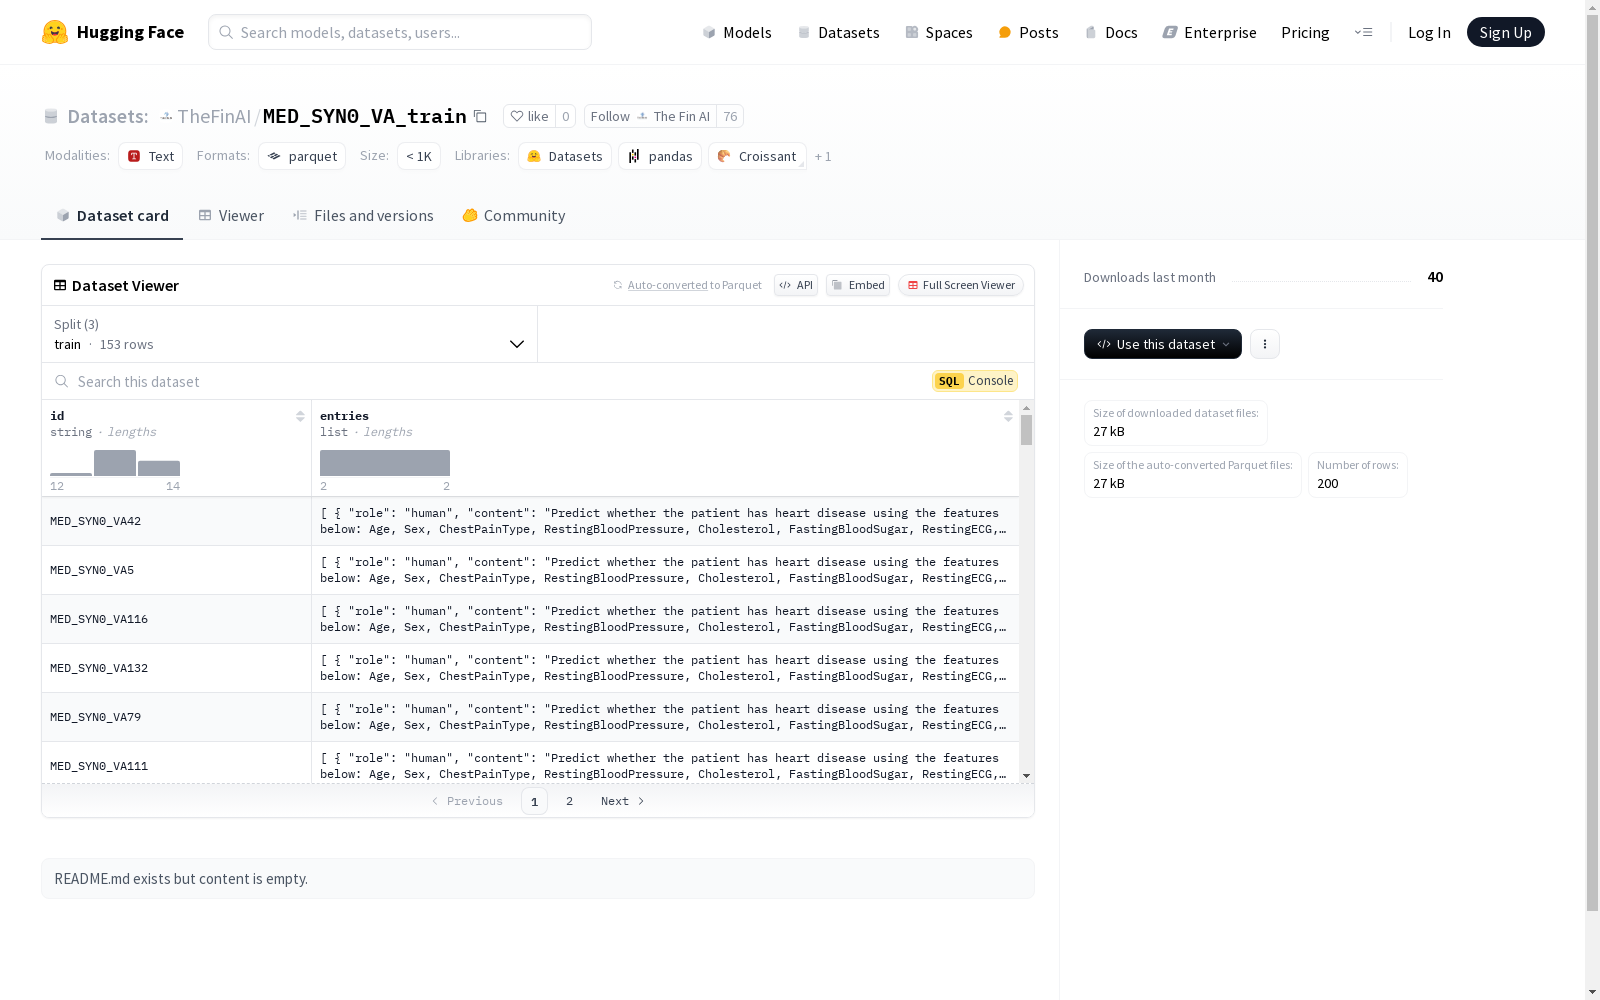
该数据集包含多个条目,每个条目由角色(role)和内容(content)组成。数据集分为训练集(train)、验证集(val)和测试集(test)三个部分,分别包含153、27和20个示例。数据集的下载大小为20101字节,总大小为150449字节。数据文件按照分割类型存储在指定路径下。
This dataset comprises multiple entries, where each entry consists of a role and content. The dataset is divided into three splits: training set (train), validation set (val), and test set, which respectively contain 153, 27, and 20 samples. The download size of the dataset is 20101 bytes, and the total storage size is 150449 bytes. The data files are stored at the designated path according to their split types.
提供机构:
The Fin AI创建时间:
2025-01-25
搜集汇总
数据集介绍
构建方式
MED_SYN0_VA_train数据集的构建,是通过收集具有明确角色标识和相应内容的条目,经过结构化处理,形成包含'id'、'entries'字段的记录。其中,'entries'字段又包含'role'和'content'两个子字段,用以区分对话中的角色和内容。数据集分为训练集、验证集和测试集三个部分,分别存储在不同的文件路径下,确保模型的训练和评估的独立性和有效性。
特点
该数据集的特点在于其专注于医学对话场景,每个条目均清晰地标注了对话角色和内容,有利于模型的精准学习和泛化。此外,数据集规模适中,便于快速迭代和测试模型性能。其结构化的数据格式,也便于进行数据预处理和后续的分析工作。
使用方法
使用MED_SYN0_VA_train数据集,用户首先需要从指定的路径下载相应的数据文件。然后,可以根据HuggingFace库提供的接口,加载并处理数据集。用户可以根据需要,对训练集、验证集和测试集分别进行操作,以完成模型的训练、验证和测试等任务。数据集的加载和迭代过程中,用户可以利用其提供的功能,高效地进行数据访问和模型评估。
背景与挑战
背景概述
MED_SYN0_VA_train数据集,诞生于医学影像分析领域,旨在为研究人员提供一个综合性的虚拟医疗影像训练资源。该数据集由专业的医疗机构与科研人员合作创建于近年,主要针对的是虚拟医疗影像的标注与识别问题。其包含了大量的医疗影像数据,为相关领域的研究提供了丰富的样本资源,对于推动医学影像诊断的自动化与智能化具有显著影响。
当前挑战
在研究领域,MED_SYN0_VA_train数据集面临的挑战主要涉及两个方面:一是数据集在解决医学影像标注与识别领域问题时,如何确保标注的准确性与一致性,这直接关系到后续诊断的可靠性;二是数据集构建过程中,如何处理隐私保护与数据共享的平衡问题,确保患者隐私不被泄露的同时,又能为研究提供充足的数据支持。
常用场景
经典使用场景
在医学文本分析领域,MED_SYN0_VA_train数据集的经典使用场景在于构建与训练自然语言处理模型,该模型能够识别并提取医学文献中的关键信息,如病症描述、治疗方案等,以支持医学研究的自动化信息整理。
解决学术问题
该数据集解决了学术研究中,尤其是医学文本挖掘领域中,信息提取自动化程度低、准确率不足的问题。它为研究者提供了一个标注详尽的医学文本数据集,有助于提升模型的准确度和鲁棒性,对于促进医学知识图谱的构建具有深远影响。
衍生相关工作
基于MED_SYN0_VA_train数据集,研究者们衍生出了多项相关工作,如疾病预测模型、医学文本分类系统等,这些工作不仅推动了医学自然语言处理领域的发展,也为医学信息化和智慧医疗的实施提供了强有力的技术支持。
以上内容由遇见数据集搜集并总结生成


