
遇见数据集

polymarket-kalshi-scoresync-orderbook-sample

收藏
Hugging Face2026-06-26 更新2026-06-29 收录
官方服务:

资源简介:

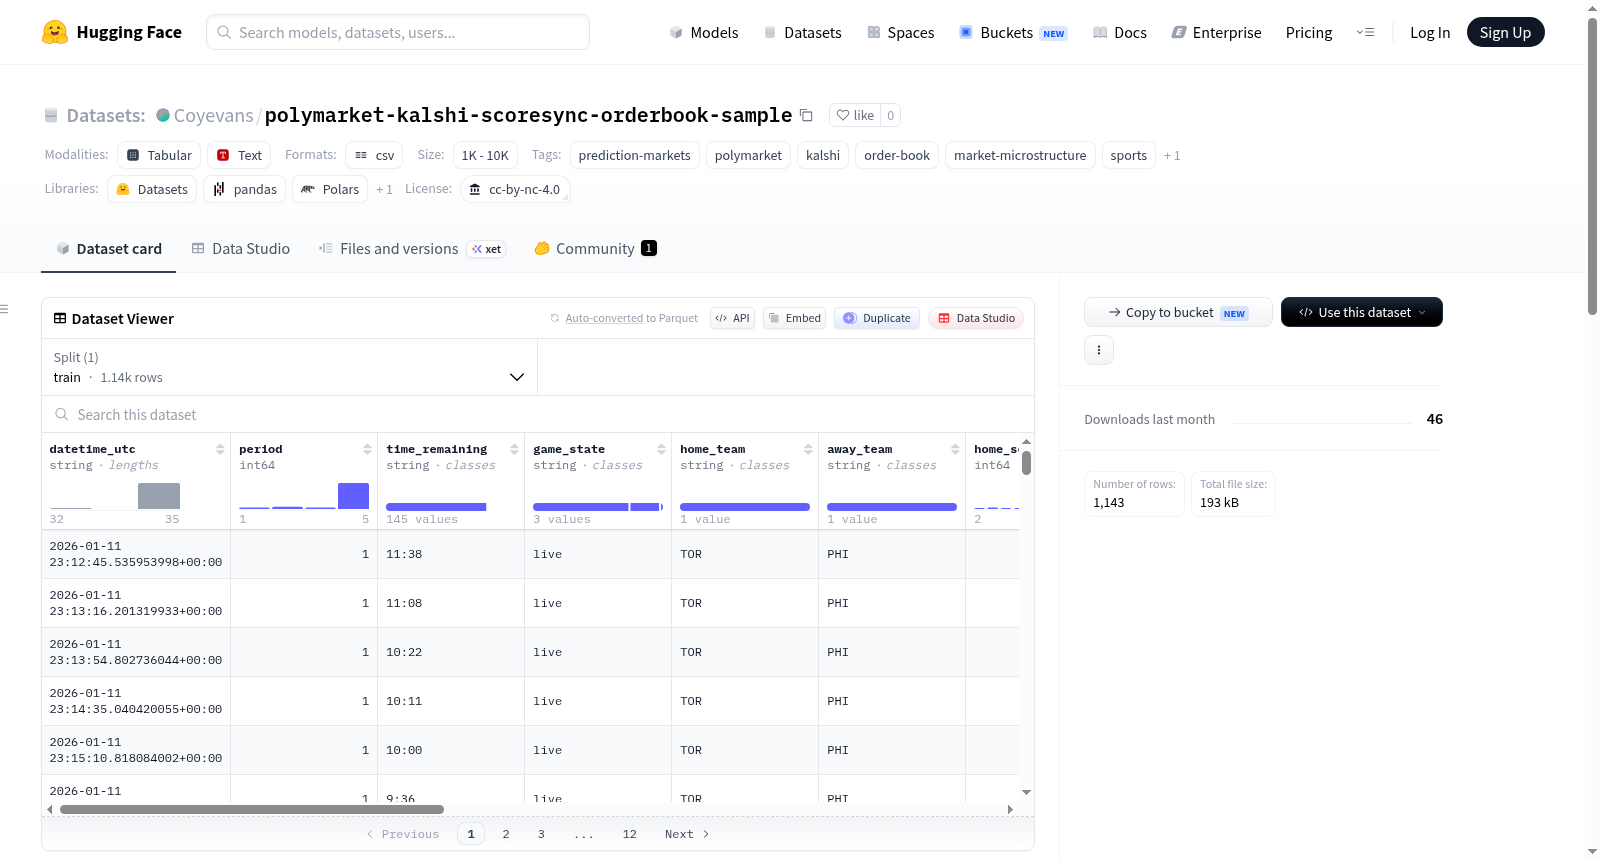
Polymarket x Kalshi订单簿存档 - 免费分数同步样本数据集是ZenHodl发布的Polymarket和Kalshi历史订单簿存档的免费摘录,旨在验证两个不可重构的特征:每行分数同步和跨平台数据关联。每行Kalshi数据均包含实时比赛状态(主队得分、客队得分、分差、比赛阶段、剩余时间、比赛状态),并与顶级报价(买价、卖价、中间价、价差)同步。样本聚焦于一场NBA比赛(PHI @ TOR,116–115加时赛)的Kalshi“Philadelphia wins”赔率市场,包含1,844个捕获的快照,共26列数据。数据以Parquet和CSV格式提供,并附有数据质量说明(如约33秒中位快照间隔、仅顶级报价、约0.2%的短暂分数馈送问题)。该数据集适用于预测市场研究、回测和模型训练,非交易信号用途。完整存档包含约1.1亿Kalshi和2560万Polymarket分数同步快照。许可证为CC-BY-NC-4.0。

The Polymarket x Kalshi Order Book Archive - Free Score-Synchronized Sample Dataset is a free excerpt of the historical order book archives of Polymarket and Kalshi released by ZenHodl, designed to validate two non-reconstructable features: per-row score synchronization and cross-platform data association. Each row of Kalshi data contains real-time game status (home team score, away team score, point difference, game phase, remaining time, game state) and is synchronized with top-of-book quotes (bid price, ask price, mid-price, spread). The sample focuses on the Kalshi "Philadelphia wins" odds market for an NBA game (PHI @ TOR, 116–115 overtime), containing 1,844 captured snapshots with a total of 26 data columns. The data is provided in Parquet and CSV formats, accompanied by data quality notes (e.g., a median snapshot interval of ~33 seconds, top-of-book quotes only, ~0.2% temporary score feed issues). This dataset is intended for prediction market research, backtesting, and model training, and is not for trading signal purposes. The full archive contains approximately 110 million Kalshi and 25.6 million Polymarket score-synchronized snapshots. The license is CC-BY-NC-4.0.
创建时间:
2026-06-26
搜集汇总
数据集介绍
polymarket-kalshi-scoresync-orderbook-sample 数据集图片
构建方式
本数据集源自ZenHodl平台对Polymarket与Kalshi两大预测市场的历史订单簿档案的精选抽取,专注于提供跨交易所的比分同步报价数据。其核心构建逻辑在于实时捕获比赛进行中的盘口状态,并将每一笔Kalshi报价行与对应的比赛现场比分、分差、剩余时间、比赛阶段等动态信息进行逐行关联,形成一种无法事后重建的独特数据关联。数据集仅提供顶部订单簿报价,包括买一价、卖一价、中间价与价差,而非完整的深度层级信息,确保了数据在微观结构分析中的实用性。该样本集覆盖一场具有加时赛的NBA比赛,共计捕获1844个快照,以Parquet与CSV两种格式发布,并附有详细的数据卡片说明来源与质量标注。
特点
该数据集最显著的特点在于其独有的‘比分同步’机制,使得每条行情报价均携带精确到秒的比赛实时状态,为预测市场的定价效率研究提供了前所未有的细粒度观测窗口。通过观察比赛进程中市场中间价的剧烈波动,例如从0.36至0.65的完整区间摆动,用户可以直观验证市场价格对赛事进展的即时反应。数据集同时实现了跨交易所的时序对齐,将同一场比赛在Polymarket与Kalshi上的定价行为统一在一条时间线上,便于进行价差套利与市场效率的比较分析。数据质量方面,虽然存在约33秒的中位快照间隔与约0.2%的短暂比分异常,但提供了清晰的清洗指引,以维护分析结果的可靠性。
使用方法
用户可通过直接读取Parquet或CSV文件快速上手,使用Python中的Pandas库即可完成数据加载。对于数据清洗,建议按照时间戳排序后,采用非递减得分过滤策略剔除因比分数据异常导致的行,即保留主场与客场得分均未发生回落的观测值。该数据集适用于预测市场的定价校准实证分析、基于实时赛事信息的策略回测,以及跨交易所市场微观结构的比较研究。研究人员可将此样本作为验证数据质量的试金石,再决定是否获取覆盖110M条Kalshi与25.6M条Polymarket完整记录的归档数据,用于更大规模的模型训练与学术分析。
背景与挑战
背景概述
Polymarket与Kalshi作为新兴预测市场平台,在体育赛事、政治事件等领域的概率定价中扮演着日益重要的角色。该数据集由ZenHodl团队于2026年创建,聚焦于跨交易所的实时订单簿数据,核心研究问题在于如何将历史报价与不可回溯的实时比赛状态(如比分、剩余时间)进行精确对齐。通过提供同一场NBA比赛的跨平台报价快照,该数据集为市场微观结构分析、交易策略回测以及预测市场效率验证提供了独特资源。其影响力体现在填补了现有公开数据集中缺乏跨交易所同步状态信息的空白,有望推动预测市场校准研究的发展。
当前挑战
该数据集致力于解决的核心领域问题在于,传统订单簿数据无法回溯关联实时赛事状态,导致预测市场概率与赛场信息的相关性分析存在根本性障碍——这种跨模态时间序列的对齐在事件发生后不可复现。构建过程中面临的主要挑战包括:跨平台高频数据采集的时序同步难题,实测中仅能达到约33秒的中位快照间隔;数据质量需应对约0.2%的比赛状态瞬态异常(如比分归零的短暂闪断);以及仅包含顶层报价(top-of-book)而缺乏深度阶梯信息的局限性,这限制了订单簿微观结构分析的完整性。
常用场景
经典使用场景
该数据集作为预测市场领域的高频订单簿快照档案,最经典的使用场景在于为金融市场微观结构研究提供跨交易所的实时定价数据。通过将Polymarket与Kalshi两大预测平台上的同一体育赛事订单簿报价与比赛进程的实时比分、时间等状态信息进行精确同步,研究者能够捕捉到市场情绪随比赛局势演变的动态变化,从而深入分析信息融入价格的过程。这种精心对齐的数据结构尤其适用于验证预测市场的价格发现效率,并构建基于实时事件的定价模型。
实际应用
在实际应用层面,该数据集为量化分析师和算法交易开发者提供了珍贵的回测素材。基于跨交易所的实时定价对齐信息,从业者可以构建和优化套利策略,利用Polymarket与Kalshi同赛事合约间的价差进行统计套利。数据集中的比分同步属性使得运动博彩行业能够开发实时概率估计模型,将盘口赔率与市场隐含概率进行对比分析。此外,金融科技公司也可借助该数据训练预测市场定价算法,评估不同赛事阶段的市场深度与流动性特征,为自动做市策略的参数优化提供实证基础。
衍生相关工作
该数据集衍生了一系列开创性学术工作,其中最经典的是关于预测市场动态定价机制的实证研究。基于此数据,学者首次实现了对同一赛事在不同预测平台上的价格发现效率进行直接比较,验证了跨市场套利机会的存在及其衰减模式。后续研究利用该数据集构建了基于深度学习的实时胜率预测模型,并将市场隐含概率与传统体育统计模型进行了校准分析。另一重要贡献是将连续时间金融中的高频模型应用于预测市场数据,开创性地分析了信息冲击条件下订单簿弹性的动态特征,以及不同比赛阶段市场微观结构的变化规律。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

