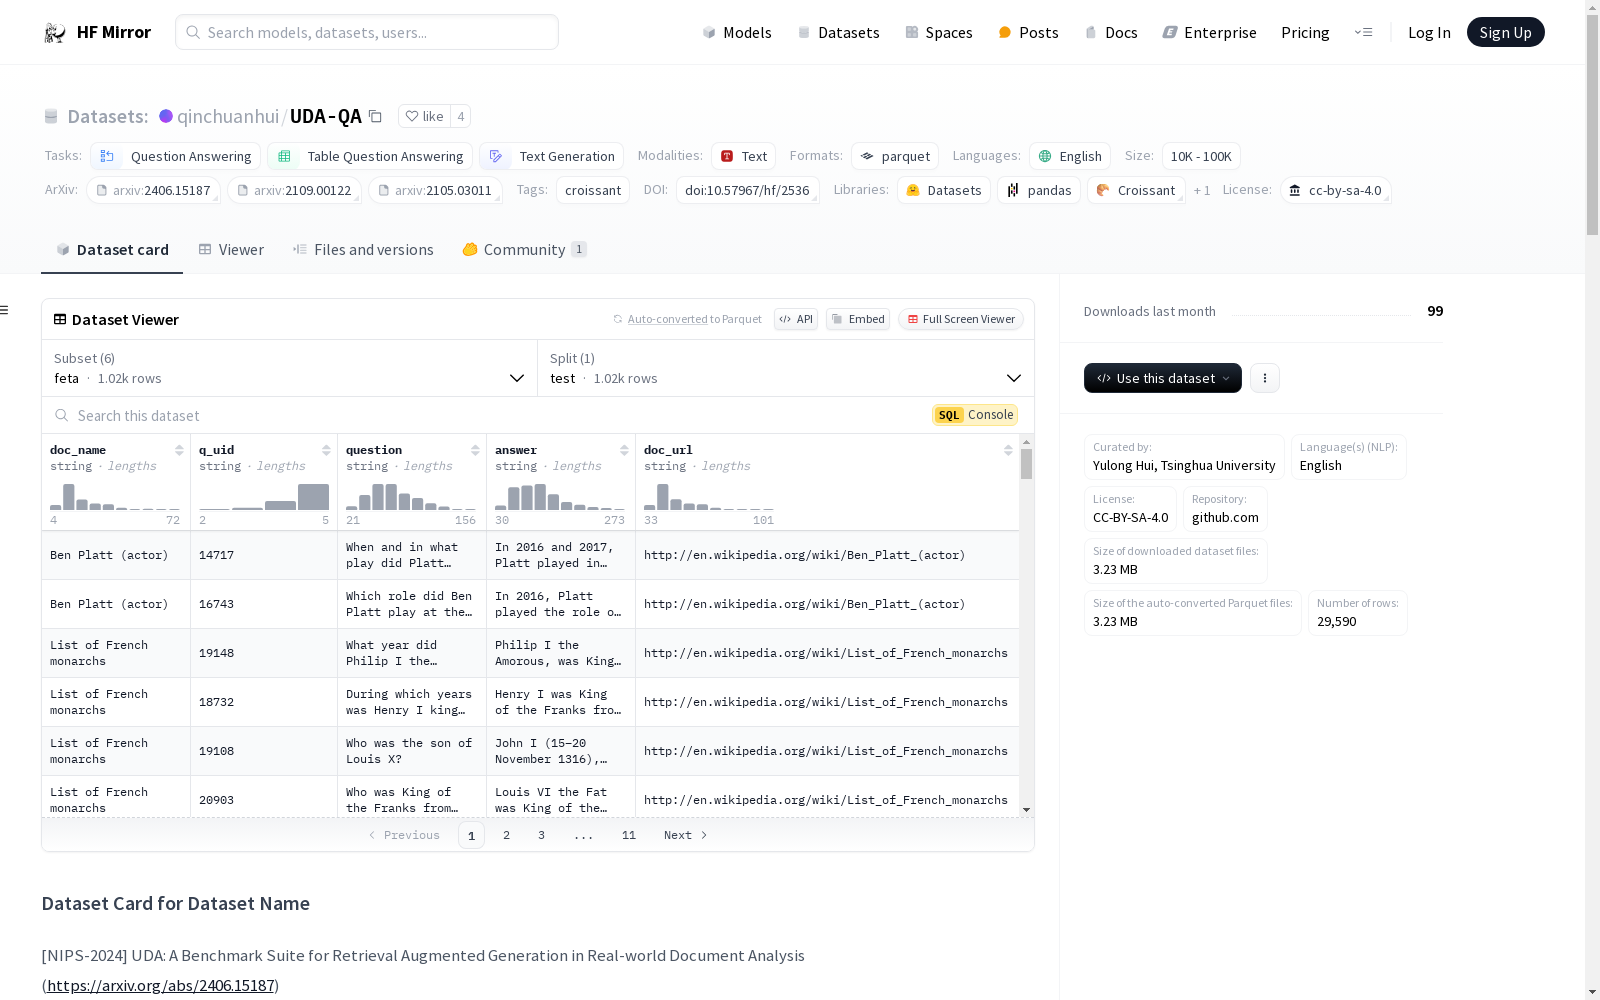
qinchuanhui/UDA-QA
收藏资源简介:
UDA(非结构化文档分析)是一个用于现实世界文档分析中检索增强生成(RAG)的基准套件。UDA数据集中的每个条目都组织为*文档-问题-答案*三元组,其中问题从文档中提出,并附有相应的真实答案。文档以其原始文件格式保留,未进行解析或分段;它们包括文本和表格数据,反映了现实世界分析场景的复杂性。
UDA (Unstructured Document Analysis) is a benchmark suite for retrieval-augmented generation (RAG) in real-world document analysis. Each entry in the UDA dataset is organized as *document-question-answer* triples, where questions are formulated from the corresponding documents and paired with their ground-truth answers. Documents are preserved in their original file formats without parsing or segmentation; they contain both textual and tabular data, reflecting the complexity of real-world document analysis scenarios.
数据集概述
基本信息
- 许可证: CC-BY-SA-4.0
- 任务类别:
- 问答
- 表格问答
- 文本生成
- 语言: 英语
- 标签: croissant
- 数据集名称: UDA-QA
- 数据集大小: 10K<n<100K
配置名称
- feta
- nq
- paper_text
- paper_tab
- fin
- tat
数据集详情
配置详情
feta
- 特征:
doc_name: 字符串q_uid: 字符串question: 字符串answer: 字符串doc_url: 字符串
nq
- 特征:
doc_name: 字符串q_uid: 字符串question: 字符串short_answer: 字符串long_answer: 字符串doc_url: 字符串
paper_text
- 特征:
doc_name: 字符串q_uid: 字符串question: 字符串answer_1: 字符串answer_2: 字符串answer_3: 字符串
paper_tab
- 特征:
doc_name: 字符串q_uid: 字符串question: 字符串answer_1: 字符串answer_2: 字符串answer_3: 字符串
fin
- 特征:
doc_name: 字符串q_uid: 字符串question: 字符串answer_1: 字符串answer_2: 字符串
数据文件
- feta:
split: testpath: feta/test*
- nq:
split: testpath: nq/test*
- paper_text:
split: testpath: paper_text/test*
- paper_tab:
split: testpath: paper_tab/test*
- fin:
split: testpath: fin/test*
- tat:
split: testpath: tat/test*
数据集描述
UDA (Unstructured Document Analysis) 是一个用于增强生成 (RAG) 在实际文档分析中的基准套件。每个条目都组织为一个 文档-问题-答案 三元组,其中问题从文档中提出,并附有相应的真实答案。文档保留其原始文件格式,没有解析或分割;它们包含文本和表格数据,反映了现实世界分析场景的复杂性。
数据集结构
描述性统计
| 子数据集 (folder_name) | 来源领域 | 文档格式 | 文档数量 | Q&A 数量 | 平均字数 | 平均页数 | Q&A 类型 |
|---|---|---|---|---|---|---|---|
| FinHybrid (fin) | 财务报告 | 788 | 8190 | 76.6k | 147.8 | 算术 | |
| TatHybrid (tat) | 财务报告 | 170 | 14703 | 77.5k | 148.5 | 抽取式, 计数, 算术 | |
| PaperTab (paper_tab) | 学术论文 | 307 | 393 | 6.1k | 11.0 | 抽取式, 是/否, 自由形式 | |
| PaperText (paper_text) | 学术论文 | 1087 | 2804 | 5.9k | 10.6 | 抽取式, 是/否, 自由形式 | |
| FetaTab (feta) | 维基百科 | PDF & HTML | 878 | 1023 | 6.0k | 14.9 | 自由形式 |
| NqText (nq) | 维基百科 | PDF & HTML | 645 | 2477 | 6.1k | 14.9 | 抽取式 |
数据字段
| 字段名称 | 字段值 | 描述 | 示例 |
|---|---|---|---|
| doc_name | 字符串 | 源文档名称 | 1912.01214 |
| q_uid | 字符串 | 问题的唯一ID | 9a05a5f4351db75da371f7ac12eb0b03607c4b87 |
| question | 字符串 | 提出的问题 | which datasets did they experiment with? |
| answer 或 answer_1, answer_2 或 short_answer, long_answer | 字符串 | 真实答案/答案 | Europarl, MultiUN |
附加说明: 某些子数据集可能有多个真实答案,答案组织为 answer_1, answer_2(在 FinHybrid, PaperTab 和 PaperText 中)或 short_answer, long_answer(在 NqText 中);在 TatHybrid 子数据集中,答案组织为一个序列,由于涉及多跨度 Q&A 类型。此外,某些子数据集可能有独特的数据字段。例如,doc_url 在 FetaTab 和 NqText 中描述维基百科 URL 页面,而 answer_type 和 answer_scale 在 TatHybrid 中提供扩展答案参考。