copenlu/spiced
收藏资源简介:
SPICED(科学释义和信息变化数据集)是一个包含来自科学论文、新闻媒体和Twitter的配对科学发现的数据集。配对类型包括<论文, 新闻>和<论文, 推文>。每对句子都标注了信息相似度评分(IMS),评分范围为1到5。数据集从S2ORC中提取科学文本,并通过Altmetric匹配新闻文章和推文。实例由专家通过Prolific平台和Potato进行标注。数据集支持的任务是预测两个科学句子之间的IMS,优选指标为均方误差和皮尔逊相关系数。数据集的语言为英语,数据字段包括DOI、实例ID、新闻发现、论文发现、新闻上下文、论文上下文、评分、学术领域、数据集分割、最终评分、来源和新闻URL。数据集分为训练集(4721个实例)、验证集(664个实例)和测试集(640个实例)。
SPICED (Scientific Paraphrase and Information Change Dataset) is a dataset consisting of paired scientific discoveries sourced from scientific papers, news media, and Twitter. The pairing types include <paper, news> and <paper, tweet>. Each sentence pair is annotated with an Information Similarity Score (IMS) ranging from 1 to 5. Scientific texts are extracted from S2ORC, and news articles and tweets are matched via Altmetric. Instances are annotated by experts through the Prolific platform and Potato. The task supported by this dataset is predicting the IMS between two scientific sentences, with the preferred evaluation metrics being Mean Squared Error (MSE) and Pearson Correlation Coefficient. The dataset is in English, and its data fields include DOI, instance ID, news discovery, paper discovery, news context, paper context, score, academic field, dataset split, final score, source, and news URL. The dataset is divided into training set (4,721 instances), validation set (664 instances), and test set (640 instances).
数据集概述:SPICED
数据集描述
数据集总结
-
名称: SPICED (Scientific Paraphrase and Information ChangE Dataset)
-
内容: 包含科学论文、新闻媒体和Twitter中的科学发现配对数据集。配对类型包括<paper, news>和<paper, tweet>。
-
标注: 每个配对根据描述的发现信息相似度进行1-5分的标注,称为_Information Matching Score (IMS)_。
-
来源: 数据来源于S2ORC,新闻文章和推文通过Altmetric匹配。
-
使用指南: 使用时请引用以下文献:
@article{modeling-information-change, title={{Modeling Information Change in Science Communication with Semantically Matched Paraphrases}}, author={Wright, Dustin and Pei, Jiaxin and Jurgens, David and Augenstein, Isabelle}, year={2022}, booktitle = {Proceedings of EMNLP}, publisher = {Association for Computational Linguistics}, year = 2022 }
支持的任务和排行榜
- 任务: 预测两个科学句子之间的IMS,范围为1至5。
- 评估指标: 均方误差和皮尔逊相关系数。
语言
- 语言: 英语
数据集结构
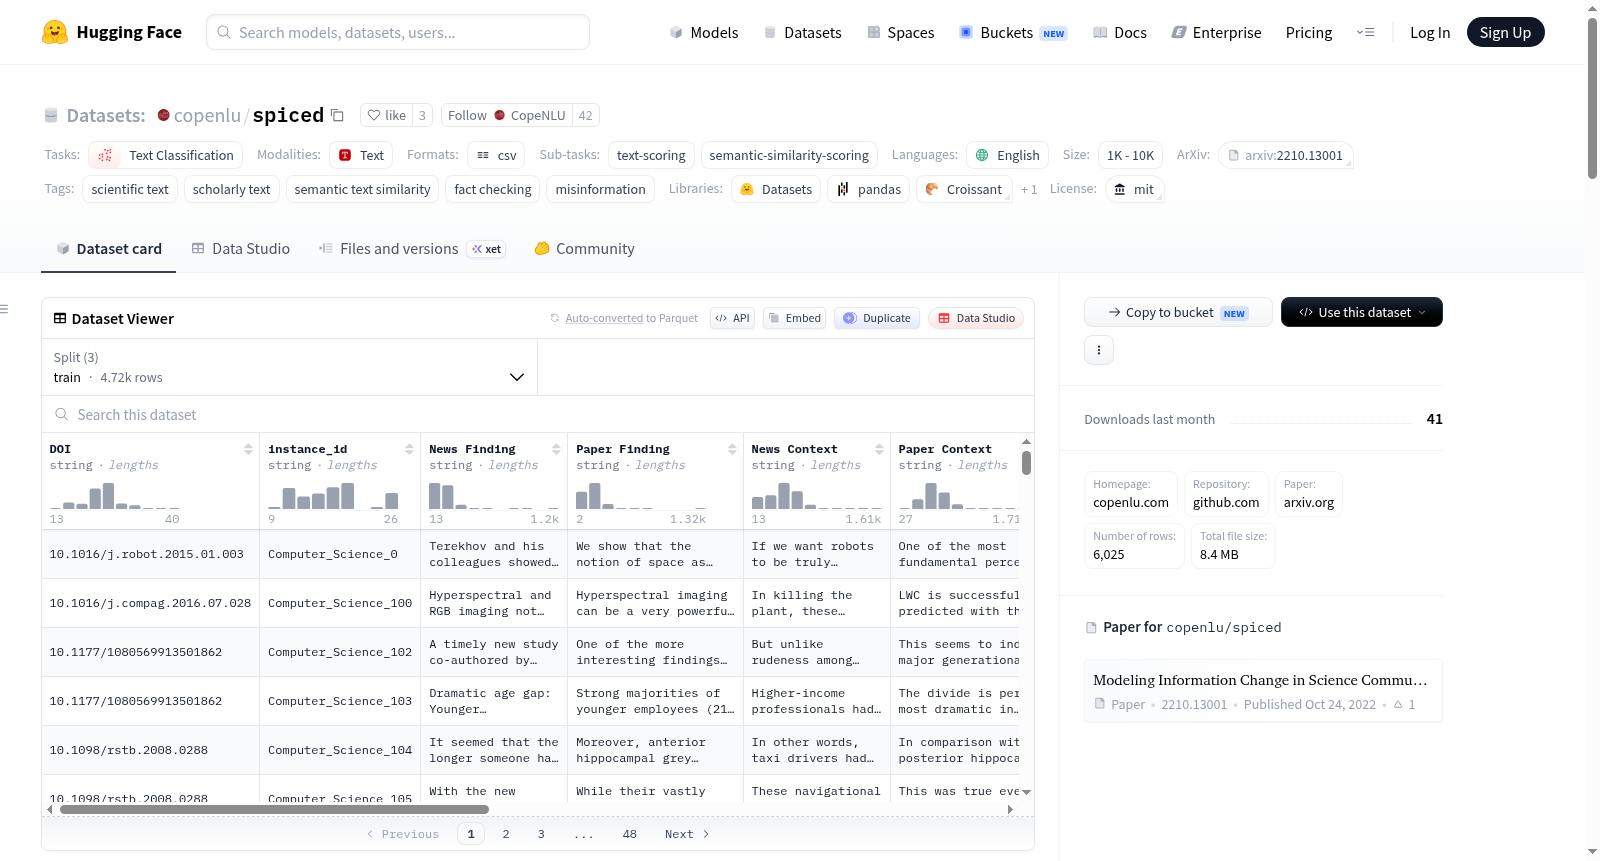
数据字段
- DOI: 原始科学文章的DOI
- instance_id: 样本的唯一实例ID
- News Finding: 新闻或推文发现的文本
- Paper Finding: 论文发现的文本
- News Context: 新闻实例的周围两句话,推文则为推文本身
- Paper Context: 论文发现的周围两句话
- scores: 移除低能力标注者后的标注者分数
- field: 论文的学术领域(计算机科学、医学、生物学、心理学)
- split: 数据集分割(训练、验证、测试)
- final_score: 实例的IMS
- source: 来源类型(新闻或推文)
- News Url: 新闻实例的源文章URL或推文的推文ID
数据分割
- 训练: 4721个实例
- 验证: 664个实例
- 测试: 640个实例
数据集创建
来源数据
- 科学文本: S2ORC
- 新闻文章和推文: 通过Altmetric收集
- 语言生产者: 科学家、记者和Twitter用户
许可信息
- 许可: MIT