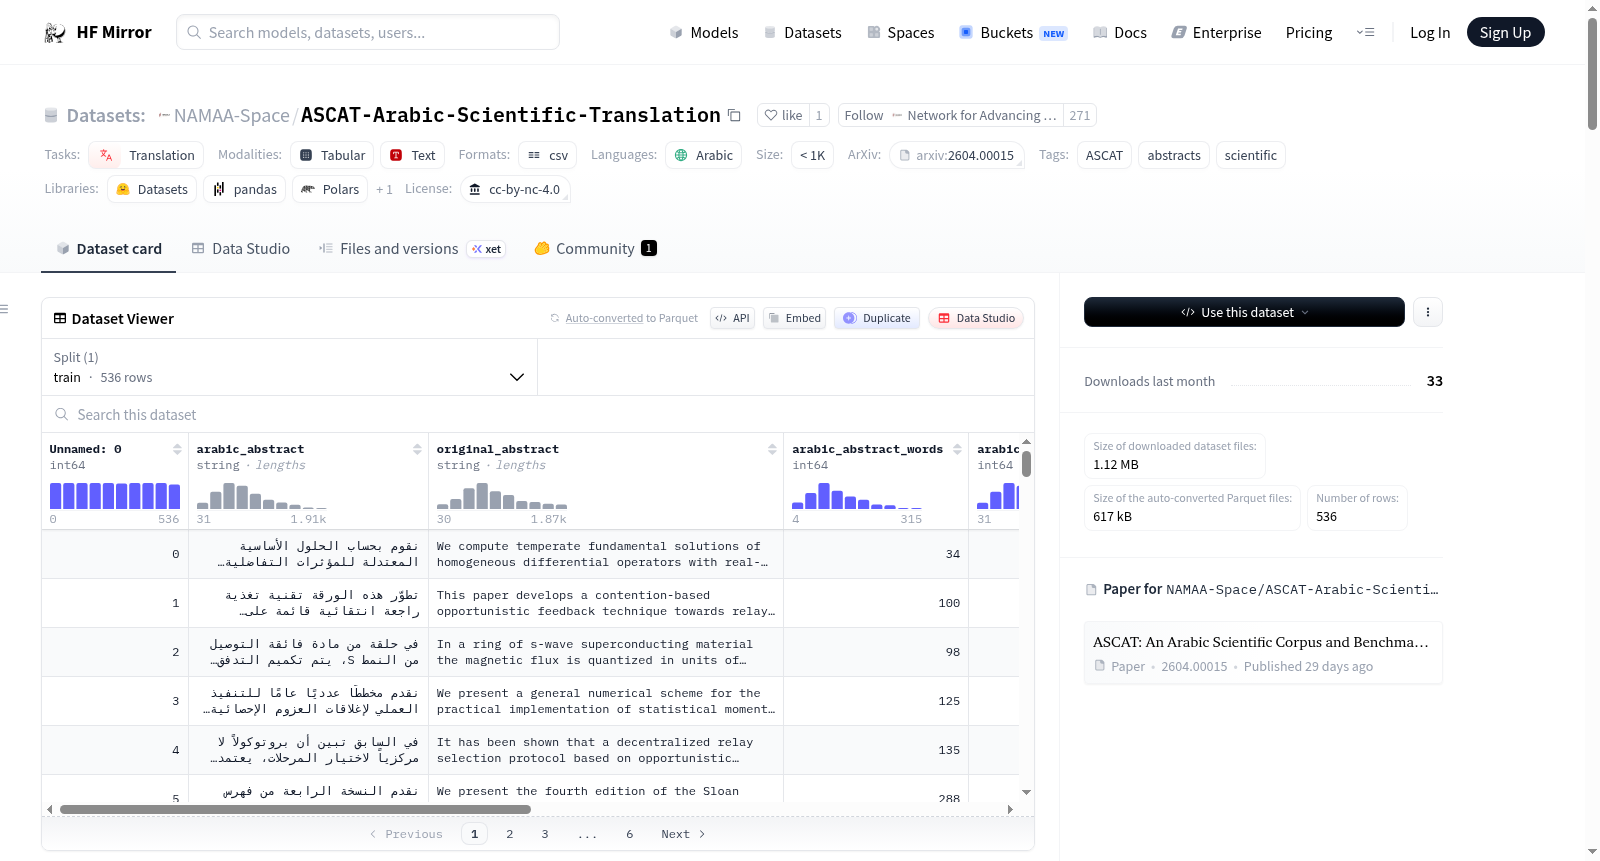
NAMAA-Space/ASCAT-Arabic-Scientific-Translation
收藏资源简介:
--- license: cc-by-nc-4.0 language: - ar task_categories: - translation tags: - ASCAT - abstracts - scientific pretty_name: ASCAT size_categories: - n<1K --- # ASCAT: Arabic Scientific Corpus for Advanced Translation <p align="center"> <img src="https://cdn-uploads.huggingface.co/production/uploads/628f7a71dd993507cfcbe587/0eIWZQK81isXnTUUG3pt3.png" width="700"/> </p> **ASCAT** (Arabic Scientific Corpus for Advanced Translation) is a high-quality English–Arabic parallel corpus of full scientific abstracts designed for rigorous evaluation and training of domain-specific machine translation (MT) systems. - Unlike existing Arabic–English corpora that rely on short sentences or narrow domains, **ASCAT** targets long-form scientific abstracts validated through a multi-engine translation and expert review pipeline. # Dataset Summary - **Language Pair:** English → Arabic - **Domains:** Physics, Mathematics, Computer Science, Quantum Mechanics, Artificial Intelligence - **Size:** 500 full scientific abstracts - **Total English Tokens:** 67,293 - **Total Arabic Tokens:** 60,026 - **Arabic Vocabulary Size:** 17,604 unique words - **Validation:** Multi-stage expert validation **ASCAT** is designed as: - A discriminative evaluation benchmark for scientific MT - A high-quality corpus for domain-specific MT fine-tuning - A research resource for long-form Arabic scientific translation ## Languages - `en` – English (source) - `ar` – Arabic (human-validated reference) - ## Dataset Structure Each example contains: ```json { "id": "ASCAT_001", "domain": "mathematics", "source_english": "...", "target_arabic": "...", "word_count_en": 128, "word_count_ar": 115 } ``` ## Domain Distribution <p align="center"> <img src="https://cdn-uploads.huggingface.co/production/uploads/628f7a71dd993507cfcbe587/-EzZhm2uCjYA1jQdLiEWI.png" width="700"/> </p> ## Data Collection Scientific abstracts were randomly sampled from peer-reviewed papers across five scientific disciplines to ensure domain diversity and minimize selection bias. All samples are full-length abstracts (not sentence fragments), averaging: - **English:** 125.3 words - **Arabic:** 111.8 words ## Human Validation Criteria Each abstract was validated at three linguistic levels: | Level | Criterion | |-----------|------------------------------------------| | Lexical | Domain terminology accuracy | | Lexical | Named entity preservation | | Syntactic | Grammatical correctness (Arabic) | | Syntactic | Sentence structure fidelity | | Semantic | Epistemic hedging preservation | Disagreements were resolved through consensus discussion. ## Corpus Statistics ### Sentence Length | Language | Mean Words | Median | Max | |----------|------------|--------|-----| | English | 125.3 | 113 | 297 | | Arabic | 111.8 | 100 | 315 | ### Vocabulary Statistics | Language | Tokens | Unique Words | Type-Token Ratio | |----------|--------|--------------|------------------| | English | 67,293 | 12,685 | 0.19 | | Arabic | 60,026 | 17,604 | 0.29 | Arabic exhibits higher lexical diversity due to morphological richness. ## Benchmark Evaluation ASCAT was used to evaluate three large language models: <p align="center"> <img src="https://cdn-uploads.huggingface.co/production/uploads/628f7a71dd993507cfcbe587/4ijlrFa3xZe12NoOgqsTT.png" width="700"/> </p> The performance gap of up to **13.4** BLEU points demonstrates ASCAT’s discriminative power as a benchmark for long-form scientific translation. ## Intended Uses ### Recommended - Scientific MT benchmarking - Domain-adapted MT fine-tuning - Long-form Arabic translation evaluation - Terminology consistency research - Discourse-level translation studies ### Not Intended For - General-domain conversational MT - Sentence-level short translation tasks - Classical Arabic text modeling ## Limitations - Moderate size (500 abstracts) - Slight domain imbalance (mathematics dominant) - Evaluation primarily automatic (BLEU/ROUGE) - No multiple Arabic reference translations per abstract ## Citation If you use ASCAT, please cite: ```bibtex @article{ASCAT2026, title={ASCAT: An Arabic Scientific Corpus and Benchmark for Advanced Translation Evaluation}, author={Sibaee, Serry and Al Jallad, Khloud and Yousfi, Zineb and Elhosiny, Israa and El-Ghawi, Yousra and Balah, Batool and Nacar, Omer}, year={2026}, url={https://arxiv.org/pdf/2604.00015} } ```
license: cc-by-nc-4.0 language: - ar task_categories: - translation tags: - ASCAT - 摘要 - 科学领域 pretty_name: ASCAT size_categories: - n<1K # ASCAT:高级翻译用阿拉伯语科学语料库(Arabic Scientific Corpus for Advanced Translation) <p align="center"> <img src="https://cdn-uploads.huggingface.co/production/uploads/628f7a71dd993507cfcbe587/0eIWZQK81isXnTUUG3pt3.png" width="700"/> </p> **ASCAT(高级翻译用阿拉伯语科学语料库)是一套高质量的英阿平行语料库,包含完整的科学摘要,专为领域专属机器翻译(MT, Machine Translation)系统的严格评估与训练设计。** - 与现有的依赖短句或窄领域的阿英语料库不同,**ASCAT** 针对的是经过多引擎翻译与专家审核流程验证的长格式科学摘要。 ## 数据集概览 - **语言对:** 英语 → 阿拉伯语 - **覆盖领域:** 物理学、数学、计算机科学、量子力学、人工智能 - **规模:** 500篇完整科学摘要 - **英语总Token数:** 67,293 - **阿拉伯语总Token数:** 60,026 - **阿拉伯语词汇量:** 17,604个独特单词 - **验证方式:** 多阶段专家验证 **ASCAT 的定位为:** - 科学机器翻译的判别式评估基准 - 用于领域专属机器翻译微调的高质量语料库 - 长格式阿拉伯语科学翻译的研究资源 ## 语言说明 - `en` – 英语(源语言) - `ar` – 阿拉伯语(经人工验证的参考译文) ## 数据集结构 每个数据样本包含以下字段: json { "id": "ASCAT_001", "domain": "mathematics", "source_english": "...", "target_arabic": "...", "word_count_en": 128, "word_count_ar": 115 } ## 领域分布 <p align="center"> <img src="https://cdn-uploads.huggingface.co/production/uploads/628f7a71dd993507cfcbe587/-EzZhm2uCjYA1jQdLiEWI.png" width="700"/> </p> ## 数据采集流程 科学摘要从五个科学学科的同行评议论文中随机采样,以确保领域多样性并最小化选择偏差。 所有样本均为完整长度的摘要(而非句子片段),平均篇幅为: - **英语:** 125.3个单词 - **阿拉伯语:** 111.8个单词 ## 人工验证标准 每篇摘要需在三个语言层面接受验证: | 验证层级 | 验证准则 | |---------|----------------------------------------| | 词汇层 | 领域术语准确性 | | 词汇层 | 命名实体保留度 | | 句法层 | (阿拉伯语)语法正确性 | | 句法层 | 句子结构保真度 | | 语义层 | 认知模糊限制语(epistemic hedging)保留度 | 分歧通过协商讨论解决。 ## 语料库统计数据 ### 句子长度 | 语言 | 平均单词数 | 中位数 | 最大值 | |--------|------------|--------|--------| | 英语 | 125.3 | 113 | 297 | | 阿拉伯语 | 111.8 | 100 | 315 | ### 词汇统计 | 语言 | 总Token数 | 独特单词数 | 类符-形符比(Type-Token Ratio) | |--------|-----------|------------|--------------------------------| | 英语 | 67,293 | 12,685 | 0.19 | | 阿拉伯语 | 60,026 | 17,604 | 0.29 | 阿拉伯语因形态丰富性展现出更高的词汇多样性。 ## 基准评估 ASCAT 被用于评估三款大语言模型(Large Language Model, LLM): <p align="center"> <img src="https://cdn-uploads.huggingface.co/production/uploads/628f7a71dd993507cfcbe587/4ijlrFa3xZe12NoOgqsTT.png" width="700"/> </p> 最高可达**13.4**个BLEU分值的性能差距,印证了ASCAT作为长格式科学翻译基准的判别能力。 ## 预期用途 ### 推荐适用场景 - 科学机器翻译基准测试 - 领域适配型机器翻译微调 - 长格式阿拉伯语翻译评估 - 术语一致性研究 - 语篇级翻译研究 ### 不适用场景 - 通用领域对话式机器翻译 - 句子级短文本翻译任务 - 古典阿拉伯语文本建模 ## 局限性 - 规模适中(仅500篇摘要) - 存在轻微的领域失衡问题(数学领域占比偏高) - 评估主要依赖自动指标(BLEU/ROUGE) - 每篇摘要未配备多份阿拉伯语参考译文 ## 引用规范 若您使用ASCAT数据集,请引用以下文献: bibtex @article{ASCAT2026, title={ASCAT: An Arabic Scientific Corpus and Benchmark for Advanced Translation Evaluation}, author={Sibaee, Serry and Al Jallad, Khloud and Yousfi, Zineb and Elhosiny, Israa and El-Ghawi, Yousra and Balah, Batool and Nacar, Omer}, year={2026}, url={https://arxiv.org/pdf/2604.00015} }