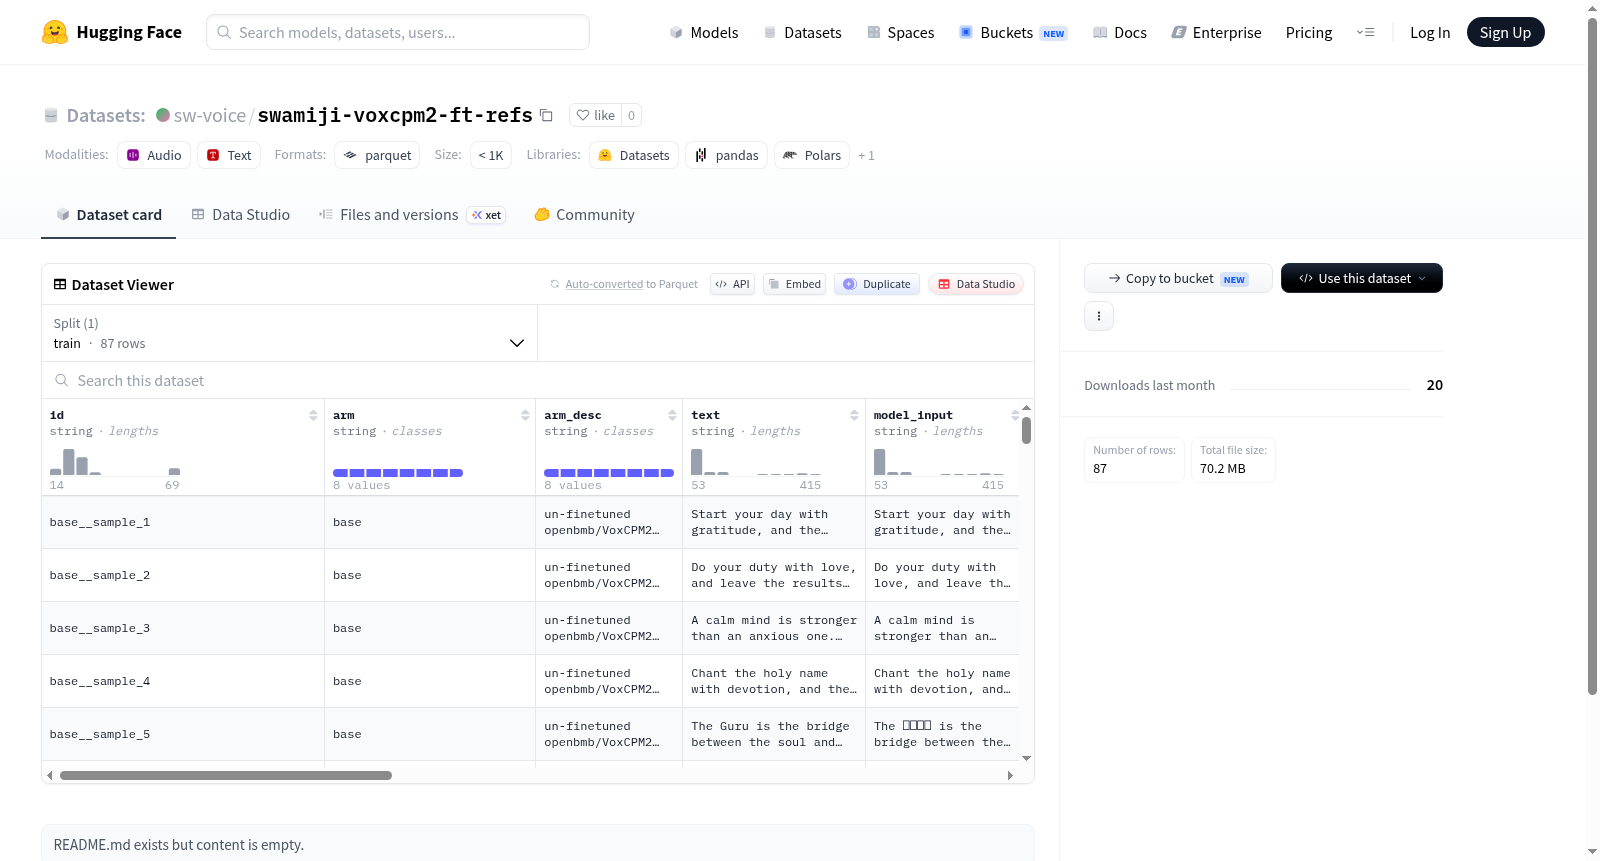
swamiji-voxcpm2-ft-refs
收藏资源简介:
该数据集是一个包含音频样本及其相关元数据的语音数据集。数据集由77个训练样本组成,总大小约54.9MB。每个样本包含15个特征字段:唯一标识符(id)、arm参数、arm描述(arm_desc)、文本内容(text)、模型输入(model_input)、源剪辑标识(source_clip)、无参考评估标志(reference_free)、音频数据(audio,采样率48000Hz)、音频时长(seconds)、采样率(sample_rate)、生成时长(gen_seconds)、语音结束时间(speech_end)、尾部静音时长(silence_tail)、有声部分比例(voiced_frac)、预期时长(expected_seconds)和提前截断标志(early_cut)。数据集提供了详细的音频处理和质量控制指标,适用于语音生成、音频质量评估、语音处理等相关任务。
This is a speech dataset encompassing audio samples and their associated metadata. The dataset comprises 77 training samples with a total size of approximately 54.9 MB. Each sample includes 15 feature fields: unique identifier (id), arm parameter, arm description (arm_desc), text content (text), model input (model_input), source clip identifier (source_clip), reference-free evaluation flag (reference_free), audio data (audio, with a sampling rate of 48000 Hz), audio duration (seconds), sampling rate (sample_rate), generation duration (gen_seconds), speech end time (speech_end), trailing silence duration (silence_tail), voiced segment ratio (voiced_frac), expected duration (expected_seconds), and early truncation flag (early_cut). The dataset offers detailed audio processing and quality control metrics, making it applicable to tasks including speech generation, audio quality assessment, and speech processing.
数据集概述:sw-voice/swamiji-voxcpm2-ft-refs
基本信息
- 数据集地址:https://huggingface.co/datasets/sw-voice/swamiji-voxcpm2-ft-refs
- 数据集大小:下载大小为 70,162,784 字节,数据集总大小为 86,752,305 字节。
- 数据划分:仅包含训练集(train),共 87 个样本。
数据特征(Features)
数据集包含以下字段:
| 字段名 | 数据类型 | 说明 |
|---|---|---|
id |
string | 样本标识符 |
arm |
string | 分支或条件标识 |
arm_desc |
string | 分支或条件描述 |
text |
string | 文本内容 |
model_input |
string | 模型输入文本 |
source_clip |
string | 源剪辑信息 |
reference_free |
bool | 是否无参考 |
audio |
audio | 音频数据,采样率为 48000 Hz |
seconds |
float64 | 音频时长(秒) |
sample_rate |
int64 | 原始采样率 |
gen_seconds |
float64 | 生成音频时长(秒) |
speech_end |
float64 | 语音结束时间(秒) |
silence_tail |
float64 | 尾部静音时长(秒) |
voiced_frac |
float64 | 有声片段占比 |
expected_seconds |
float64 | 预期时长(秒) |
early_cut |
bool | 是否提前截断 |
配置信息
- 配置名称:
default - 数据文件路径:
data/train-*(训练集所有文件)