
ShoukanLabs/OpenNiji-Dataset-Aesthetic-Finetune
收藏官方服务:
资源简介:
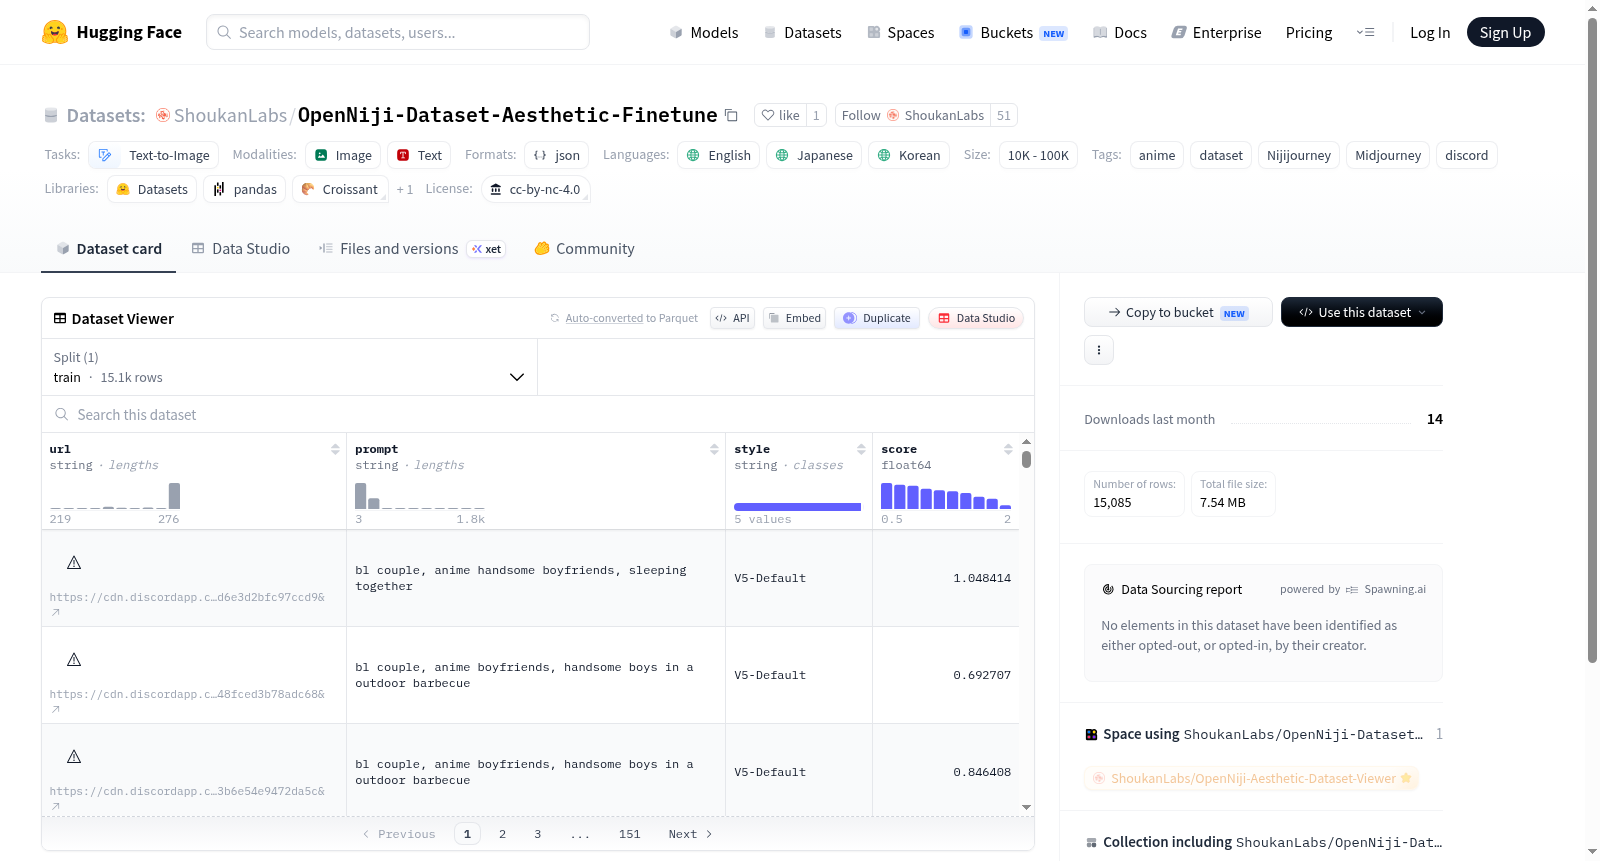
该数据集用于OpenNiji的质量调优,主要涉及文本到图像生成任务,支持英语、日语和韩语。数据集标签包括动漫、数据集、Nijijourney、Midjourney和discord,数据规模在10K到100K之间,使用cc-by-nc-4.0许可证。
This dataset is intended for quality tuning of OpenNiji, primarily focusing on text-to-image generation tasks, and supports English, Japanese and Korean. Its dataset tags include anime, dataset, Nijijourney, Midjourney and Discord. The data scale ranges from 10K to 100K, and it is licensed under CC-BY-NC-4.0.
提供机构:
ShoukanLabs原始信息汇总
数据集概述
任务类别
- 文本到图像
语言
- 英语
- 日语
- 韩语
标签
- 动漫
- 数据集
- Nijijourney
- Midjourney
- Discord
大小类别
- 10K<n<100K
许可证
- CC BY-NC 4.0
用途
- 用于OpenNiji的质量调优
搜集汇总
数据集介绍
构建方式
在动漫风格图像生成领域,高质量数据集对模型微调至关重要。ShoukanLabs/OpenNiji-Dataset-Aesthetic-Finetune 源自Discord平台上的Nijijourney与Midjourney创作社区,通过系统化采集和美学筛选构建而成。该数据集聚焦于文本到图像生成任务,涵盖英文、日文和韩文多语言提示词,并经过严格的美学质量评估,最终筛选出万级规模的样本集合,专用于OpenNiji模型的美学微调。
特点
该数据集的核心特点在于其精细的美学导向和跨语言覆盖。样本数量介于一万至十万之间,规模适中但质量精良,每一条数据均经过美学维度筛选,确保图像与文本描述在艺术风格和视觉吸引力上的高度一致性。多语言支持(英、日、韩)拓展了模型的跨文化适应能力,而源自Nijijourney与Midjourney的创作背景则赋予了数据集鲜明的动漫美学特征,为生成高质量动漫图像提供了坚实基础。
使用方法
使用方法上,该数据集专为文本到图像生成模型的美学微调而设计,尤其适配OpenNiji架构。研究者可直接将其作为训练集,结合标准的图像生成训练流程进行模型调优。数据集以HuggingFace标准格式存储,支持通过datasets库加载,便于集成到现有的PyTorch或TensorFlow工作流中。建议在微调时配合美学损失函数或质量评估指标,以充分发挥该数据集在视觉美感优化方面的潜力。
背景与挑战
背景概述
在生成式人工智能领域,文本到图像合成技术近年来取得了突破性进展,其中以Midjourney和Nijijourney为代表的模型在动漫风格图像生成中展现了卓越的艺术表现力。ShoukanLabs/OpenNiji-Dataset-Aesthetic-Finetune数据集由ShoukanLabs团队于近期创建,旨在通过美学微调优化OpenNiji模型的输出质量。该数据集聚焦于动漫图像生成任务,收录了数万条从Discord平台采集的英文、日文及韩文提示词与对应图像对,为提升生成图像的审美一致性提供了关键训练资源。作为OpenNiji开源生态的重要组成部分,该数据集填补了高质量动漫风格微调数据的空白,对推动社区驱动的二次元AI创作工具发展具有显著影响力。
当前挑战
当前数据集面临多重挑战:首先,动漫风格图像生成的核心难点在于捕捉不同画师流派与色彩美学的微妙差异,而现有数据对审美维度的标注尚不够精细化,难以全面覆盖复杂的美学特征。其次,构建过程中需从Discord海量对话中筛选符合Nijijourney输出标准的图像,面临数据噪声高、版权归属模糊及跨语言提示词语义对齐等技术障碍。此外,数据集规模仅介于1万至10万之间,在应对长尾风格或罕见角色生成时存在代表性不足的问题,可能限制模型在极端多样性场景下的泛化能力。
常用场景
经典使用场景
在文本到图像生成领域,OpenNiji-Dataset-Aesthetic-Finetune 数据集以其专为二次元风格图像生成而设计的特性,成为微调扩散模型以提升美学质量的关键资源。该数据集汇集了来自Nijijourney与Midjourney等流行生成平台的精选图像,通过人工筛选与标注,确保了图像的高审美标准与风格一致性。研究者常将其用于对预训练模型进行美学微调,旨在优化模型输出图像的视觉吸引力、构图平衡与色彩和谐,从而在动漫生成任务中达到更为精致与风格化的效果。
解决学术问题
该数据集有效解决了当前文本到图像生成模型中普遍存在的审美缺陷问题,即模型虽能生成内容准确的图像,但往往缺乏专业级别的视觉美感与艺术表现力。通过提供高质量、风格统一的训练样本,OpenNiji-Dataset-Aesthetic-Finetune 为学术研究开辟了一条提升生成图像美学品质的可行路径。它使得研究者能够系统性地探索美学特征对生成结果的影响,并验证了在特定风格领域(如二次元)进行精细化微调对模型性能的显著提升作用,推动了生成式AI在艺术创作领域的学术进展。
衍生相关工作
该数据集衍生了一系列经典工作,其中最为突出的是OpenNiji项目本身,它作为基于该数据集微调的开源文本到图像生成模型,展示了在特定美学风格上超越通用模型的潜力。后续研究进一步扩展了其思路,如引入美学评分模型进行数据筛选、结合用户偏好学习进行迭代优化,以及探索不同风格间的迁移学习。这些工作共同构建了一个以美学微调为核心的研究脉络,为动漫生成领域的模型定制化与风格控制提供了坚实的理论与实践基础。
以上内容由遇见数据集搜集并总结生成


