
遇见数据集

nenae18/life-advice-rag-dataset

收藏
Hugging Face2026-05-29 更新2026-05-31 收录
官方服务:

资源简介:

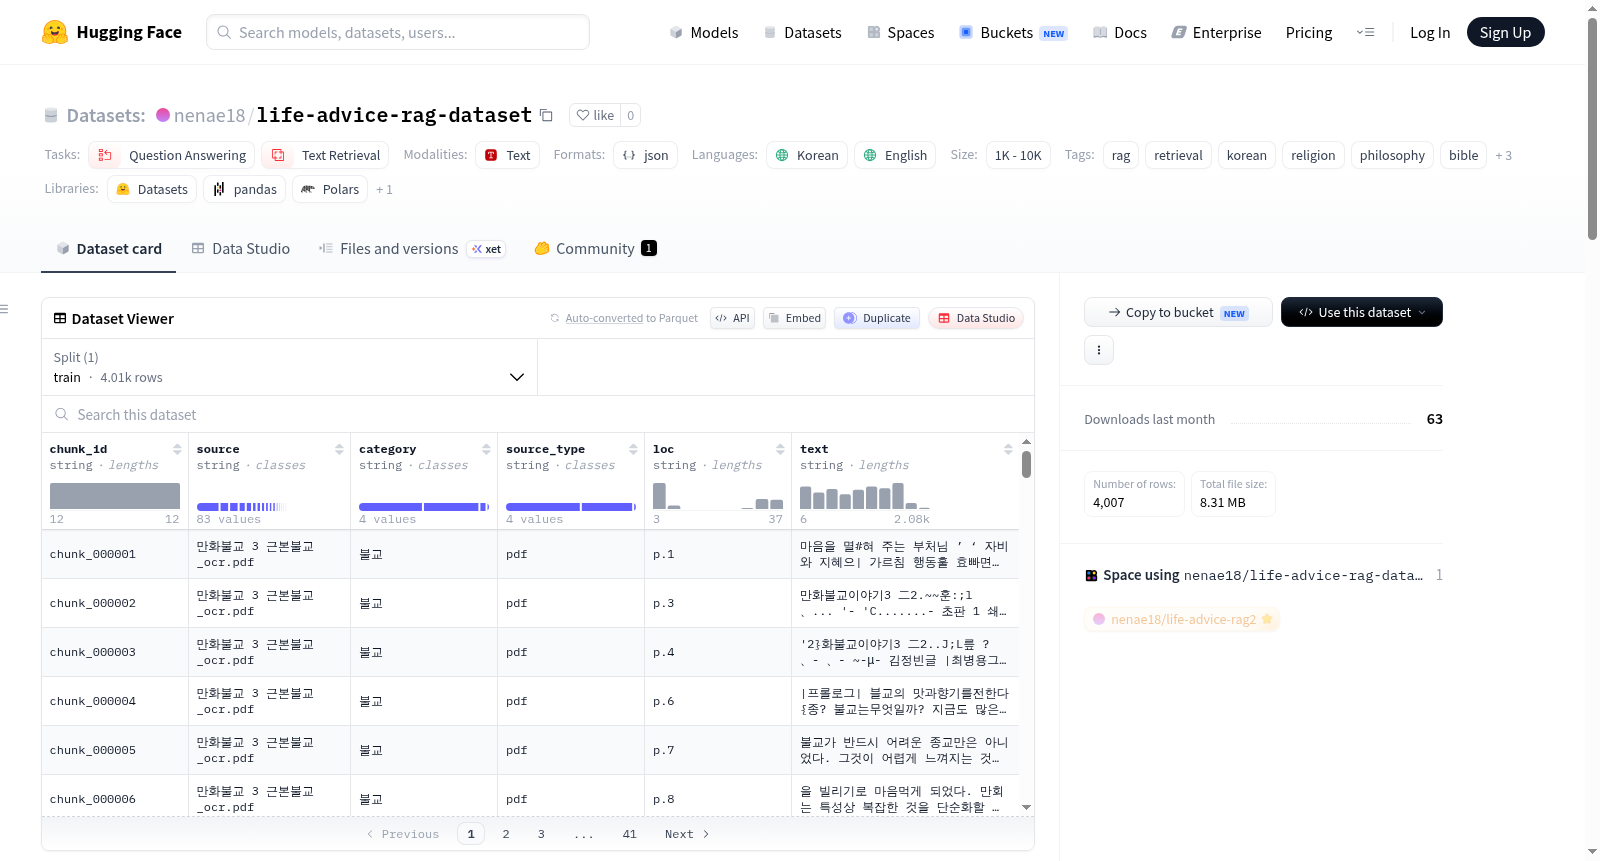
该数据集是一个用于RAG检索的chunk转换数据集,基于圣经、佛教经典/解说、论语和人文名言资料。它包含4,007个chunk,来自83个来源,总字符数为3,656,354,数据格式为JSONL。主要用途包括基于证据的人生建议RAG、宗教和哲学观点比较检索,以及演示用的问答。数据集文件包括chunks.jsonl(包含检索用的文本chunk)、dataset_manifest.json(数据集统计和来源列表)和sample_questions.json(演示用问题示例)。每个chunk包含chunk_id、source、category(如圣经/佛教/儒学·论语/名言/其他)、source_type(如pdf/txt/csv/zip)、loc(页码或位置)和text(用于检索的文本chunk)。数据集旨在回答如好妻子、好丈夫、困难应对、领导力、人际关系等人生建议问题,并支持结合BM25关键词检索和向量检索的RAG管道。使用注意事项强调需要确认原始资料的版权和许可,建议私有使用或限制共享。

This dataset is a chunk conversion dataset for RAG retrieval, based on materials including the Bible, Buddhist scriptures/commentaries, the Analects of Confucius, and humanistic quotes. It contains 4,007 chunks from 83 sources, with a total character count of 3,656,354, and is stored in JSONL format. Its main applications include evidence-based life advice RAG, comparative retrieval of religious and philosophical viewpoints, and demo-based question answering. The dataset files include chunks.jsonl (containing text chunks for retrieval), dataset_manifest.json (dataset statistics and source list), and sample_questions.json (demo question examples). Each chunk contains chunk_id, source, category (e.g., Bible/Buddhism/Confucianism·Analects/Quotes/Other), source_type (e.g., pdf/txt/csv/zip), loc (page number or location), and text (the text chunk for retrieval). This dataset is designed to answer life advice questions such as those about good wives, good husbands, coping with difficulties, leadership, interpersonal relationships, etc., and supports RAG pipelines combining BM25 keyword retrieval and vector retrieval. Usage notes emphasize the need to confirm the copyright and license of the original materials, and recommend private use or restricted sharing.

提供机构:
nenae18
搜集汇总
数据集介绍
nenae18/life-advice-rag-dataset 数据集图片
构建方式
该数据集聚焦于人生智慧问答场景,旨在为检索增强生成(RAG)系统提供高质量的知识支撑。构建过程中,研究人员从《圣经》、佛教经典与注释、《论语》以及人文哲学名言等多元文本中提取原始材料,经过系统的文本清洗与段落划分后,生成了4,007个语义完整的检索块。每个数据块均标注了来源、类别、文件格式及位置信息,最终以JSONL格式统一存储,形成结构清晰、便于检索的语料库。
使用方法
使用该数据集时,建议首先通过Hugging Face Datasets库加载chunks.jsonl文件,随后利用SentenceTransformer模型生成文本嵌入,并构建FAISS向量索引以实现高效近邻搜索。为提升检索效果,可融合BM25关键词检索与向量检索结果,形成混合检索管道。检索到的上下文信息将作为输入传递给生成模型,用于回答如“好妻子的标准”或“如何面对苦难”等人生议题。需注意,使用者应事先确认原始材料的版权许可,并在非公开环境中分享该数据集。
背景与挑战
背景概述
在检索增强生成(Retrieval-Augmented Generation, RAG)技术快速发展的背景下,如何构建高质量、多来源的语料库以满足特定领域如人生哲学问答的需求,成为研究热点。Life Advice RAG Dataset 由韩国研究机构或个人于近期创建,旨在系统整合圣经、佛教经典、论语及人文名言等多元文本资源,形成包含4007个检索单元的语料库。该数据集聚焦于跨宗教与哲学视角下的人生智慧检索与问答,通过标准化分块处理和向量化索引,为RAG模型的开发与评估提供了重要基准。其研究问题核心在于如何有效融合不同文化背景的经典文本,以支撑对诸如婚姻、苦难、领导力等普世议题的智能回答,对推动多源知识融合的RAG研究具有积极影响。
当前挑战
该数据集的核心挑战在于跨文本异构性的处理与检索精度的平衡。首先,来源于圣经、佛经、儒家经典等不同类型文献的文本在语言风格、篇章结构和术语体系上差异显著,传统单模板分块策略难以保证语义连贯性,导致检索上下文缺失或噪声引入。其次,构建过程中需克服版权与合规难题,原始PDF、TXT等格式的多源数据需经复杂预处理,如剔除重复内容、纠正OCR错误及统一编码格式,同时须确保每段文本归属清晰以规避侵权风险。此外,如何设计融合向量与关键词(BM25)的混合检索策略,以同时捕捉语义相似性与词汇匹配性,仍是提升问答准确性的关键优化方向。
常用场景
经典使用场景
在跨文化宗教与哲学研究领域,Life Advice RAG Dataset的诞生为多源智慧文本的检索增强生成提供了独特的数据基石。该数据集汇聚了圣经、佛教典籍、儒家论语以及人文名言共4007个文本块,涵盖83种来源,形成了跨越东西方思想体系的丰富语料库。其经典使用场景聚焦于基于证据的人生建议检索任务,研究者可将用户提出的关于婚姻、领导力、人际关系等现实困惑作为查询,通过结合语义向量检索与BM25关键词匹配的双重机制,精准定位不同宗教与哲学传统中的相关段落。这种设计不仅支持单一文化视角下的问答,更能实现多信仰体系观点的对比分析,为构建具备文化敏感性的对话系统奠定了数据基础。
解决学术问题
该数据集精准解决了计算社会科学与宗教哲学交叉领域中的两个核心学术难题:多源异质文本的语义对齐问题和跨信仰观点比较的实证匮乏。传统上,研究者难以在统一的框架内自动检索并对比圣经、佛经与儒家经典对同一人生问题的不同阐释,而此数据集通过标准化分块与元数据标注,使得量化分析各宗教传统对‘苦难’、‘美德’等核心概念的表达差异成为可能。其意义在于为弥合东西方哲学对话的鸿沟提供了可复现的计算工具,推动了‘比较文化信息学’这一新兴方向的发展,使学术研究从定性描述迈向量化理解,为理解人类普适价值在不同文明中的独特表达提供了实证支持。
实际应用
在实际应用层面,该数据集最直接的场景是赋能心理咨询与心灵关怀类的智能对话系统。例如,当用户倾诉‘面对困境时应如何调适’时,系统可依托该数据集同时检索圣经中关于信心的段落、佛教强调无常的教导以及论语中‘岁寒而知松柏之后凋’的坚韧智慧,生成融合多元文化底蕴的安慰性回复。此外,该数据集还可服务于跨文化教育平台,帮助学生直观比较不同宗教对同一伦理问题的解答,或者作为‘数字人文’研究中的测试基准,评估大语言模型在宗教哲学问答中的准确性与公平性,从而推动AI系统在敏感话题上的文化包容性。
数据集最近研究
最新研究方向
该数据集聚焦于将东西方宗教哲学经典(如圣经、佛教经论、儒家论语等)与人文格言系统性地转化为结构化检索增强生成(RAG)语料,服务于生命智慧与伦理困境的问答推理。前沿方向包括跨文化宗教思想的语义对齐检索、多源哲学观点的冲突与互补分析,以及基于向量与关键词混合检索的高效答案生成。随着大模型在心理辅导、道德决策支持等领域的应用深化,此类融合生命咨询与检索增强的语料库正成为提升模型解释性与文化敏感性的关键基础设施。同时,它在构建可演化的跨宗教智慧问答系统方面具有典范意义,推动了人机共生价值观研究的前沿探索。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

