dev_set_v2_a3_rl_DCAgent_mix_h2_language_proportional_65_8B_20260825_134032
收藏资源简介:
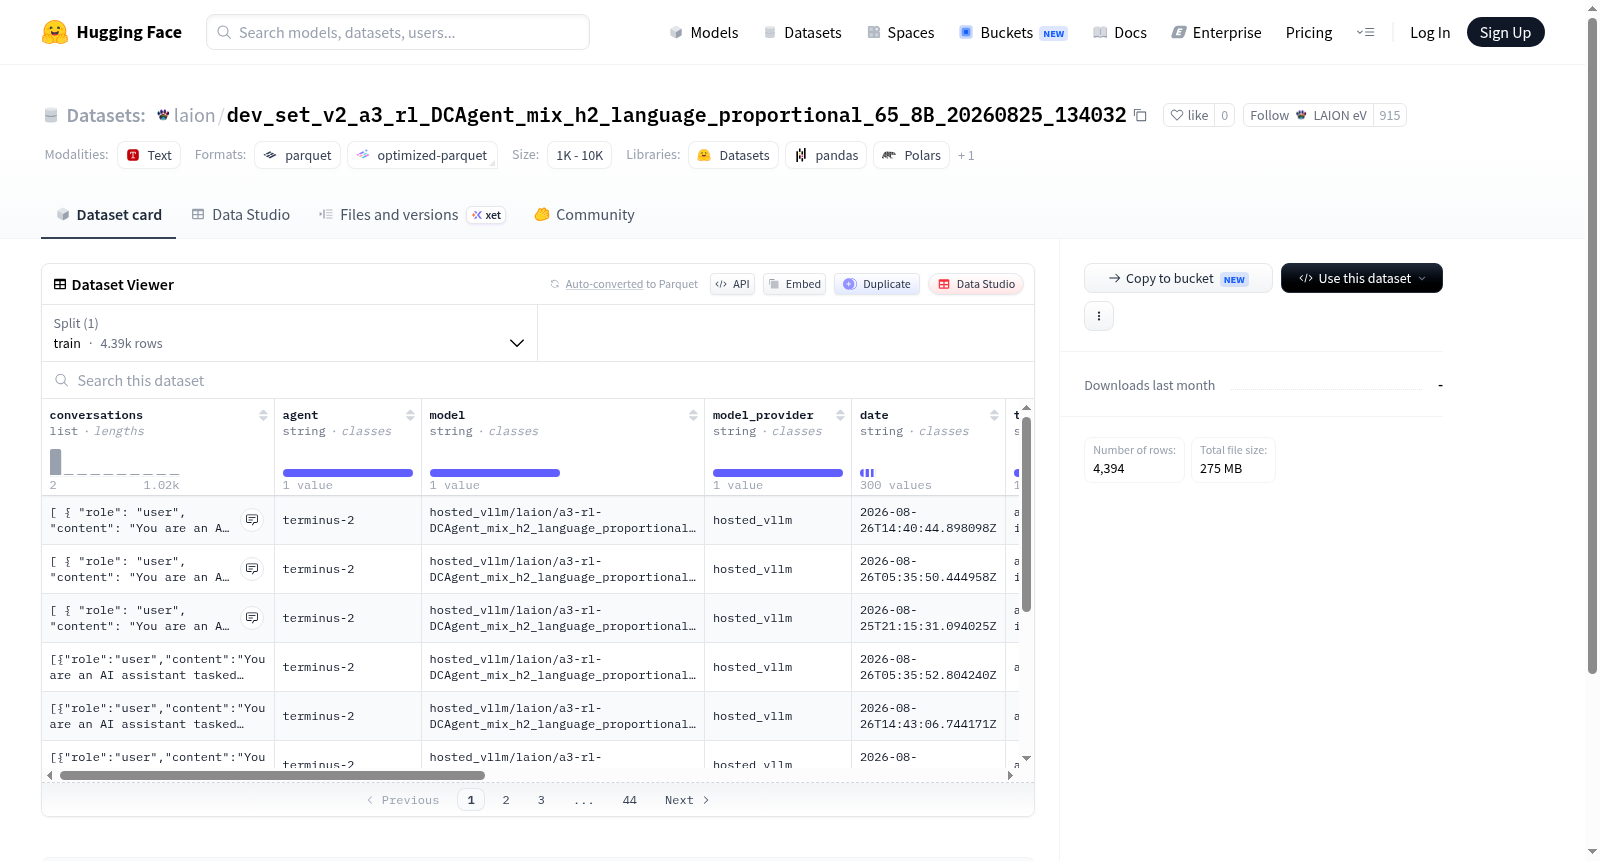
该数据集包含多轮对话记录,每一条样本包括一个对话列表(conversations),其中每条消息包含角色(role)和内容(content)。此外还记录了所使用的代理(agent)、模型(model)及模型提供商(model_provider)、日期(date)、任务(task)、轮次(episode)、运行ID(run_id)、试验名称(trial_name)、结果(result)、验证器输出(verifier_output)以及追踪来源(trace_source)。数据集共包含 4394 个训练样本,总大小约 308 MB,适用于对话系统训练、评估、任务型对话分析等场景。
This dataset contains multi-turn dialogue records. Each sample includes a conversation list (conversations) where each message contains a role (role) and content (content). Additionally, it records the agent used (agent), model (model) and model provider (model_provider), date (date), task (task), episode (episode), run ID (run_id), trial name (trial_name), result (result), verifier output (verifier_output), and trace source (trace_source). The dataset contains 4,394 training samples with a total size of approximately 308 MB, suitable for dialogue system training, evaluation, task-oriented dialogue analysis, and other scenarios.
数据集概述
该数据集名为 laion/dev_set_v2_a3_rl_DCAgent_mix_h2_language_proportional_65_8B_20260825_134032,托管于 Hugging Face 平台,由 LAION 组织发布。
基本信息
- 数据集规模:包含 4,394 个样本,总大小约 308.9 MB(下载大小约 275.5 MB)。
- 数据划分:仅包含一个训练集(
train),无验证集或测试集。 - 文件格式:数据以
data/train-*模式存储,具体格式需参考文件内容。
数据结构
每条数据包含以下字段:
| 字段名 | 类型 | 说明 |
|---|---|---|
conversations |
列表 | 对话记录,每条记录包含 role(角色)和 content(内容)两个子字段,均为字符串。 |
agent |
字符串 | 代理标识。 |
model |
字符串 | 使用的模型名称。 |
model_provider |
字符串 | 模型提供方。 |
date |
字符串 | 日期信息。 |
task |
字符串 | 任务类型。 |
episode |
字符串 | 回合或场景编号。 |
run_id |
字符串 | 运行标识。 |
trial_name |
字符串 | 试验名称。 |
result |
字符串 | 结果信息。 |
verifier_output |
字符串 | 验证器输出。 |
trace_source |
字符串 | 追踪来源。 |
内容特征
- 对话数据:核心部分是
conversations字段,包含角色与内容的配对,适用于对话系统或强化学习相关任务。 - 辅助元数据:包含模型、代理、任务、运行记录等丰富的元信息,可能用于分析模型行为、评估结果或追踪实验过程。
用途推测
根据名称中的 rl(强化学习)、DCAgent(对话代理)、mix(混合)及 h2_language_proportional(语言比例混合)等关键词,该数据集可能是用于强化学习环境下对话代理的训练或评估数据,强调语言任务的比例混合。具体任务类型需结合 task 字段或实际数据内容进一步确认。