
遇见数据集

muhammadmahad666/hr-policies-qa-dataset

收藏
Hugging Face2026-05-30 更新2026-05-31 收录
官方服务:

资源简介:

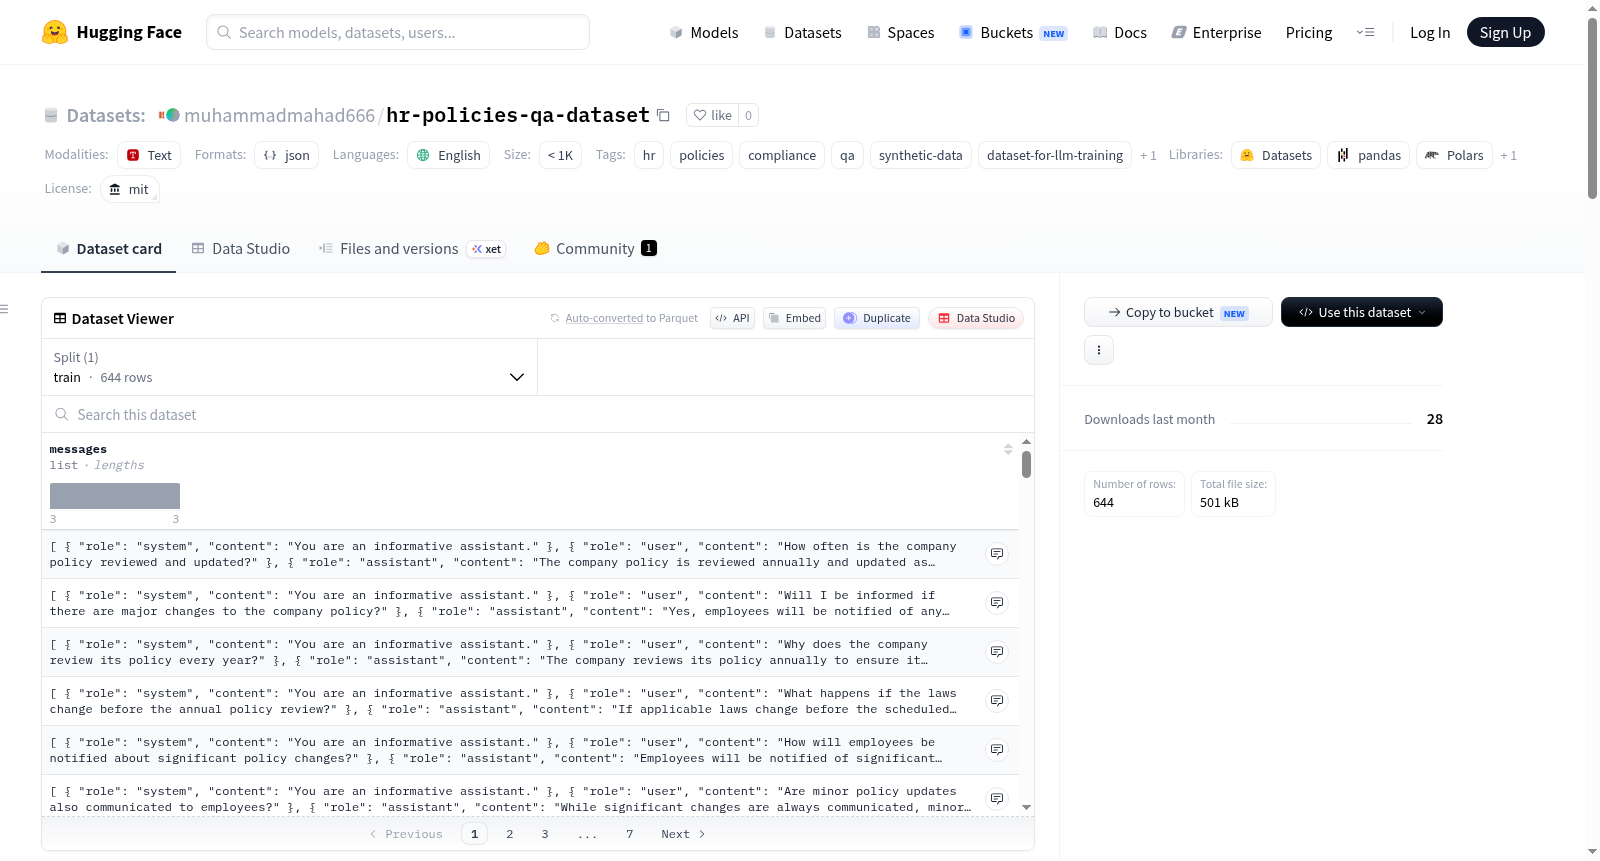
该数据集提供关于人力资源(HR)政策和合规性的多轮问答对话,格式包含系统、用户和助手角色。它设计用于大型语言模型(LLM)微调、HR和合规聊天机器人以及企业政策自动化。通过涵盖真实世界的HR场景,如政策审查、合规流程和员工沟通,该数据集有助于训练能够澄清公司政策、确保员工沟通一致性、减少HR团队工作量并支持合规和治理计划的助手。数据集领域为HR政策和合规沟通,格式为JSON(多轮对话),适用于HR聊天机器人训练、政策和合规助手以及员工支持自动化,属于LLM训练免费数据集类别。

This dataset provides multi-turn question-answering dialogues focused on human resources (HR) policies and compliance, with conversation roles including system, user, and assistant. It is designed for large language model (LLM) fine-tuning, HR and compliance chatbots, and enterprise policy automation. Covering real-world HR scenarios such as policy review, compliance procedures, and employee communications, this dataset aids in training assistants capable of clarifying company policies, ensuring consistency in employee communications, reducing the workload of HR teams, and supporting compliance and governance initiatives. The dataset falls under the domain of HR policy and compliance communications, is formatted as JSON (multi-turn dialogues), and is suitable for HR chatbot training, policy and compliance assistant development, and employee support automation. It belongs to the category of free datasets for LLM training.

提供机构:
muhammadmahad666
搜集汇总
数据集介绍
muhammadmahad666/hr-policies-qa-dataset 数据集图片
构建方式
该数据集通过结合真实世界中人力资源政策与合规领域的多轮问答场景构建而成。数据以JSON格式组织,每条样本包含system、user和assistant三个角色对话,覆盖政策审查、合规流程、员工沟通等典型事务。利用Syncora.ai的合成数据生成管线进行增强,在确保隐私安全的前提下,去除敏感细节,输出结构化的高质量对话内容,以满足企业级大语言模型训练对数据多样性和准确性的要求。
特点
该数据集专为人力资源政策问答领域设计,具有高度的领域针对性和实用性。其最大特点在于提供了多轮对话格式,模拟了员工与HR助理之间的真实交互,涵盖假期规则、合规义务、政策更新等高频重复性问题。数据经过隐私脱敏处理,适用于企业环境,能够有效辅助HR团队减轻工作负担,同时提升员工体验和合规管理效率。
使用方法
数据集以JSON格式提供,可直接用于大语言模型的监督微调。使用时,可将system角色设定为信息丰富的助手,user角色输入员工的政策咨询内容,assistant角色输出标准化的HR回复。开发者可通过HuggingFace页面直接下载数据集,并配合附带的Jupyter Notebook进行数据处理和模型训练,也可利用Syncora.ai的合成数据工具生成定制化扩展数据。
背景与挑战
背景概述
在大型语言模型(LLM)快速发展的背景下,企业智能化转型对垂直领域数据集的需求日益增长。由Syncora团队于2024年创建的hr-policies-qa-dataset,聚焦于人力资源政策与合规管理这一关键领域,核心研究问题是构建能够准确回答多轮HR政策咨询的对话系统。该数据集通过合成数据生成技术,覆盖政策解读、合规流程及员工沟通等真实场景,填补了企业级HR聊天机器人训练数据匮乏的空白。其影响力体现在降低HR团队重复性工作负荷、提升员工体验及保障企业合规治理等方面,为LLM在企业环境中的实用化部署提供了重要支撑,已成为开源社区中HR领域对话数据集的代表性资源。
当前挑战
该数据集面临的核心挑战在于领域问题的复杂性与数据生成的可靠性。在HR政策咨询场景中,问题往往涉及多部门协同、法律条款变更及组织特异性规则,且需要结合隐私保护原则,这要求模型在缺乏大规模真实对话样本的情况下,依然能对模糊或冲突的政策表述做出准确推断。构建过程中,团队需借助合成数据生成技术模拟多轮对话,但如何确保合成样本的语义连贯性、覆盖长尾合规场景(如跨境劳动法差异),同时过滤与行业标准不符的内容,成为数据质量控制的重中之重。此外,面对企业动态更新的政策库,数据集还需解决时效性维护与冷启动问题,以避免模型产生过期或误导性回答。
常用场景
经典使用场景
该数据集专为人力资源(HR)领域的智能对话系统而设计,其核心价值在于模拟员工与HR部门之间的真实多轮交互场景。通过包含政策解读、合规流程咨询、员工沟通等典型HR情境,该数据集为大语言模型(LLM)的指令微调提供了高质量的对话样本。研究者可将此数据集用于训练能够准确解答考勤规则、休假政策、反贿赂与反腐败合规等常见问题的HR聊天机器人,从而构建具备专业性和一致性回答能力的智能助手。
实际应用
在实际企业环境中,该数据集可赋能部署于内部知识库或OA系统的政策自动化助手。员工可通过自然语言查询绩效评估流程、差旅报销细则或员工行为准则,系统即时给出标准化且符合最新法规的答复。这大幅削减了HR部门处理高频简易问询的人力成本,同时确保信息传达的统一性。此外,该数据集还适用于入职培训中的模拟问答场景以及合规审计前的自助自查环节,为企业人力资源管理的数字化转型提供了坚实的数据支撑。
衍生相关工作
基于HR政策问答数据集,业界已衍生出多项基于检索增强生成(RAG)与对话式微调的相关工作。例如,研究者利用该数据集构建了融合企业自定义政策库的RAG-HR系统,实现了对非标问题的动态检索与回答生成。亦有工作在此基础上进行多轮对话的状态追踪研究,以处理跨话题的政策追问。此外,该数据集还启发了面向合规异常检测的对话分析模型,通过对比历史问答模式辅助识别政策理解偏差,进一步拓展了该数据集在企业智能治理领域的影响力。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

