
遇见数据集

QuixiAI/QuixiMath-1B

收藏
Hugging Face2026-07-07 更新2026-07-21 收录
官方服务:

资源简介:

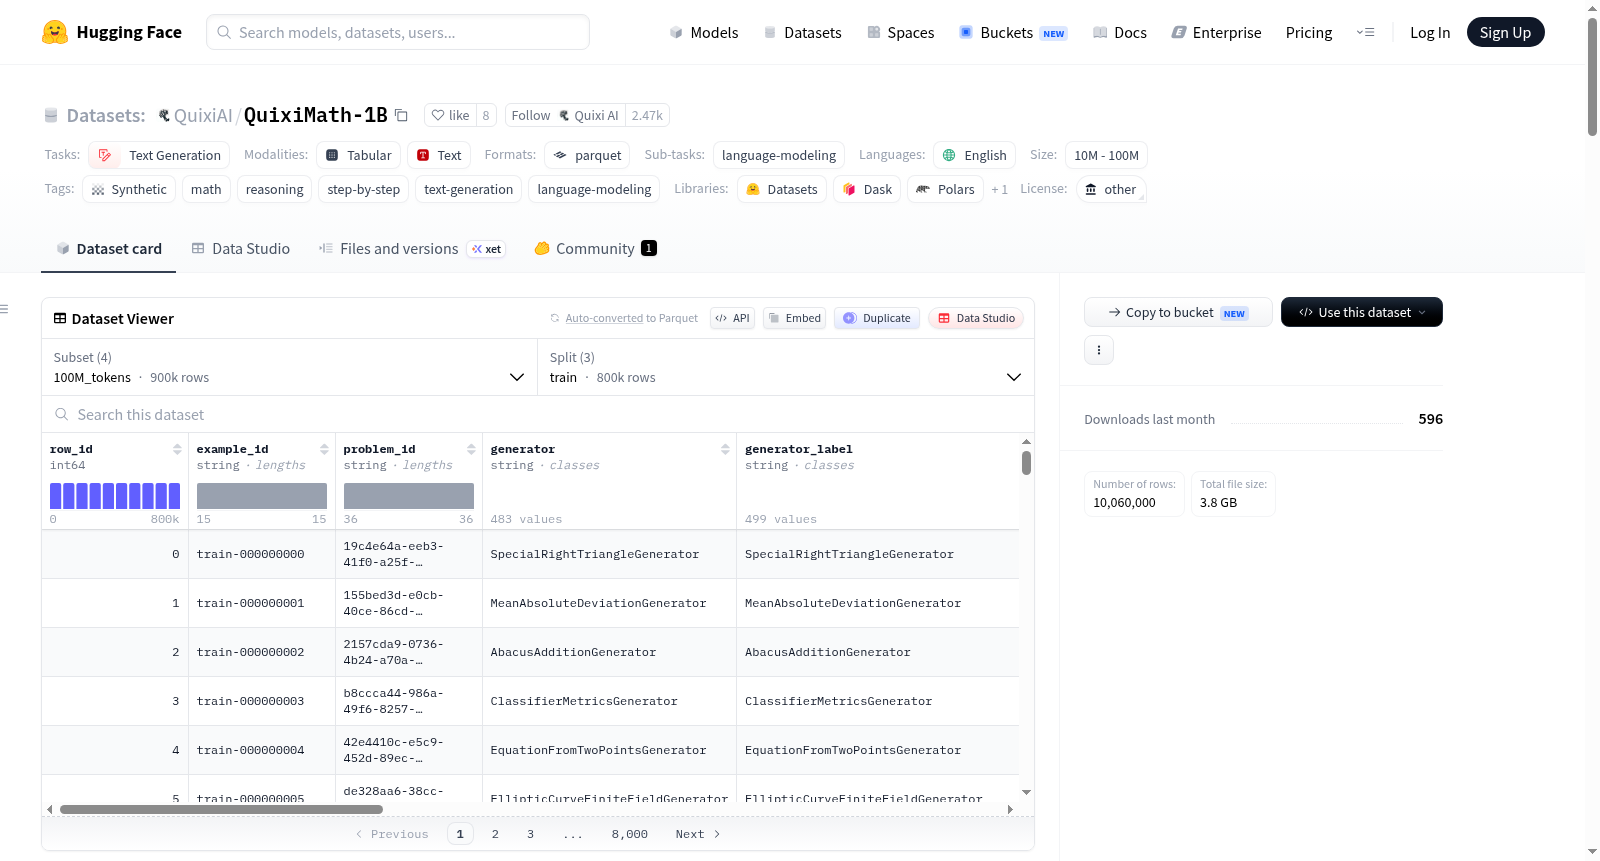
QuixiMath-1B是一个由QuixiMath程序化问题生成器生成的合成数学推理语料库。每条记录包含一个自然语言问题、显式的逐步草稿操作码、规范最终答案以及用于按技能、操作、年级段和相对难度进行过滤或重新加权的元数据。该规范语料库以覆盖率为先,而不是规定性分层:训练者可以使用包含的元数据列选择自己的采样组合。大小配置是每个分割内的嵌套前缀子集。

QuixiMath-1B is a synthetic mathematical reasoning corpus generated by the QuixiMath procedural problem generator. Each record contains a natural language question, explicit step-by-step draft operation codes, a standardized final answer, and metadata for filtering or reweighting across dimensions of skill, operation, grade level, and relative difficulty. This standardized corpus prioritizes coverage over prescriptive stratification: model trainers can use the included metadata columns to customize their own sampling combinations. The size configuration consists of nested prefix subsets within each dataset split.
提供机构:
QuixiAI
搜集汇总
数据集介绍
QuixiAI/QuixiMath-1B 数据集图片
构建方式
QuixiMath-1B是一个由Eric Hartford与QuixiAI联合开发的合成数学推理语料库,其数据通过程序化问题生成器系统化产出。每个样本包含自然语言描述的问题、显式的逐步思维链操作码、规范化的最终答案,以及用于过滤或重加权的元数据字段,涵盖技能类型、运算类别、年级段和相对难度等级。语料库采用覆盖优先而非严格分层的策略构建,允许训练者依据元数据列自主选择采样混合比例。数据集以嵌套前缀子集形式组织,提供了从预览版到十亿token级别的多种配置,并遵循统一的分割体系。
特点
该数据集覆盖从小学到研究生五个年级段,包含509种默认抽样技能与525个生成器实例,难度评分从1至5不等。数据规模宏大,最大配置涵盖约900万行、近11.3亿文本token。运算类型极其丰富,从基础算术、统计量计算到高等数学如留数定理、克雷默法则,乃至机器学习中的KNN分类与反向传播ReLU步骤,横跨数学与计算科学的广泛领域。每一条记录均携带稳定标识符与生成器来源信息,便于溯源和定制化采样。
使用方法
用户可通过HuggingFace Datasets库轻松加载该数据集,例如使用`load_dataset("QuixiAI/QuixiMath-1B", "100M_tokens")`即可获取指定配置。数据集预定义了text字段,直接可供文本生成任务使用,支持训练、验证和测试分割。基于元数据中的grade_level、difficulty、operation等列,研究者能够灵活筛选子集或进行难度分层抽样,适用于语言模型在数学推理能力上的预训练、微调与评测等场景。
背景与挑战
背景概述
QuixiMath-1B是由Eric Hartford与QuixiAI联合打造的大规模合成数学推理语料库,发布于2026年7月。该数据集旨在为语言模型提供覆盖广泛数学技能的逐步推理训练素材,核心研究问题在于如何通过程序化生成高质量、结构化的数学问题及其解答过程,以提升模型的逻辑推理能力。数据集包含超过900万条记录,涵盖从小学到研究生阶段的多个难度层级,涉及算术、线性代数、概率统计、优化算法等500余种运算类型,其规模与多样性在数学推理领域具有显著影响力,为后续研究提供了坚实的基准与资源。
当前挑战
该数据集面临的核心挑战在于所解决的领域问题:数学推理需要模型掌握精确的符号操作与多步逻辑链条,而现有语言模型常因计算错误或推理断裂导致结果偏差,QuixiMath-1B通过引入显式的逐步计算流程以缓解此问题。构建过程中,挑战主要包括:设计覆盖广泛概念且无重复的程序化问题生成器需大量领域专业知识;确保生成问题在不同年级与难度间的分布均衡而非简单预设分层;以及在大规模生成时高效剔除完全相同的(操作, 问题)对,维护数据的多样性与独特性。
常用场景
经典使用场景
QuixiMath-1B作为一个大规模合成数学推理语料库,其最经典的使用场景在于为语言模型提供系统化的数学推理训练数据。该数据集涵盖了从初等运算到高等数学的广泛知识点,包含超过500种技能标签和500余个程序化问题生成器,使得模型能够在多层次难度分布(从基础到研究生水平)下学习逐步推理过程。研究者通常利用其内置的元数据字段(如操作类型、年级等级和难度系数)进行灵活采样,构建针对性的训练混合策略,从而有效提升模型在数学问题求解和链式推理方面的能力。这一设计理念使得QuixiMath-1B成为预训练和微调过程中不可或缺的推理增强资源。
衍生相关工作
自QuixiMath-1B发布以来,学界已涌现出多项受其启发的经典衍生研究。部分工作聚焦于利用该数据集的元数据设计课程学习算法,通过按难度递增的方式训练模型,显著提升了数学推理任务的收敛速度与最终性能。另一些研究则基于QuixiMath-1B的多样化操作标签,探索多任务学习框架下的推理能力迁移,验证了不同数学领域间逻辑技能的相互促进效应。此外,有学者借助其程序化生成器的底层逻辑,开发了自动化数据增强管道,进一步扩展了合成数学数据的覆盖范围,并在此基础上提出了新的评测基准用于衡量模型在零样本推理场景下的表现。这些工作共同推动了数学推理数据合成与模型训练方法论的系统性进步。
数据集最近研究
最新研究方向
QuixiMath-1B作为大规模合成数学推理语料库,其前沿研究方向聚焦于利用程序化问题生成器构建覆盖从小学到研究生级别的多粒度数学推理数据集,通过显式逐步思维链(scratchpad opcodes)和丰富的元数据(如技能、操作、难度等级)支持灵活的采样组合,旨在解决当前数学推理模型中训练数据多样性不足与知识覆盖有限的核心瓶颈。该数据集与近期大型语言模型在复杂数学解题、自动化逻辑推导及教育技术领域的热点事件紧密关联,例如OpenAI的o1系列和DeepSeek-R1对链式推理的强调,使其成为验证模型泛化能力、跨年级知识迁移以及细粒度推理路径可解释性的关键基准。其影响在于通过覆盖509种技能和525个生成器实例,首次为训练者提供了可自定义权重的分层采样框架,有望推动从基础算术到高等微积分、线性代数乃至神经网络反向传播等前沿主题的推理能力跃升,对通用人工智能在科学计算与教育辅助中的落地具有深远意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

