
遇见数据集

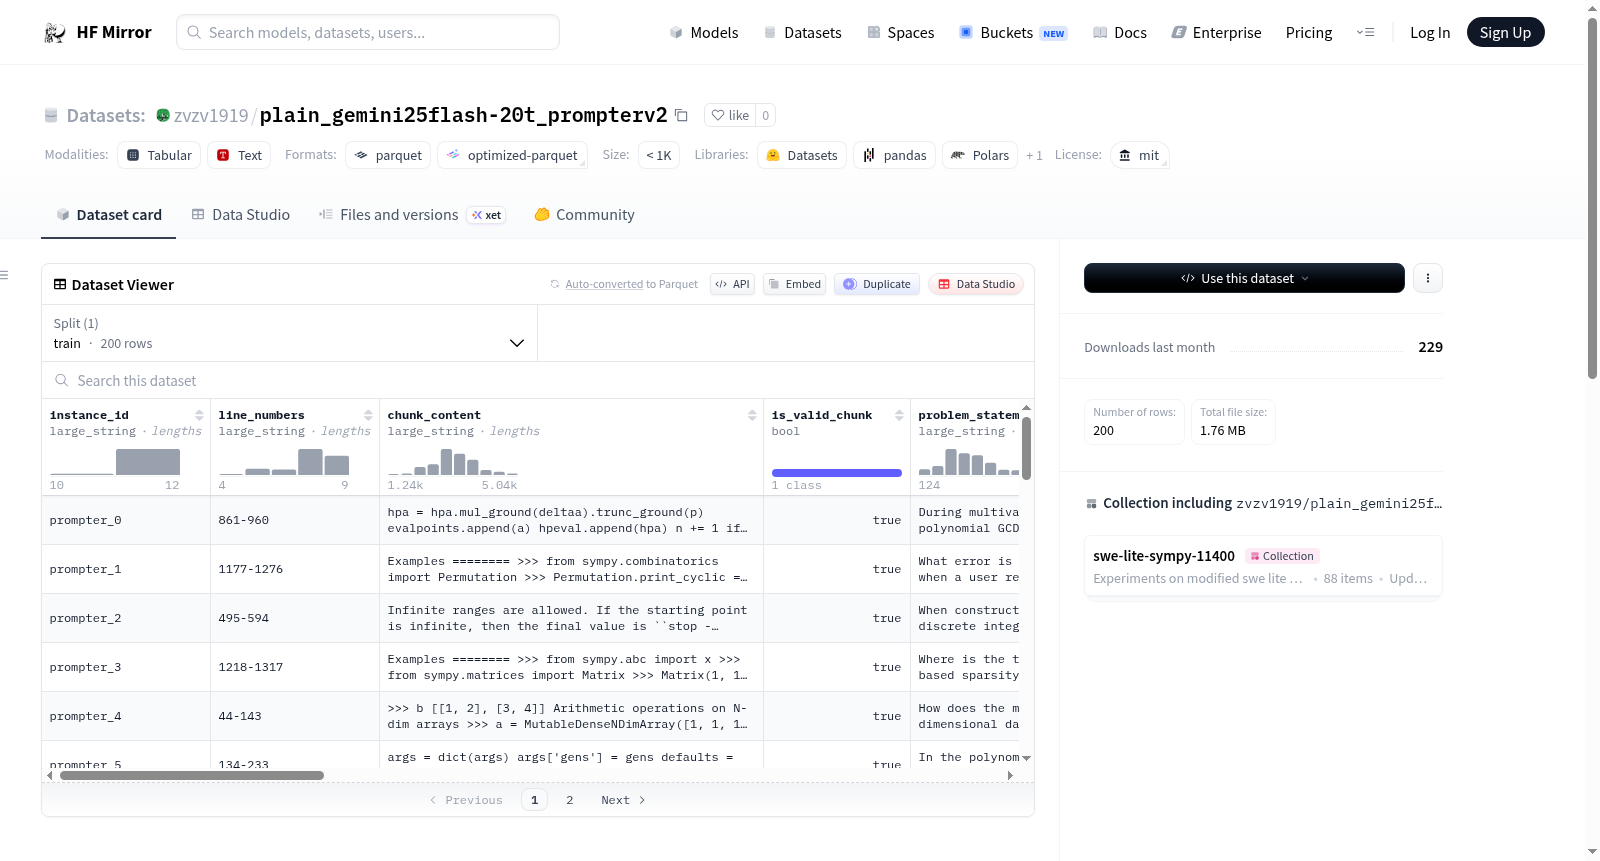
zvzv1919/plain_gemini25flash-20t_prompterv2

收藏
Hugging Face2026-04-10 更新2026-04-12 收录
官方服务:

资源简介:

--- license: mit --- # plain_gemini25flash-20t_prompterv2 ## Summary | Metric | Value | | --- | --- | | Total instances | 200 | | File matches | 126 (63%) | | Function matches | 64 (32%) | | File mismatches | 74 | | No result | 0 | | Avg turns | 3.5 | ## Config ```yaml agent_func: locate agent_module: agents.locator.plain bench_name: plain_gemini25flash-20t_prompterv2 collection: zvzv1919/swe-lite-sympy-11400-69d146b3787b38cf81b3a888 dataset: zvzv1919/prompter_v2 limit: 200 max_turns: 20 max_workers: 30 model: gemini-2.5-flash offset: 0 repo_path: sympy__sympy-11400/sympy repo_path_prefix: /Users/xuan.zhao/Documents/GitHub-zv/ shuffle: false split: train ```

--- 许可证:MIT --- # plain_gemini25flash-20t_prompterv2 ## 摘要 | 评估指标 | 数值 | | --- | --- | | 总样本数 | 200 | | 文件匹配数 | 126 (63%) | | 函数匹配数 | 64 (32%) | | 文件不匹配数 | 74 | | 无结果数 | 0 | | 平均交互轮次 | 3.5 | ## 配置 yaml agent_func: locate agent_module: agents.locator.plain bench_name: plain_gemini25flash-20t_prompterv2 collection: zvzv1919/swe-lite-sympy-11400-69d146b3787b38cf81b3a888 dataset: zvzv1919/prompter_v2 limit: 200 max_turns: 20 max_workers: 30 model: gemini-2.5-flash offset: 0 repo_path: sympy__sympy-11400/sympy repo_path_prefix: /Users/xuan.zhao/Documents/GitHub-zv/ shuffle: false split: train
提供机构:
zvzv1919
搜集汇总
数据集介绍
zvzv1919/plain_gemini25flash-20t_prompterv2 数据集图片
构建方式
在软件工程与代码理解领域,plain_gemini25flash-20t_prompterv2数据集通过自动化代理框架构建而成。该框架以SymPy数学库的特定版本作为基准代码库,采用定位代理对代码库中的函数与文件进行系统化检索与匹配。构建过程严格限定了交互轮次与工作线程数量,确保了数据生成的高效性与可控性,最终从大规模原始集合中采样出200条结构化的对话实例。
特点
该数据集的核心特征体现在其精确的代码定位能力评估上。数据实例包含文件匹配与函数匹配两种关键指标,分别占据了63%与32%的比例,反映了代理在不同粒度代码元素上的识别效能。平均对话轮次为3.5,表明多数查询能在有限的交互内完成定位,这为研究智能体在复杂代码库中的导航与理解效率提供了量化依据。
使用方法
研究人员可利用该数据集评估代码智能体或大语言模型在代码检索任务上的性能。典型的使用方法是将数据集作为基准测试集,输入给待评估的智能体系统,通过对比其输出的文件或函数定位结果与数据集中标注的匹配情况,计算准确率等指标。这有助于深入分析模型在理解代码上下文、处理模糊查询以及遍历大型代码仓库方面的实际能力。
背景与挑战
背景概述
在软件工程与人工智能交叉领域,自动化代码理解与定位任务日益成为研究热点。plain_gemini25flash-20t_prompterv2数据集由研究人员或团队zvzv1919构建,其核心研究问题聚焦于评估大型语言模型在代码库中精准定位特定功能或文件的能力。该数据集基于SymPy数学库的特定版本,通过设计多轮对话交互,旨在检验模型在复杂代码语境下的推理与检索性能,为智能编程助手与自动化软件维护工具的发展提供了关键的评估基准。
当前挑战
该数据集旨在解决代码定位这一软件工程核心任务的挑战,其难点在于模型需理解自然语言查询与代码语义之间的复杂映射,并在大规模、结构化的代码库中进行精确检索。构建过程中的挑战则体现在对话轨迹的设计与标注上,需要确保多轮交互的逻辑连贯性与任务真实性,同时平衡文件匹配与函数匹配等不同粒度目标的评估,以全面反映模型的综合能力。
常用场景
经典使用场景
在软件工程与代码智能领域,plain_gemini25flash-20t_prompterv2数据集为代码定位与理解任务提供了关键支持。该数据集专注于评估智能体在复杂代码库中精准定位目标函数或文件的能力,其平均对话轮次达到3.5,模拟了真实开发环境中多轮交互的调试场景。通过包含文件匹配与函数匹配的详细指标,它成为训练和验证代码导航模型的核心资源,尤其适用于增强大型语言模型在符号计算库等专业领域的代码推理性能。
实际应用
在实际开发流程中,plain_gemini25flash-20t_prompterv2数据集能够赋能智能编程助手与集成开发环境,提升开发者在庞大代码项目中的导航效率。基于该数据集训练的模型可应用于代码搜索、缺陷定位、文档生成等场景,帮助工程师快速理解SymPy等复杂库的结构与功能。这不仅缩短了代码维护与重构的时间成本,也为企业级开发工具提供了核心的智能支持,推动了软件工程自动化的实践落地。
衍生相关工作
围绕该数据集衍生的经典工作主要集中在代码定位智能体的架构优化与评估框架构建上。研究者利用其对话轨迹开发了基于强化学习的交互式定位模型,提升了多轮检索的准确性;同时,该数据集也催生了针对代码匹配任务的细粒度评估指标,如文件与函数匹配率的分离分析。这些工作进一步拓展至代码补全、测试生成等相邻领域,形成了以交互式代码智能为核心的系列研究脉络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

