kk-tokenizer-fertility-baseline
收藏资源简介:
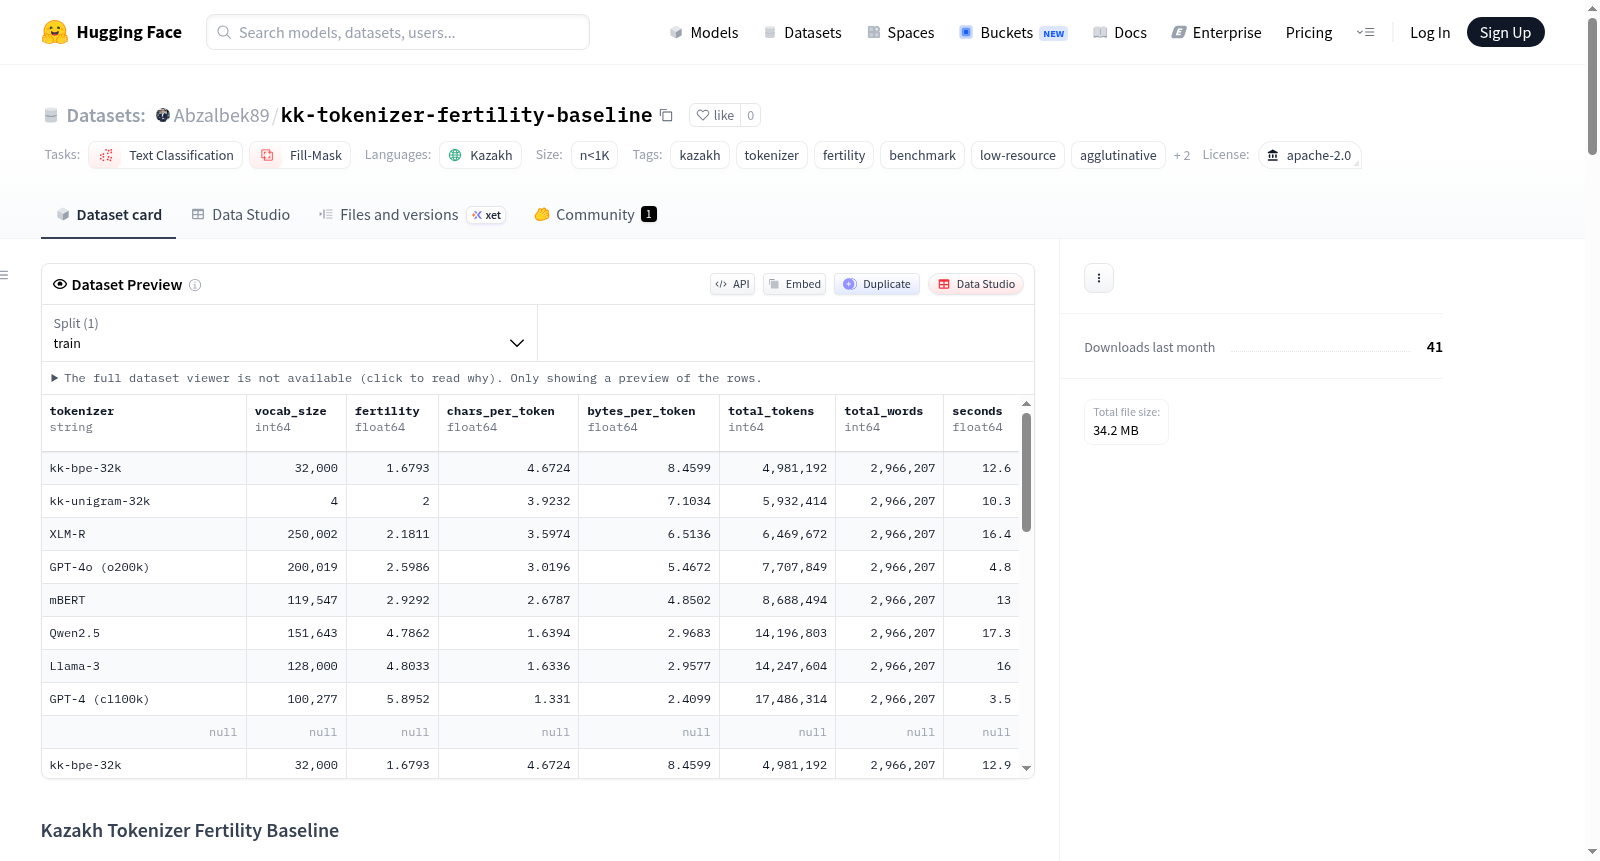
该数据集名为哈萨克语分词器效率基准,旨在为哈萨克语的分词器提供可复现的效率基准测试。数据集作为论文《Tokenizer Optimization for Kazakh Small Language Models》(待发表,目标期刊:ACM TALLIP)的配套成果,主要用于评估不同子词分词器在哈萨克语上的效率表现。数据集包含13种分词器的详细性能比较,包括哈萨克语定制训练的BPE/Unigram分词器、形态学感知分词器以及多语言/工业级分词器(如mBERT、XLM-R、GPT-4等)。评估基于一个包含2,966,207个空白分隔词(约15K文档)的验证集,主要指标包括分词效率(Fertility,即总token数/总词数,越低越好)和压缩率(字符数/token,越高越好)。最佳哈萨克语定制分词器(kk-bpe-32k)的效率比GPT-4高3.51倍,可显著降低API成本并扩展有效上下文窗口。数据集还包含完整的实验复现指南、配套分词器仓库链接以及Apache 2.0许可证信息。
This dataset, titled *Kazakh Tokenizer Efficiency Benchmark*, is designed to deliver reproducible efficiency benchmark evaluations for Kazakh-language tokenizers. As supporting work for the forthcoming paper *Tokenizer Optimization for Kazakh Small Language Models* (target journal: ACM TALLIP), this dataset is primarily used to evaluate the efficiency performance of different subword tokenizers on the Kazakh language. The dataset includes detailed performance comparisons across 13 tokenizers, namely Kazakh-customized BPE/Unigram tokenizers, morphology-aware tokenizers, as well as multilingual/industrial-grade tokenizers such as mBERT, XLM-R, GPT-4, and others. The evaluation is based on a validation set containing 2,966,207 whitespace-separated words (approximately 15K documents). The primary metrics include tokenization efficiency (Fertility, defined as total token count / total word count, where a lower value is better) and compression ratio (character count / token count, where a higher value is better). The optimal Kazakh-customized tokenizer (kk-bpe-32k) achieves 3.51-fold higher efficiency than GPT-4, which can significantly reduce API costs and expand the effective context window. The dataset also provides complete experimental reproduction guidelines, accompanying tokenizer repository links, and Apache 2.0 license information.
Kazakh Tokenizer Fertility Baseline 数据集概述
基本信息
- 语言: 哈萨克语 (kk)
- 许可证: Apache 2.0
- 任务类别: 文本分类、掩码填充
- 数据集规模: n < 1K
- 标签: 哈萨克语、分词器、生育率、基准测试、低资源语言、粘着语、形态感知、自然语言处理
数据集核心内容
该数据集是哈萨克语子词分词器的可复现生育率(Fertility)基准测试,为论文《Tokenizer Optimization for Kazakh Small Language Models》(筹备中,目标期刊:ACM TALLIP)提供配套实验数据。
关键指标排名
最佳与最差结果
| 排名 | 分词器 | 生育率 (Fertility) |
|---|---|---|
| 🥇 最佳 | kk-bpe-32k |
1.679 |
| 🚨 最差 | GPT-4 (cl100k) |
5.895 |
| GPT-4 惩罚 | GPT-4 (cl100k) 比最佳哈萨克语训练分词器效率低 3.51 倍 |
13 个分词器完整排名
自有——哈萨克语训练,无形态预分割
| 分词器 | 词表大小 | 生育率 ↓ | 字符/词元 ↑ |
|---|---|---|---|
kk-bpe-32k |
32,000 | 1.679 | 4.672 |
kk-sp-bpe-32k |
32,000 | 1.758 | 4.463 |
kk-sp-unigram-32k |
32,000 | 1.762 | 4.454 |
kk-hf-unigram-32k |
32,000 | 2.026 | 3.872 |
自有——哈萨克语训练,形态感知(Morfessor → 分词器)
| 分词器 | 词表大小 | 生育率 ↓ | 字符/词元 ↑ |
|---|---|---|---|
kk-morph-hf-bpe-32k |
32,000 | 1.761 | 4.456 |
kk-morph-sp-unigram-32k |
32,000 | 1.945 | 4.034 |
kk-morph-hf-unigram-32k |
32,000 | 2.346 | 3.345 |
参考——多语言/工业分词器
| 分词器 | 词表大小 | 生育率 ↓ | 字符/词元 ↑ |
|---|---|---|---|
XLM-R |
250,002 | 2.181 | 3.597 |
GPT-4o (o200k) |
200,019 | 2.599 | 3.020 |
mBERT |
119,547 | 2.929 | 2.679 |
Qwen2.5 |
151,643 | 4.786 | 1.639 |
Llama-3 |
128,000 | 4.803 | 1.634 |
GPT-4 (cl100k) |
100,277 | 5.895 | 1.331 |
方法论
评估数据集
- 留出评估集: 2,966,207 个空白分隔词(约 15K 文档),来自
Abzalbek89/corpus_clean的验证集。
评估指标
- 生育率 (Fertility) = 总词元数 / 总空白分隔词数(越低越好)
- 压缩率 (字符/词元) = 总字符数 / 总词元数(越高越好)
- 压缩率 (字节/词元) = 总 UTF-8 字节数 / 总词元数(越高越好)
训练的分词器(词表大小 32,000,共享相同训练语料)
kk-bpe-32k— HF tokenizers ByteLevel BPEkk-sp-bpe-32k— SentencePiece BPE(character_coverage=1.0,NFKC)kk-sp-unigram-32k— SentencePiece Unigramkk-hf-unigram-32k— HF tokenizers Unigram + ByteLevel 预分词kk-morph-hf-bpe-32k— 在 Morfessor 分割语料上训练的 HF BPEkk-morph-hf-unigram-32k— 在 Morfessor 分割语料上训练的 HF Unigramkk-morph-sp-unigram-32k— 在 Morfessor 分割语料上训练的 SentencePiece Unigram
参考分词器
mBERT、XLM-R、Llama-3、Qwen 2.5、GPT-4(cl100k_base)、GPT-4o(o200k_base)
文件结构
| 路径 | 描述 |
|---|---|
experiment.py |
版本 1——单一 Unigram 基线 |
experiment_v2.py |
版本 2——扩展(跨库 BPE/Unigram) |
experiment_v3_fix.py |
版本 2 修复——通过原始 SentencePieceProcessor 重新测量 SentencePiece 分词器 |
experiment_morph.py |
实验 2——形态感知变体 |
morfessor.bin |
训练好的 Morfessor 分割模型(前 100 万哈萨克语词汇) |
v2/fertility_v2.csv、.json、.png |
版本 2 固定数据 |
v3/fertility_v3.csv、.json、.png |
版本 3 扩展数据(含形态感知) |
v3/RESULTS_V3.md |
可读版本 3 报告 |
复现方法
要求环境:≥30GB 磁盘、≥16GB RAM。安装依赖后运行 experiment_morph.py,总运行时间约 30 分钟(缓存 Morfessor 模型)至 70 分钟(冷启动)。
关联分词器仓库
Abzalbek89/kk-tokenizer-bpe-32kAbzalbek89/kk-tokenizer-sp-bpe-32kAbzalbek89/kk-tokenizer-sp-unigram-32kAbzalbek89/kk-tokenizer-hf-unigram-32kAbzalbek89/kk-tokenizer-morph-hf-bpe-32kAbzalbek89/kk-tokenizer-morph-hf-unigram-32kAbzalbek89/kk-tokenizer-morph-sp-unigram-32k
引用信息
bibtex @misc{kk_tokenizer_fertility_2026, title = {Kazakh Tokenizer Fertility Baseline}, author = {Abzalbek Ulasbek}, year = {2026}, howpublished = {url{https://huggingface.co/datasets/Abzalbek89/kk-tokenizer-fertility-baseline}}, }