
ipfs_romania_laws
收藏官方服务:
资源简介:
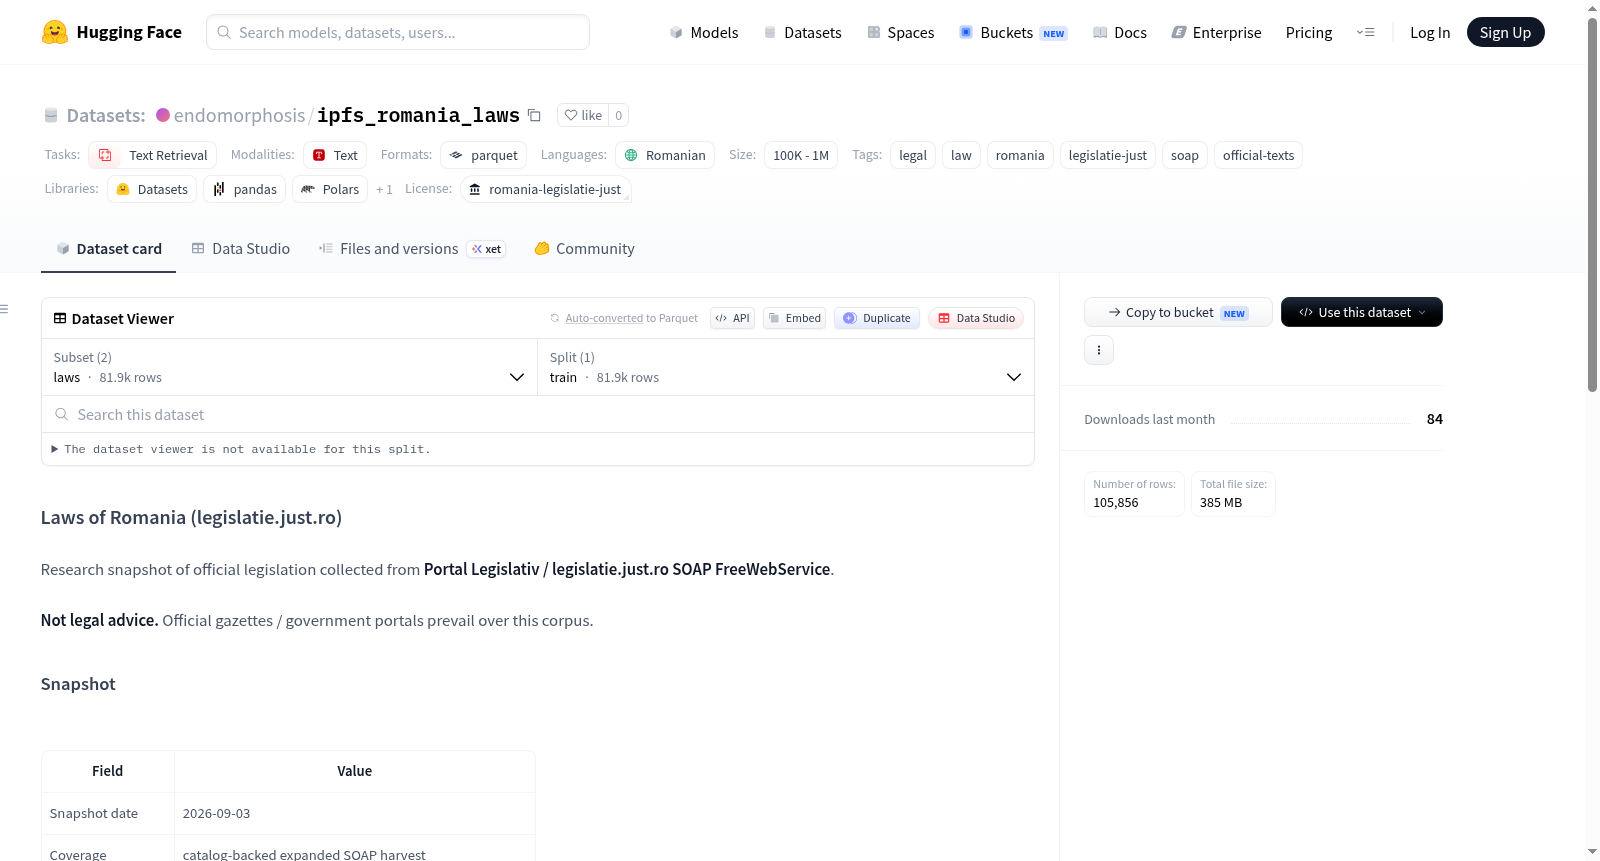
该数据集是罗马尼亚官方立法文本的研究快照,数据来源于Portal Legislativ / legislatie.just.ro的SOAP FreeWebService。数据集包含两个部分:法律(laws)和条款(articles)。法律部分包含81,872条法律/文件,每条记录包括ID、标题、全文、ELI标识、日期、状态、其他标识符、条款数量和来源URL;条款部分包含23,984条条款/章节,记录包括法律ID、条款编号、标题、文本和来源URL。数据集语言为罗马尼亚语,管辖范围为罗马尼亚。该数据集适用于文本检索、法律自然语言处理等研究任务,但请注意,这不是官方整合版本,不构成法律建议,官方来源(政府公报/政府门户)应优先于本数据集。
创建时间:
2026-09-04
原始信息汇总
数据集概述
罗马尼亚法律数据集(Laws of Romania) 是一个从 Portal Legislativ / legislatie.just.ro 官方门户网站收集的法律文本研究快照,数据采集时间为 2026年9月3日,覆盖范围基于目录索引并进行了扩展的 SOAP 接口抓取。
基本信息
| 属性 | 内容 |
|---|---|
| 语言 | 罗马尼亚语(ro) |
| 司法辖区 | 罗马尼亚 |
| 任务类型 | 文本检索(text-retrieval) |
| 数据规模 | 10K–100K 条记录 |
| 许可证 | romania-legislatie-just(其他) |
数据内容
数据集提供两个独立的 Parquet 配置:
- laws(法律文件):位于
data/laws.parquet,共 81,872 条记录,每个法律/文书一行,包含字段:ID、标题、全文、ELI(欧洲立法标识符)、日期、状态、识别符、条款数量、来源 URL。 - articles(条款):位于
data/articles.parquet,共 23,984 条记录,每个条款/章节一行,包含字段:法律 ID、条款编号、标题、文本、来源 URL。
文件结构
data/laws.parquet— 法律文书主数据文件data/articles.parquet— 条款级数据文件scrapers/collect_ro.py— 用于构建此快照的研究采集脚本scrapers/common.py— 共享采集辅助工具
重要声明
- 本数据集并非官方合订本,仅用于研究目的,不构成法律建议。
- 官方公报或政府门户网站的内容优先于本数据集。
- 官方文本的复用需遵循来源门户的公共部门条款;本数据集的封装、元数据和采集脚本仅限研究用途。
搜集汇总
数据集介绍
构建方式
该数据集依托罗马尼亚司法部官方立法门户 legislatie.just.ro 所提供的 SOAP FreeWebService 接口,借助研究型采集脚本 scrapers/collect_ro.py 与通用辅助模块 scrapers/common.py,对具有目录索引支撑的法规条目实施扩展式抓取。采集过程以官方 SOAP 服务为唯一数据源,逐条获取法规文书及其下属条款,并将所得结果分别固化为 laws.parquet 与 articles.parquet 两份结构化文件,最终形成截至 2026 年 9 月 3 日、涵盖 81872 部法规文书与 23984 条条款的研究快照。
特点
数据集聚焦罗马尼亚成文立法领域,全文以罗马尼亚语书写,规模处于万级至十万级区间,兼具法规层级与条款层级双重视角。laws.parquet 中每一行对应一部独立法律文书,包含标识符、标题、全文、欧洲立法标识符、日期、效力状态、来源链接及条款计数等字段;articles.parquet 则以条款为粒度,记录所属法规、条款编号、标题与正文。两份文件均保留可追溯的来源 URL,便于核验与引用,整体体现官方文本的原始性与可审计性。
使用方法
研究者可通过 HuggingFace datasets 库加载 laws 或 articles 配置,分别获取法规层与条款层的表格数据;亦可根据 law_id 将两表关联,实现从整部法律到具体条款的细粒度检索与文本分析。该数据适用于法律文本检索、条款级信息抽取、立法计量及语言资源构建等任务。需注意,该快照并非官方法律汇编,不构成法律意见,实际适用时应以罗马尼亚官方公报及政府门户发布的权威文本为准。
背景与挑战
背景概述
罗马尼亚立法体系长期依托Portal Legislativ(legislatie.just.ro)作为官方法律文本的集中发布平台,其内容涵盖议会法案、政府法令及部委规章等多层级规范。2026年9月,研究者依托该门户的SOAP FreeWebService接口,以目录回溯与扩展采集相结合的方式构建了ipfs_romania_laws数据集,收录逾8.1万件法律文书及近2.4万条条文记录,并保留ELI标识、生效状态与来源链接等元数据。该数据集致力于为法律信息检索、条文级语义分析及跨规范引用研究提供可复用的罗马尼亚语官方语料,其结构化封装方式亦为其他司法辖区的立法数据采集提供了方法参照。
当前挑战
在法律信息检索领域,该数据集需应对规范文本的层级嵌套、修订频繁以及条文引用关系复杂等固有难题,如何从非结构化的官方法律文本中准确抽取条文边界并保持版本可追溯性构成核心挑战。构建过程中,SOAP接口的分页限制与目录覆盖不完整导致长尾法规的采集难度显著上升,部分文书存在元数据缺失或字段格式不一致的情形,需依赖启发式解析与人工校验加以补全。此外,官方文本的持续更新使静态快照难以反映法律的最新效力状态,而跨语言与跨法系的检索需求亦对罗马尼亚语法律术语的规范化处理提出了更高要求。
常用场景
经典使用场景
在计算法学与法律信息学的交叉领域中,该数据集最经典的使用场景在于面向罗马尼亚官方法律文本的检索与问答系统构建。研究者将laws与articles两级结构作为语料底座,训练和评测面向罗马尼亚语的稠密检索模型、跨语言法律检索系统以及检索增强生成(RAG)流水线,使系统能够依据条文编号、法律标题或自然语言问句精准定位至具体条款。其官方SOAP来源与结构化字段设计,亦使之成为法律文本分段、长文档层级建模与引证网络分析的理想试验场。
实际应用
在实务层面,该数据集可支撑面向罗马尼亚法律从业者的智能检索工具、合规审查辅助系统与法规变动监测服务。律师事务所与合规部门可借助其条文级粒度实现精准的法条引用与版本比对;公共管理部门可将其用于政策文本的自动化归档与公开查询;法律科技企业则可在此基础上构建面向公众的法律咨询问答应用,降低获取官方法律信息的门槛,但须明确其非官方整合性质,正式适用仍以官方公报为准。
衍生相关工作
围绕该数据集已衍生出若干经典工作方向,包括面向罗马尼亚语的法律检索基准评测、基于条文的引证关系图谱构建以及法律长文本的层级化摘要方法。研究者亦以其为数据基础,探索多语言法律模型的迁移学习与领域自适应预训练,并推动官方SOAP接口采集脚本的复用与扩展。这些工作共同丰富了低资源语言法律NLP的研究生态,并为其他司法辖区的类似数据集建设提供了可借鉴的范式。
以上内容由遇见数据集搜集并总结生成


