遇见数据集

OpenSciReasoning-Biology-20K

收藏
Hugging Face2026-08-09 更新2026-08-10 收录
官方服务:

资源简介:

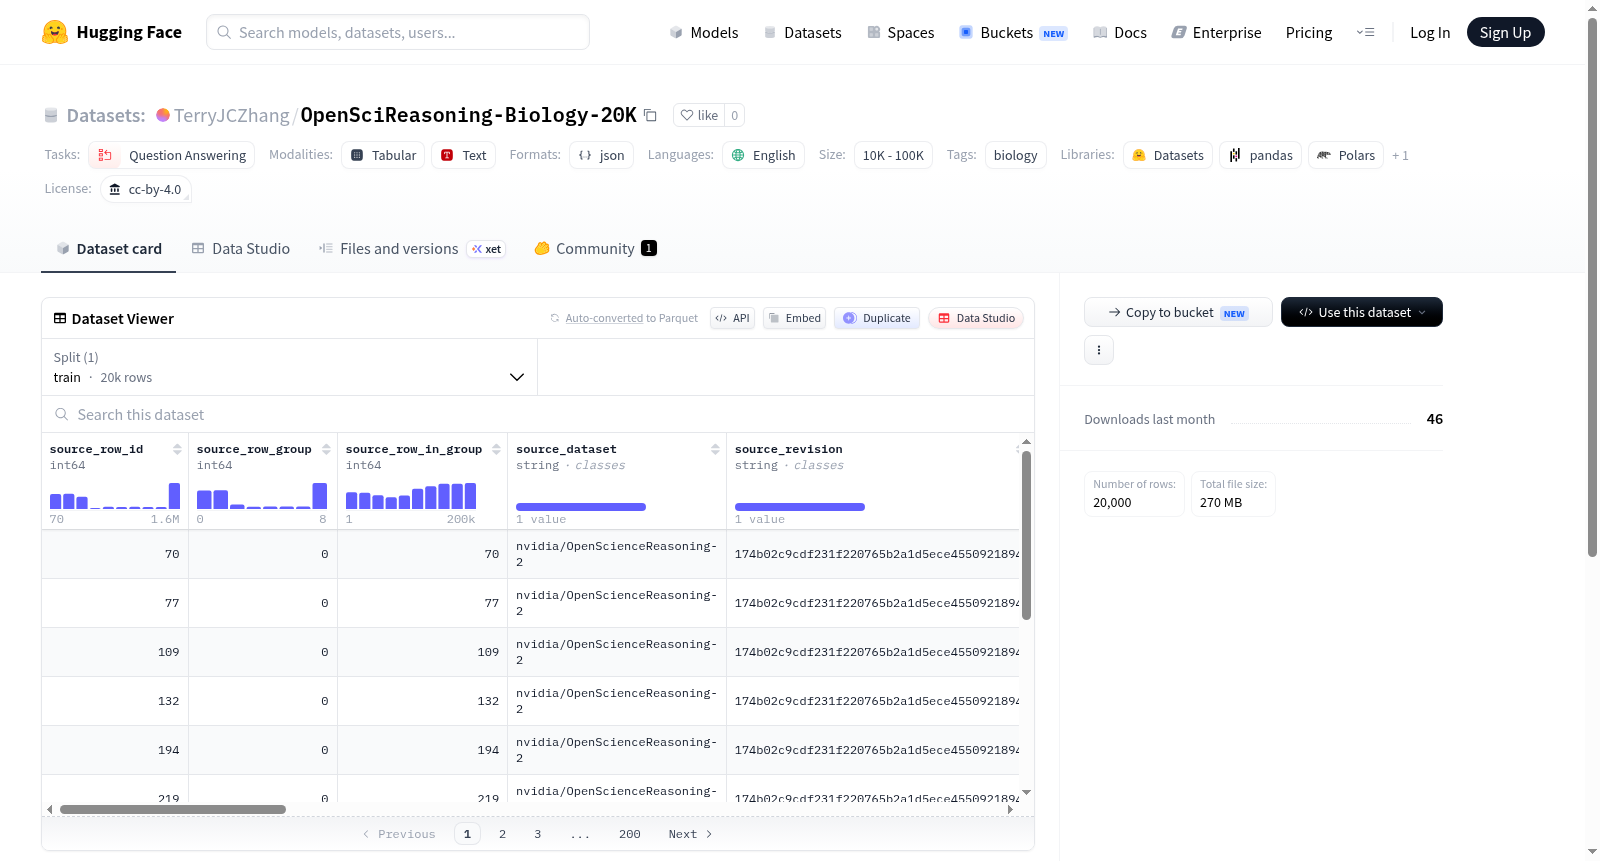
OpenSciReasoning-Biology-20K 是一个从 nvidia/OpenScienceReasoning-2 数据集中提取的生物学领域问答数据集,专用于领域特定推理器训练和跨域迁移实验。该数据集包含约20,000个样本,每个样本均保留稳定的源行标识符 source_row_id,并具有唯一的 domain 字段值 BIOLOGY。领域归属通过两个独立的问题验证器根据问题和选项进行核查,同时重放答案和源标识符门控。数据集中包含的审计记录(audit/format_issues.jsonl)列出了源输出编码警告;任何包含 U+FFFD 替换字符的上游行被隔离并替换为干净的源行,未进行任何静默猜测或重写。数据集采用 CC-BY-4.0 许可证,语言为英语,适用于问答任务。

OpenSciReasoning-Biology-20K is a biology-domain question-answering dataset extracted from the nvidia/OpenScienceReasoning-2 dataset, specifically designed for domain-specific reasoning training and cross-domain transfer experiments. It contains approximately 20,000 samples, each retaining a stable source_row_id and a unique domain field value BIOLOGY. Domain attribution is verified by two independent question validators based on questions and options, with answer replay and source identifier gating. The dataset includes an audit record (audit/format_issues.jsonl) listing source output encoding warnings; any upstream rows containing U+FFFD replacement characters are isolated and replaced with clean source rows, without silent guessing or rewriting. The dataset is licensed under CC-BY-4.0, the language is English, and it is suitable for question-answering tasks.

创建时间:
2026-07-27
原始信息汇总

OpenSciReasoning-Biology-20K 数据集概述

基本信息

  • 数据集名称:OpenSciReasoning Biology 20K
  • 许可证:CC-BY-4.0(知识共享署名4.0国际版)
  • 语言:英语
  • 任务类型:问答(Question Answering)
  • 数据集规模:10K至100K条样本(对应文件包含20,000条数据)
  • 数据格式:JSONL(每行一个JSON对象),文件名为 biology_20000.jsonl

数据来源与构建

  • 该数据集源自 nvidia/OpenScienceReasoning-2,是一个三领域发布版本中的生物学子集
  • 设计用于领域特定的推理模型训练以及跨领域迁移实验

数据特点

  • 每条数据保留了稳定的 source_row_id 字段,便于溯源与关联
  • 每条数据具有唯一的互斥 domain 字段,取值为 BIOLOGY
  • 领域归属通过两个独立的、仅基于问题文本的验证器进行双重校验
  • 同时复验了答案和来源ID的通过性

质量控制

  • 审计记录保存在 audit/format_issues.jsonl 文件中,列出剩余的来源输出编码警告
  • 上游中包含 U+FFFD(替换字符)的行被隔离,替换为干净来源行
  • 所有数据处理均未进行无依据的猜测或文本重写,确保数据原始性
搜集汇总
数据集介绍
OpenSciReasoning-Biology-20K 数据集图片
构建方式
该数据集源自NVIDIA的OpenScienceReasoning-2,经过精细化领域筛选与重构,专门针对生物学领域构建。构建过程中,每一数据条目均保留了原始的稳定标识符source_row_id,并确保其领域归属唯一且互斥,即仅包含生物学内容。领域判定依据问题与选项,通过两个独立的仅基于问题的验证器进行严格审核,同时重放了答案与源ID的验证流程,以保证数据集的纯净性与一致性。对于上游数据中出现的编码异常(如U+FFFD替换字符),进行了隔离处理,并以干净的源数据替代,确保所有文本信息未经任何臆测或篡改,完整保留原始语义。
使用方法
使用该数据集时,研究人员可直接加载train分割文件(biology_20000.jsonl),其格式为JSON Lines,便于与多种深度学习框架无缝集成。该数据集适合用于训练生物学领域的推理模型,或进行跨领域迁移学习的基线测试。建议在预处理阶段参考audit/format_issues.jsonl文件,以了解并处理可能存在的格式异常。数据集结构清晰,字段定义明确,用户可根据实际需求进行数据过滤或增强。
背景与挑战
背景概述
OpenSciReasoning-Biology-20K数据集由NVIDIA研究团队于近期发布,源自其OpenScienceReasoning-2项目,专注于生物学领域的科学推理任务。该数据集的构建旨在应对大规模语言模型在科学问答中推理能力不足的问题,为领域特定的推理器训练和跨域迁移实验提供高质量的语料资源。每个样本均保留稳定的源行标识,并经过严格的领域筛选和审计,确保数据纯净性。该数据集的出现填补了生物学专业推理数据集的空白,对推动科学人工智能的发展具有重要影响。
当前挑战
该数据集面临的核心挑战包括:其一,生物学问题具有高度专业性和复杂性,要求模型具备多步逻辑推理和跨概念整合能力,远超一般问答任务;其二,在数据构建过程中,需确保领域标签的准确性,通过双独立验证器剔除噪声,同时处理源数据中的编码错误(如U+FFFD字符),避免污染训练集,这一过程需在保证数据完整性与质量间取得平衡,其严格审计机制亦对后续同类数据集建设提出更高标准。
常用场景
经典使用场景
在生物医学与人工智能的交叉前沿,高质量领域数据集是构建可推理模型的关键基石。OpenSciReasoning-Biology-20K作为从大规模科学推理语料中精炼出的生物学专属子集,其经典用途集中于训练和评测面向生物领域的选择题问答系统。研究者常以此数据集为基准,检验模型在生物现象解释、遗传机制推断、生态关系分析等任务的推理能力,通过与通用科学语料训练的模型对比,量化领域专属数据对推理准确率与泛化性能的提升。
解决学术问题
该数据集直面跨领域迁移学习中因数据混杂导致的领域混淆与评估偏差问题。通过严格的单一领域标注与质量控制流程,它解决了如何从多领域语料中提取纯净生物语义的学术挑战,为研究领域特定推理与通用推理间的内在联系提供了标准化测试平台。其影响在于推动了可解释性科学问答模型的发展,使得模型的知识检索与逻辑链构建能够更精细地适配生物学科的知识结构。
实际应用
在智能教育、科研辅助与临床决策支持等实际场景中,该数据集可支撑生物学科自适应学习系统的开发,实现针对学生薄弱知识点的个性化习题生成与推理路径反馈。通过微调于此类数据,模型能够辅助科研人员快速检索生物文献中的因果推论,或在分子生物学实验设计中提供假设验证的初步建议,提升知识工作者的信息整合效率。
数据集最近研究
最新研究方向
该数据集聚焦于生物学领域的科学推理能力,基于NVIDIA的OpenScienceReasoning-2进行领域特化与跨域迁移研究。当前前沿方向包括利用高质量、领域纯净的数据集训练专用推理模型,以提升在科学问题回答中的逻辑演绎与知识应用能力。通过严格的领域验证与质量控制,该数据集支持跨域泛化实验,探索模型在生物学科上的深度理解与迁移学习潜力,对科学教育AI和可解释推理系统的发展具有重要意义。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务