Technical-Architectures-Large
收藏资源简介:
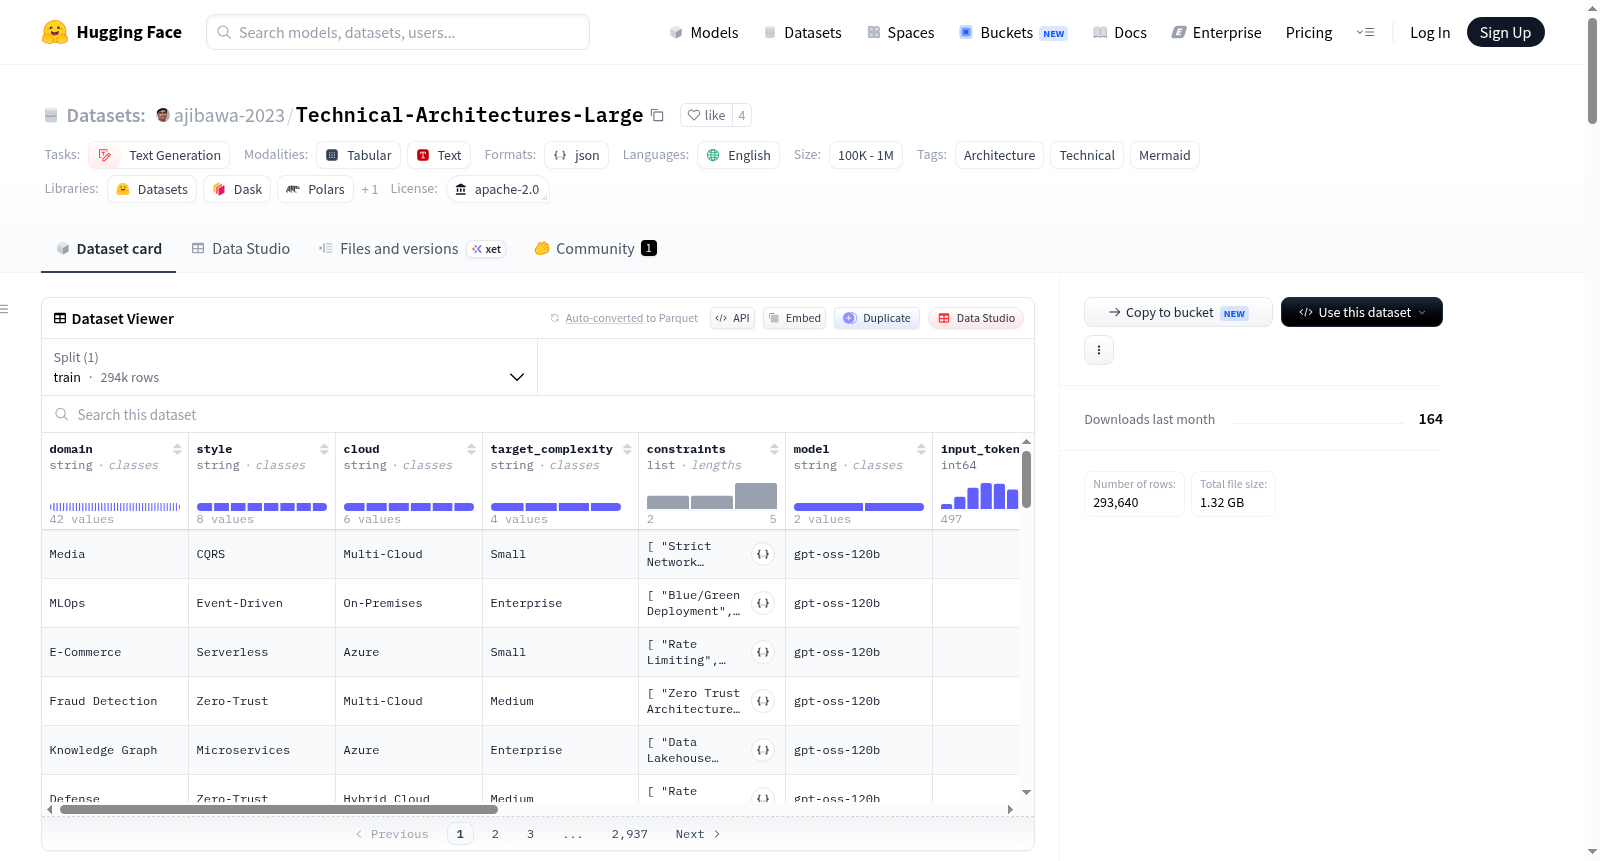
Technical Architectures Large 是一个包含超过21万个经过验证的企业软件架构图的数据集,专门用于解决AI模型从自然语言需求生成复杂且语法正确的图表代码的挑战。该数据集由GPT-OSS-120B和Qwen3-Coder-Next-FP8两种前沿模型生成,涵盖了从客户端层、边缘安全、API网关、服务网格到合规边界和多云基础设施拓扑的真实企业系统模型。数据集以JSON Lines格式组织,每个样本代表一个自包含的架构规范,包含丰富的结构和执行元数据。关键特征包括:覆盖42个行业领域(如金融科技、MLOps、网络安全、医疗保健等)、8种架构范式(如微服务、事件驱动、零信任、CQRS等)、6种云部署目标(AWS、Azure、GCP、多云、混合云、本地部署)以及4个复杂度层级(小型、中型、大型、企业级)。支持的Mermaid图表类型包括流程图、序列图、状态图、ER图、类图等9种。每个样本记录包含唯一ID、领域、风格、云环境、目标复杂度、动态注入的生产约束列表、生成模型、输入输出令牌数、生成终止原因、节点和边数量、图表类型以及原始的Mermaid.js源代码。数据集经过严格的多阶段质量验证,确保语法正确性和结构密度。适用于代码大语言模型的微调、自动化系统设计AI助手的开发,以及评估LLM在遵循严格拓扑约束方面的推理能力。
Technical Architectures Large is a dataset containing over 210,000 validated enterprise software architecture diagrams, specifically designed to address the challenge of AI models generating complex, syntactically correct diagram code from natural language requirements. This dataset is generated by two cutting-edge models, GPT-OSS-120B and Qwen3-Coder-Next-FP8, covering real-world enterprise system models ranging from client-side layers, edge security, API gateways, service meshes to compliance boundaries and multi-cloud infrastructure topologies. The dataset is organized in JSON Lines format, where each sample represents a self-contained architecture specification with rich structural and execution metadata. Key features include: coverage of 42 industry domains (e.g., fintech, MLOps, cybersecurity, healthcare, etc.), 8 architectural paradigms (e.g., microservices, event-driven, zero-trust, CQRS, etc.), 6 cloud deployment targets (AWS, Azure, GCP, multi-cloud, hybrid cloud, on-premises), and 4 complexity levels (small, medium, large, enterprise-grade). Supported Mermaid diagram types include 9 categories such as flowcharts, sequence diagrams, state diagrams, ER diagrams, class diagrams, etc. Each sample record contains a unique ID, domain, style, cloud environment, target complexity, dynamically injected list of production constraints, generation model, input and output token counts, generation termination reason, number of nodes and edges, diagram type, and the original Mermaid.js source code. The dataset has undergone rigorous multi-stage quality validation to ensure syntactic correctness and structural density. It is applicable for fine-tuning code large language models, developing automated system design AI Agents, and evaluating the reasoning capabilities of LLMs in adhering to strict topological constraints.
数据集总结:Technical Architectures Large
该数据集包含超过 210,000 个由 AI 模型生成的企业软件架构,旨在弥合自然语言需求与有效图表代码生成之间的差距。
核心信息
- 名称: Technical Architectures Large (210k+ Samples)
- 链接: https://huggingface.co/datasets/ajibawa-2023/Technical-Architectures-Large
- 许可: Apache-2.0
- 语言: 英语 (en)
- 任务: 文本生成 (text-generation)
- 标签: 架构 (Architecture)、技术 (Technical)、Mermaid
关键统计指标
| 指标 | 详情 |
|---|---|
| 总样本数 | ~210,000 个已验证的架构图 |
| 生成模型 | gpt-oss-120b, qwen3-coder-next-fp8 |
| 数据格式 | JSON Lines (.jsonl) |
| 行业领域 | 42 个类别 (金融科技、MLOps、网络安全、医疗等) |
| 架构风格 | 8 种范式 (微服务、事件驱动、零信任、CQRS 等) |
| 云基础设施 | 6 个目标 (AWS, Azure, GCP, 多云, 混合云, 本地部署) |
| 复杂度等级 | 小型、中型、大型、企业级 |
| 支持的图表类型 | flowchart LR, flowchart TB, sequenceDiagram, stateDiagram-v2, erDiagram, classDiagram, gitGraph, mindmap, timeline |
数据模式 (Schema)
每条 JSON 记录是一个自包含的架构规约,包含以下字段:
| 字段名 | 数据类型 | 描述 |
|---|---|---|
id |
整数 | 唯一标识符 |
domain |
字符串 | 架构针对的行业垂直领域 |
style |
字符串 | 软件工程设计范式 |
cloud |
字符串 | 目标部署基础设施环境 |
target_complexity |
字符串 | 预期结构规模 |
constraints |
数组[字符串] | 2-5 个动态注入的生产需求 |
model |
字符串 | 用于生成样本的 AI 模型 |
input_tokens |
整数 | 系统提示和用户提示的总令牌数 |
output_tokens |
整数 | 生成的 Mermaid 代码块的总令牌数 |
finish_reason |
字符串 | 生成终止标志 (严格过滤为 "stop") |
nodes |
整数 | 唯一架构实体和子图的绝对数量 |
edges |
整数 | 有向连接和数据流的总数 |
diagram_type |
字符串 | 已验证的标准 Mermaid 模式声明 |
mermaid |
字符串 | 原始的、可用于生产的 Mermaid.js 源代码 |
生成与处理流程
- 高吞吐量连续批处理: 使用 2× NVIDIA H100 NVL GPU 和 vLLM 推理引擎,实现每次生成步骤同时批处理 512 个提示。
- 动态约束注入: 避免结构重复,每个提示动态组合来自 42 个行业领域、8 种架构风格和随机技术约束的选择。
- 严格的多阶段验证: 通过自动质量过滤器,包括语法检查、密度阈值(至少 4 个节点和 2 条边)、长度限制(丢弃
finish_reason为length的样本)以及失败重试队列。
预期用途
- 代码大语言模型微调: 训练基础代码模型掌握标准 Mermaid 图表语法和复杂空间图关系。
- 自动化系统设计: 构建能够将需求文档或云 RFP 规约转化为可视化架构图的 AI 助手。
- 基准测试与评估: 测试 LLM 推理能力,评估生成图是否严格遵循拓扑约束。