
hsk-dataset
收藏官方服务:
资源简介:
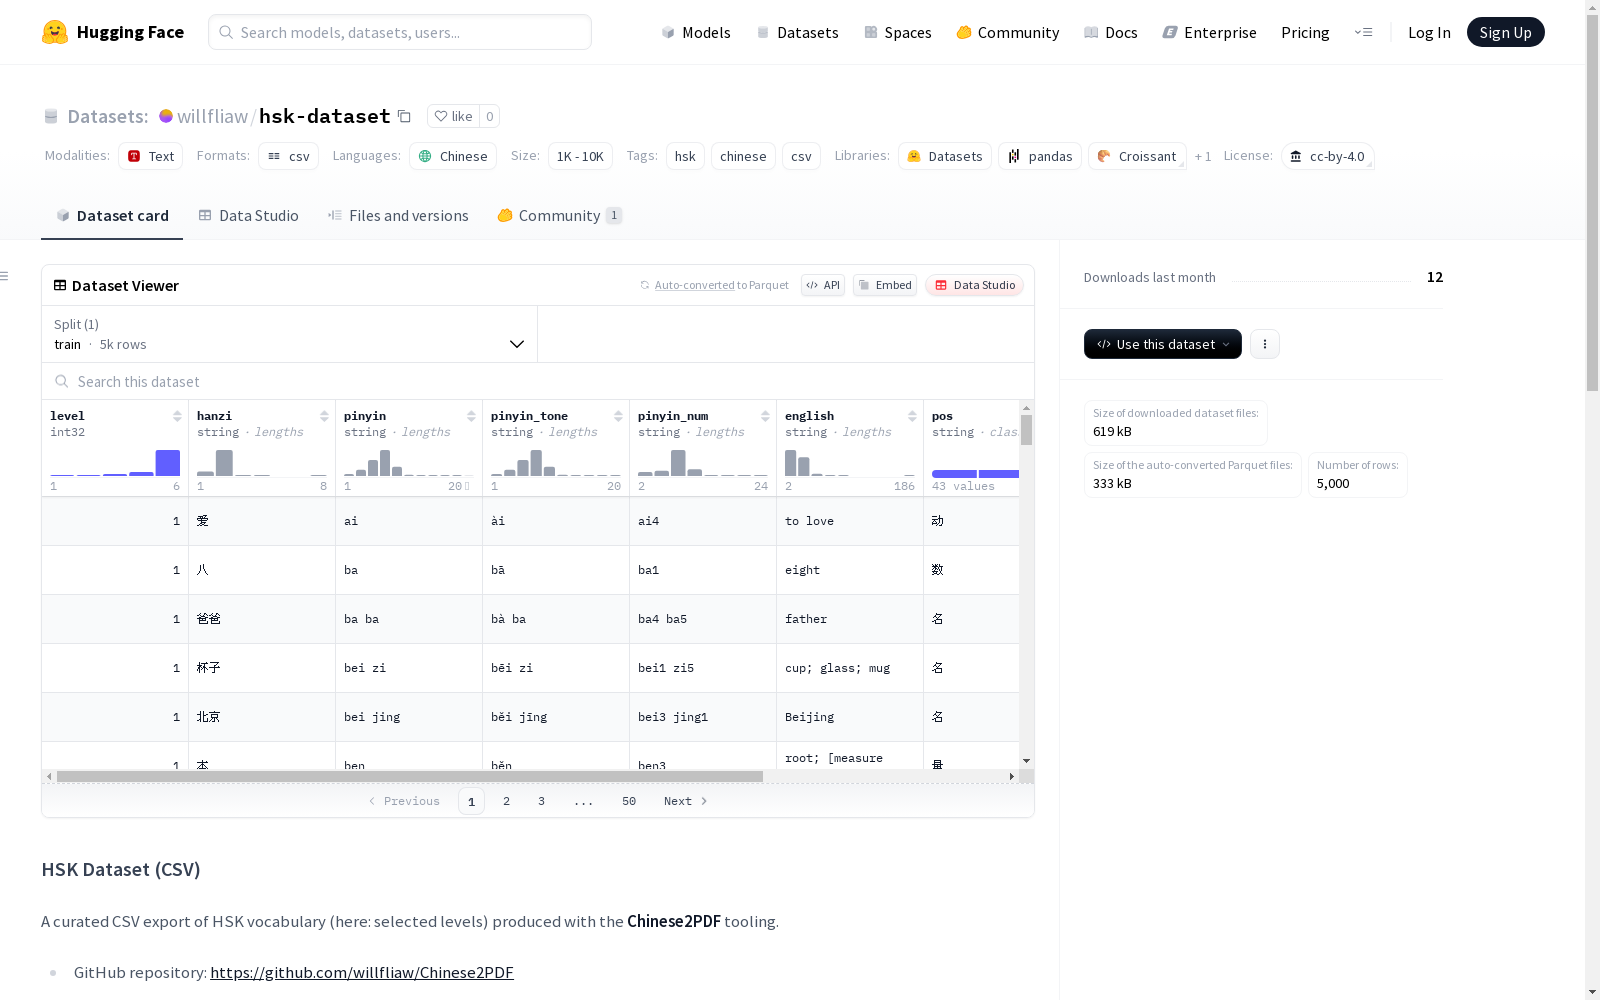
HSK数据集是一个包含不同级别HSK词汇的CSV文件。它包括HSK级别、汉字、不带声调的拼音、带声调的拼音、数字声调拼音、英文翻译、词性以及可用的音频链接等信息。该数据集由Chinese2PDF工具生成,旨在帮助学习和教学汉语。
The HSK Dataset is a CSV file containing HSK vocabulary across different proficiency levels. It includes information such as HSK level, Chinese characters, toneless pinyin, pinyin with tone marks, pinyin with numerical tone markers, English translations, part-of-speech tags, and available audio links. This dataset was generated by the Chinese2PDF tool, and is designed to facilitate Chinese language learning and teaching.
创建时间:
2025-08-31
原始信息汇总
HSK Dataset (CSV) 数据集概述
数据集基本信息
- 数据集名称:HSK Dataset (CSV)
- 许可证:cc-by-4.0
- 语言:中文 (zh)
- 标签:hsk, chinese, csv
数据集来源
- 生成工具:Chinese2PDF
- GitHub 仓库:https://github.com/willfliaw/Chinese2PDF
- 构建脚本:https://github.com/willfliaw/Chinese2PDF/blob/main/scripts/build_hsk_dataset.py
数据内容
- 文件位置:
data/hsk_words.csv - 数据格式:CSV
数据特征
| 特征名称 | 数据类型 | 描述 |
|---|---|---|
| level | int32 | HSK 等级 |
| hanzi | string | 中文词语 (汉字) |
| pinyin | string | 拼音 (无声调标记) |
| pinyin_tone | string | 带声调符号的拼音 (如可用) |
| pinyin_num | string | 数字标调拼音 (如可用) |
| english | string | 英文翻译 |
| pos | string | 词性 (如可用) |
| tts_url | string | 音频 URL (如可用) |
使用说明
- 加载方式:通过 🤗 Datasets 库的
load_dataset函数加载 - 数据文件地址:https://huggingface.co/datasets/willfliaw/hsk-dataset/resolve/main/data/hsk_words.csv
- 注意事项:某些可选列可能为空,具体取决于数据来源
许可证信息
- 许可证类型:CC-BY-4.0
- 使用建议:如需商业用途或重新分发,请验证原始来源条款
搜集汇总
数据集介绍
构建方式
在汉语作为第二语言教学领域,HSK词汇表是核心学习资源。本数据集通过Chinese2PDF工具链中的专用脚本构建,从权威HSK词汇源系统提取并转换数据,生成结构化CSV文件。构建过程注重保留原始词汇的完整性,同时标准化拼音标注和英文释义,确保数据的一致性与准确性。
特点
该数据集涵盖多个HSK等级的词汇,每条记录包含汉字、多种拼音形式(无调号、带调号及数字调式)、词性标注及英文翻译。特别提供可选音频资源链接,增强学习体验。数据以CC-BY-4.0许可发布,支持学术与商业用途,字段设计兼顾语言学研究和教学应用需求。
使用方法
研究者可通过HuggingFace Datasets库直接加载远程CSV文件,快速构建可迭代数据集对象。教育开发者可集成该结构化数据至语言学习平台,实现词汇分类检索、发音练习及自适应测试功能。数据字段的丰富性支持多模态语言研究,包括音形义关联分析与二语习得规律探索。
背景与挑战
背景概述
汉语水平考试(HSK)作为全球最具影响力的中文语言能力标准化测评体系,其词汇数据库的构建始于20世纪90年代初期,由中国国家汉办主导开发。该数据集通过系统化整理HSK分级词汇体系,为中文作为第二语言习得研究提供了核心语料支撑,深刻影响了国际中文教育领域的课程设计、教材编写及语言能力评估标准的确立。
当前挑战
在中文语言资源构建领域,HSK数据集需解决多音字消歧、方言变体归一化及跨语言语义对齐等核心语言学问题。数据整合过程中面临原始资料来源异构性挑战,包括注音系统标准化(拼音与注音符号转换)、词性标注体系不一致,以及声调标记的机器可读化处理,这些因素共同增加了数据清洗与结构化整理的复杂度。
常用场景
经典使用场景
在汉语作为第二语言教学研究领域,HSK数据集为词汇分级与习得顺序提供了标准化参照。该数据集通过系统整理HSK考试大纲中的分级词汇,并标注拼音、词性和英文释义,成为构建自适应语言学习系统的核心资源。研究者可基于词汇难度层级开发智能化的教学材料序列,优化非母语者的汉语词汇输入顺序。
实际应用
在实际应用层面,该数据集为智能教育科技产品提供了核心底层支持。语言学习类应用程序可集成其分级词汇数据,构建个性化复习系统与自适应测试引擎。在线教育平台利用其标准化的发音标注和词义解释,开发交互式汉字学习模块与语音评估工具,显著提升汉语学习者的词汇掌握效率与发音准确性。
衍生相关工作
基于该数据集衍生的经典工作包括神经网络驱动的汉语词汇难度预测模型,以及融合多模态特征的智能闪卡生成系统。研究者利用其结构化数据训练了基于Transformer的词汇分级算法,相关成果发表于计算语言学顶级会议。同时催生了多个开源汉语学习工具链,如支持自动例句生成的插件系统和语音合成集成框架,形成了完整的教育技术生态系统。
以上内容由遇见数据集搜集并总结生成


