Sterzhang/image-textualization
收藏资源简介:
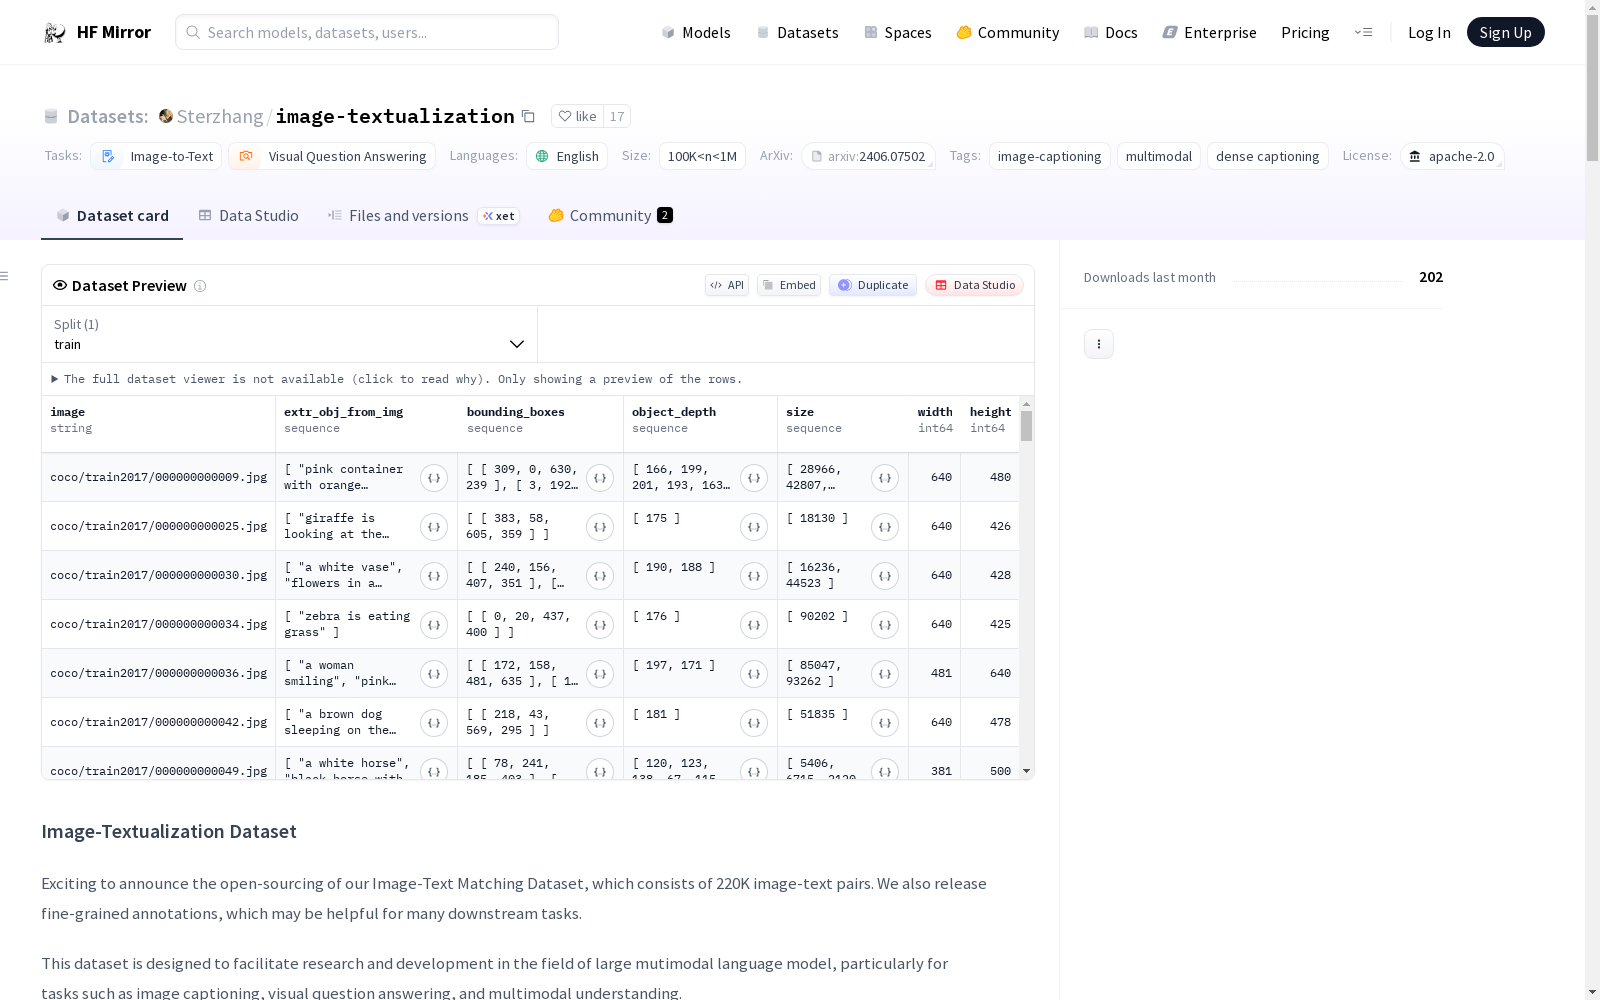
Image-Textualization数据集包含220K个图像-文本对,旨在促进大规模多模态语言模型的研究和开发,特别是在图像描述、视觉问答和多模态理解等任务中。数据集格式为JSONL,包含图像文件路径、图像对应的文本描述以及描述图像的问题。数据来源包括COCO train2017、SA-1B和VG。该数据集展示了在对象密集的图像数据集中获取高质量描述的出色可扩展性。
The Image-Textualization dataset comprises 220K image-text pairs, designed to facilitate the research and development of large-scale multimodal language models, particularly for tasks such as image captioning, visual question answering, and multimodal understanding. The dataset is provided in JSONL format, containing image file paths, textual descriptions corresponding to the images, and questions that describe the images. Its data sources include COCO train2017, SA-1B, and VG. This dataset demonstrates excellent scalability in acquiring high-quality descriptions for object-dense image datasets.
Image-Textualization Dataset
概述
- 名称: Image-Textualization Dataset
- 标签: image-captioning, multimodal, dense captioning
- 许可证: apache-20
- 任务类别: image-to-text, visual-question-answering
数据集详情
- 总对数: 170K
- 格式: JSONL (JSON Lines)
- 内容:
image: 图像文件路径description: 图像的文本描述question: 描述图像的问题
- 来源: COCO train2017, SA-1B, VG
引用
bibtex @misc{pi2024image, title={Image Textualization: An Automatic Framework for Creating Accurate and Detailed Image Descriptions}, author={Renjie Pi and Jianshi Zhang and Jipeng Zhang and Rui Pan and Zhekai Chen and Tong Zhang}, year={2024}, eprint={2406.07502}, archivePrefix={arXiv}, primaryClass={cs.CV} }