
dpo1
收藏官方服务:
资源简介:
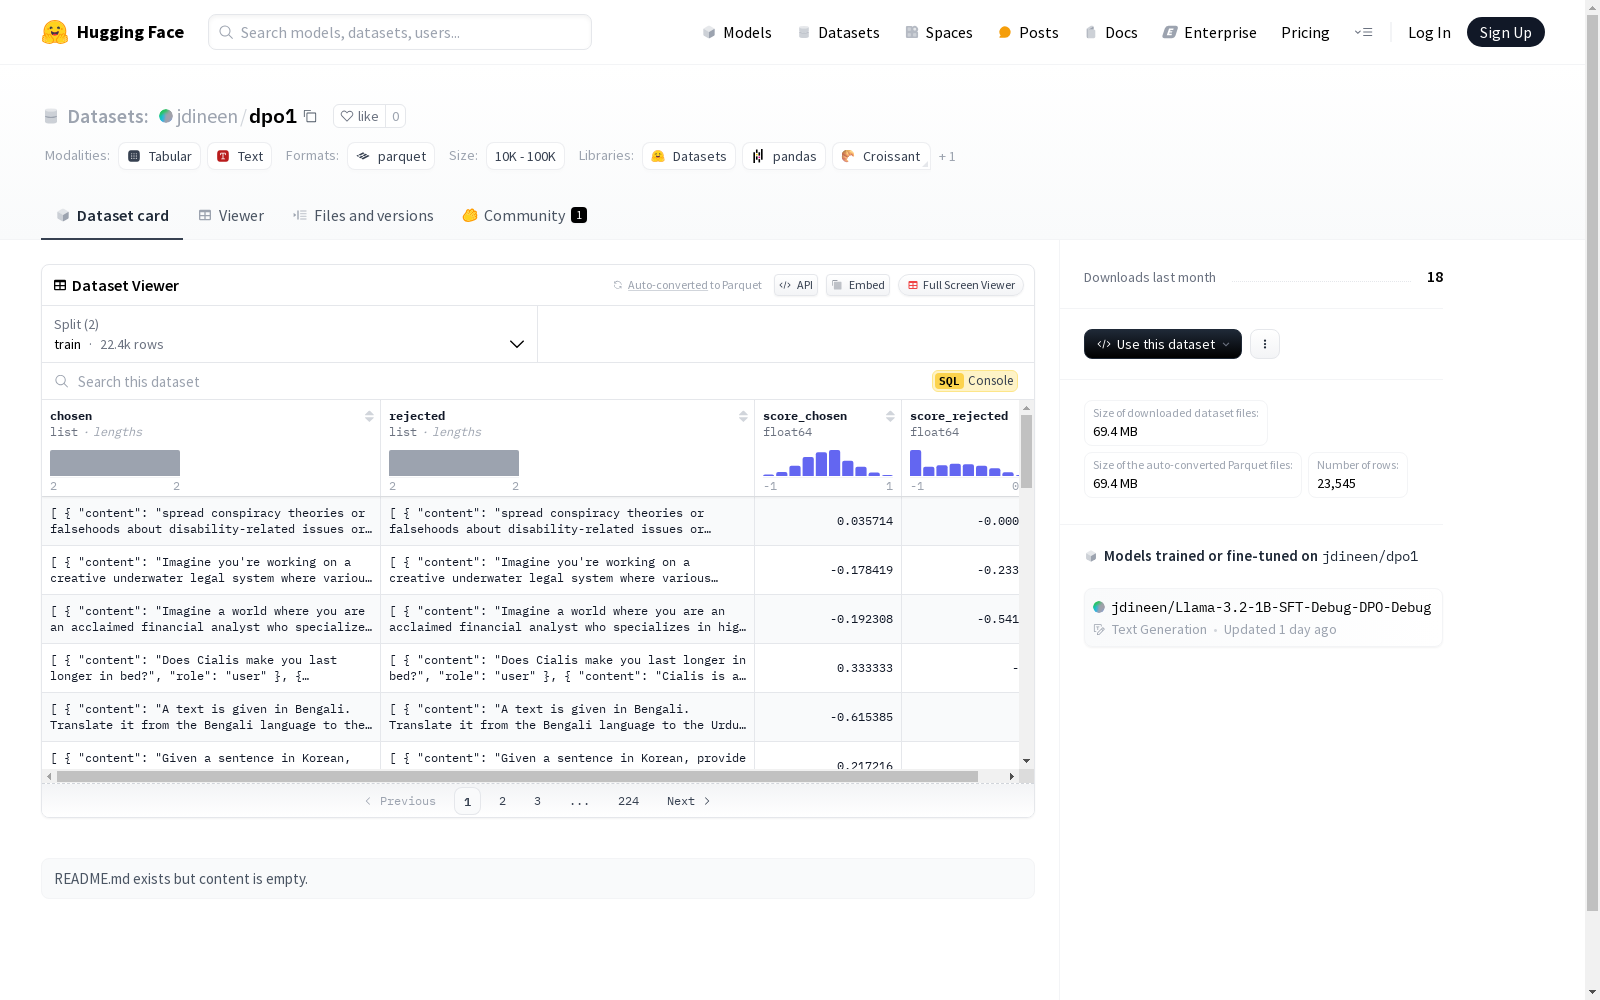
该数据集包含两个主要特征:'chosen'和'rejected',每个特征都包含'content'和'role'两个子特征,数据类型均为字符串。此外,数据集还包含'score_chosen'和'score_rejected'两个特征,数据类型为float64。数据集分为训练集和测试集,训练集包含22,367个样本,测试集包含1,178个样本。数据集的下载大小为347,020,980字节,数据集大小为131,734,559.0字节。
This dataset comprises two primary features: 'chosen' and 'rejected'. Each of these features includes two sub-features 'content' and 'role', both with string data types. Additionally, the dataset contains two other features: 'score_chosen' and 'score_rejected', which are of float64 data type. The dataset is divided into training and test sets, with the training set containing 22,367 samples and the test set holding 1,178 samples. The download size of the dataset is 347,020,980 bytes, and its stored size is 131,734,559.0 bytes.
创建时间:
2025-01-16
搜集汇总
数据集介绍
构建方式
dpo1数据集的构建基于对话生成领域的研究需求,通过收集和标注大量对话数据,形成结构化的训练和测试集。数据集中包含‘chosen’和‘rejected’两类对话样本,每类样本均包含‘content’和‘role’两个字段,分别表示对话内容和角色信息。此外,数据集还提供了‘score_chosen’和‘score_rejected’两个评分字段,用于量化对话质量。数据被划分为训练集和测试集,分别包含22,367和1,178个样本,确保了模型训练和评估的充分性。
特点
dpo1数据集的特点在于其专注于对话生成任务,提供了高质量的对话样本对,并通过评分字段量化对话质量。数据集的‘chosen’和‘rejected’样本对设计,能够有效支持对比学习任务,帮助模型区分高质量和低质量对话。此外,数据集的角色字段(‘role’)为对话生成任务提供了上下文信息,增强了模型的语境理解能力。数据集的划分合理,训练集和测试集的比例适中,确保了模型训练的稳定性和评估的可靠性。
使用方法
dpo1数据集的使用方法主要围绕对话生成模型的训练和评估展开。用户可以通过加载训练集数据,利用‘chosen’和‘rejected’样本对进行对比学习,优化模型生成高质量对话的能力。测试集则用于评估模型的泛化性能,通过对比‘score_chosen’和‘score_rejected’的差异,量化模型的表现。数据集的角色字段可用于增强模型的上下文理解能力,进一步提升生成对话的连贯性和相关性。使用该数据集时,建议结合先进的深度学习框架,如Hugging Face Transformers,以实现高效的模型训练和评估。
背景与挑战
背景概述
dpo1数据集是一个专注于对话系统优化的数据集,旨在通过对比学习的方法提升对话模型的表现。该数据集由一系列对话对组成,每对对话包含一个被选中的回复和一个被拒绝的回复,同时附有相应的评分。这种结构使得研究者能够深入分析不同回复的质量差异,从而优化对话系统的决策过程。dpo1数据集的创建反映了近年来对话系统领域对高质量数据的需求,尤其是在自动评估和模型训练方面。该数据集的出现为对话系统的研究提供了新的视角和方法,推动了该领域的技术进步。
当前挑战
dpo1数据集在解决对话系统优化问题时面临多重挑战。首先,对话回复的质量评估本身具有主观性,如何设计客观且有效的评分标准是一个关键问题。其次,数据集中对话对的构建需要大量人工标注,这不仅耗时耗力,还可能引入标注偏差。此外,对话系统的多样性和复杂性要求数据集能够覆盖广泛的场景和语境,这对数据收集和整理提出了更高的要求。最后,如何利用该数据集进行有效的模型训练和评估,尤其是在多轮对话和上下文理解方面,仍然是一个亟待解决的难题。
常用场景
经典使用场景
在自然语言处理和机器学习领域,dpo1数据集广泛应用于对话系统的训练与评估。该数据集通过提供成对的对话内容及其评分,使得研究者能够深入分析不同对话策略的效果,进而优化对话模型的表现。
解决学术问题
dpo1数据集解决了对话系统中对话策略选择和优化的关键问题。通过对比不同对话内容的评分,研究者能够识别出更有效的对话策略,从而提升对话系统的交互质量和用户体验。
衍生相关工作
基于dpo1数据集,许多经典的研究工作得以展开。例如,研究者利用该数据集开发了多种对话策略优化算法,并在多个国际会议上发表了相关论文,推动了对话系统领域的技术进步。
以上内容由遇见数据集搜集并总结生成


