
conll2003-dataset
收藏官方服务:
资源简介:
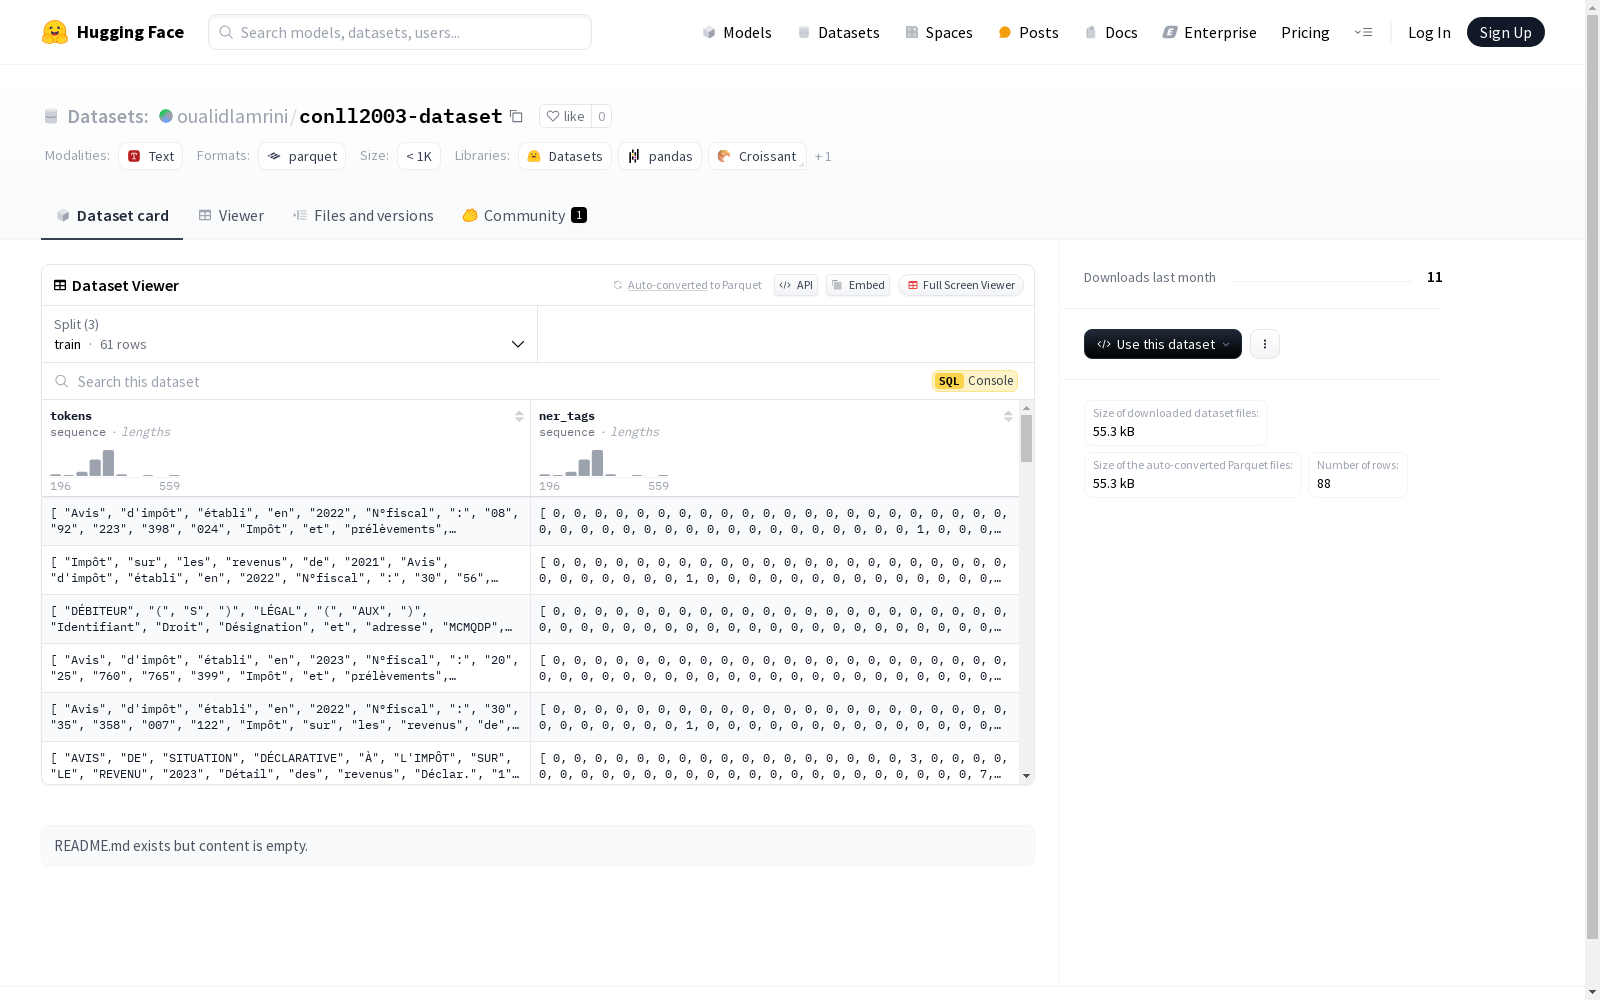
该数据集用于命名实体识别任务,包含两个主要特征:'tokens'(字符串序列)和'ner_tags'(命名实体识别标签序列)。标签包括家庭状况、申报人工资、申报人养老金和所得税等。数据集分为训练集、验证集和测试集,分别包含61、17和10个样本。
This dataset is intended for named entity recognition (NER) tasks, and it contains two core features: "tokens" (a sequence of strings) and "ner_tags" (a sequence of NER tags). The tags cover family status, declarant's salary, declarant's pension, income tax, and other related categories. The dataset is split into training, validation, and test sets, which include 61, 17, and 10 samples respectively.
创建时间:
2024-12-16
原始信息汇总
CoNLL2003 数据集
数据集信息
特征
- tokens: 序列类型,字符串。
- ner_tags: 序列类型,包含以下类别标签:
0: O1: B-situation_du_foyer2: I-situation_du_foyer13: B-salaire_declarant14: I-salaire_declarant15: B-salaire_declarant26: I-salaire_declarant27: B-pensions_declarant18: I-pensions_declarant19: B-pensions_declarant210: I-pensions_declarant211: B-impots_sur_les_revenus_soumis_au_bareme12: I-impots_sur_les_revenus_soumis_au_bareme
数据集划分
- train: 包含61个样本,占用356833字节。
- validation: 包含17个样本,占用92687字节。
- test: 包含10个样本,占用57477字节。
数据集大小
- 下载大小: 55346字节。
- 数据集大小: 506997字节。
配置
- config_name: default
- 数据文件:
- train: data/train-*
- validation: data/validation-*
- test: data/test-*
- 数据文件:
搜集汇总
数据集介绍
构建方式
conll2003-dataset数据集的构建基于经典的CoNLL-2003命名实体识别任务,其核心在于对文本中的命名实体进行标注。数据集通过将文本分割为tokens,并为每个token分配一个ner_tags标签,以标识其在命名实体中的角色。标签系统包括多种类别,如家庭状况、申报人薪资、申报人养老金等,每个类别进一步细分为开始(B-)和内部(I-)标签,以区分实体的边界。
特点
该数据集的显著特点在于其精细的标签体系和多样的实体类别,涵盖了从家庭状况到税务信息等多个领域。此外,数据集的规模适中,包含61个训练样本、17个验证样本和10个测试样本,适合用于小规模实验和模型验证。其结构化的数据格式和明确的标签定义,使得该数据集在命名实体识别任务中具有较高的实用价值。
使用方法
使用conll2003-dataset数据集时,首先需加载数据集,并根据需要选择训练、验证或测试集。数据集的tokens和ner_tags字段可直接用于模型训练,其中tokens作为输入序列,ner_tags作为目标标签。开发者可根据具体任务需求,调整模型架构和超参数,以优化命名实体识别的性能。此外,数据集的标签体系可扩展,便于进行领域特定的实体识别任务。
背景与挑战
背景概述
CoNLL2003数据集是自然语言处理领域中一个具有里程碑意义的数据集,由Tjong Kim Sang和De Meulder于2003年发布。该数据集主要用于命名实体识别(Named Entity Recognition, NER)任务,旨在从文本中识别和分类特定的实体,如人名、地名、组织名等。CoNLL2003数据集的发布极大地推动了NER技术的发展,为研究人员提供了一个标准化的基准,促进了相关算法的比较和改进。其核心研究问题是如何在不同语言和文本类型中准确识别和分类命名实体,对信息抽取、问答系统等领域产生了深远影响。
当前挑战
CoNLL2003数据集在构建和应用过程中面临多项挑战。首先,命名实体识别任务本身具有复杂性,需要处理多种语言和文本类型的差异,以及实体边界模糊和歧义问题。其次,数据集的标注过程涉及大量人工干预,确保标注的一致性和准确性是一个耗时且易出错的过程。此外,尽管CoNLL2003数据集在发布时具有先进性,但随着深度学习技术的发展,如何利用更复杂的模型和更大的数据集进一步提升NER性能,成为当前研究的重点和挑战。
常用场景
经典使用场景
CoNLL2003数据集在自然语言处理领域中,主要用于命名实体识别(NER)任务的经典研究。该数据集包含了丰富的文本标注,特别是针对人名、地名、组织名等实体的标注,为模型训练提供了高质量的基准数据。研究者通常利用该数据集来评估和比较不同NER模型的性能,尤其是在深度学习模型如BERT、LSTM等上的应用,成为该领域的基础实验数据之一。
实际应用
在实际应用中,CoNLL2003数据集的衍生模型广泛应用于信息抽取、智能客服、搜索引擎优化等领域。例如,在金融领域,NER技术可用于自动提取财务报表中的关键信息;在医疗领域,可用于从病历中识别疾病名称和药物信息。此外,在智能客服系统中,NER技术帮助系统理解用户查询中的实体信息,从而提供更精准的回答。这些应用场景展示了该数据集在实际业务中的重要价值。
衍生相关工作
基于CoNLL2003数据集,研究者们开发了多种经典的NER模型和方法。例如,基于条件随机场(CRF)的序列标注模型、基于双向LSTM的神经网络模型,以及近年来广泛应用的预训练语言模型如BERT和GPT系列。这些模型在CoNLL2003数据集上的实验结果,为后续的NER研究提供了重要的参考。此外,该数据集还激发了多语言NER、跨领域NER等扩展研究,进一步推动了自然语言处理技术的发展。
以上内容由遇见数据集搜集并总结生成


