
Pakistan-corpus-instruct
收藏官方服务:
资源简介:
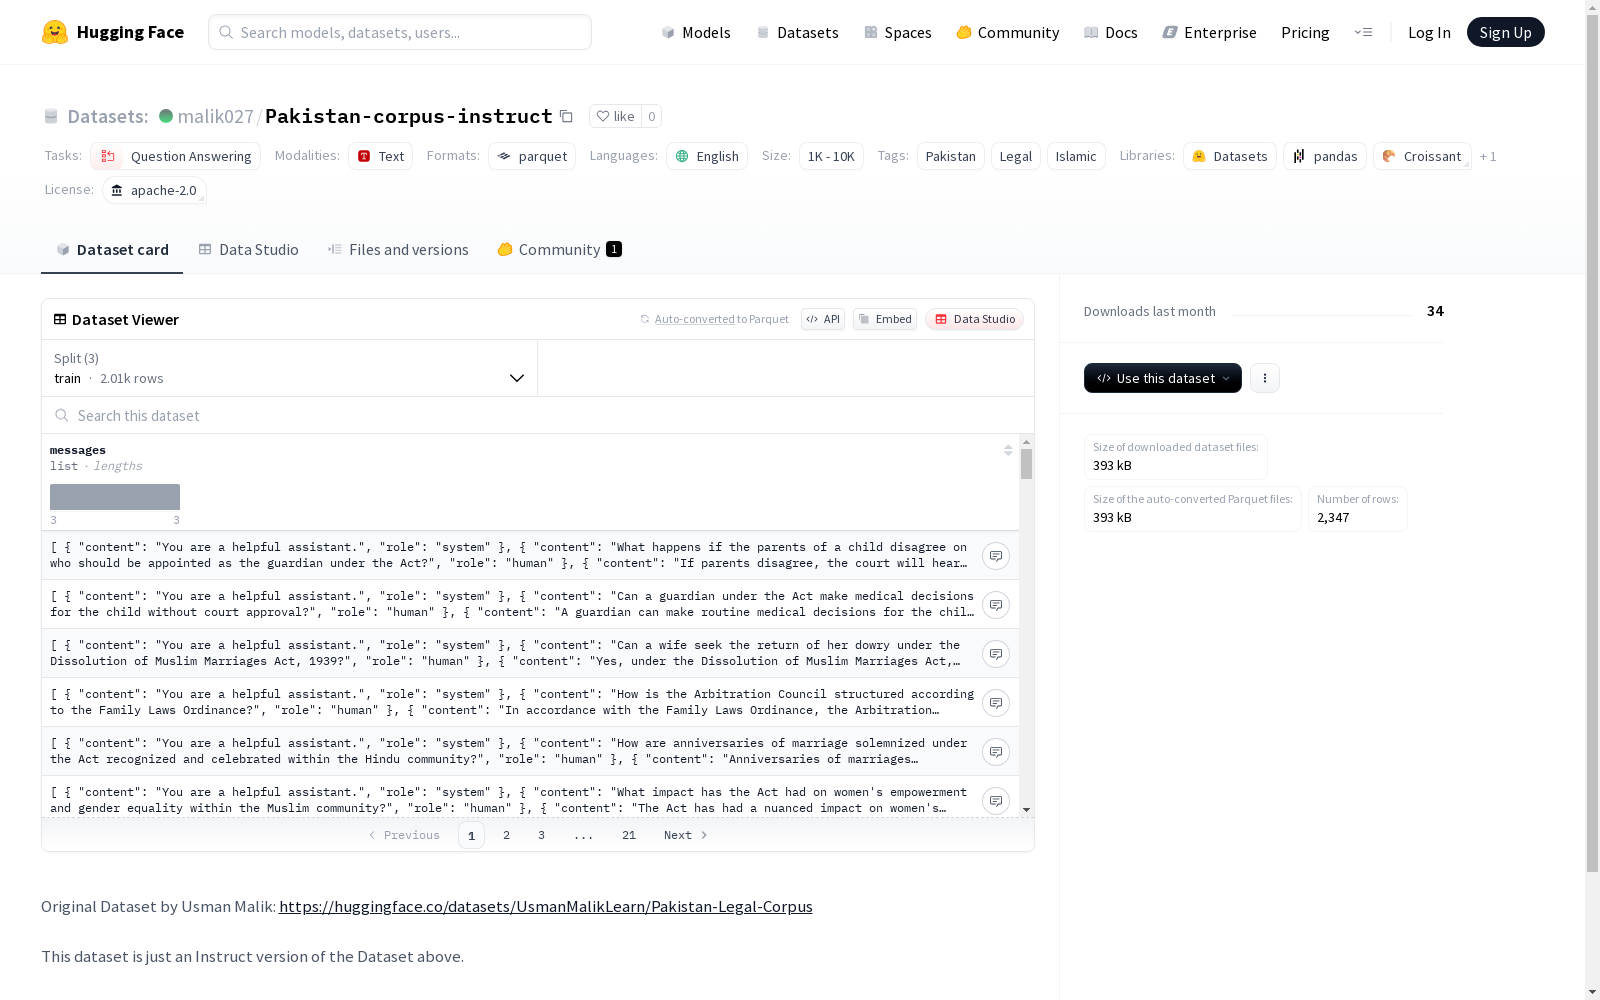
这是一个关于巴基斯坦法律问题的数据集,包含了问题内容和回答角色的信息。数据集分为训练集、测试集和验证集,适用于问题回答任务。
This is a dataset pertaining to Pakistani legal questions, which contains the question content and information about the answering roles. The dataset is split into training, test, and validation sets, and is designed for question answering tasks.
创建时间:
2025-07-25
原始信息汇总
数据集概述
基本信息
- 数据集名称: Pakistan-corpus-instruct
- 许可证: Apache-2.0
- 语言: 英语 (en)
- 标签: Pakistan, Legal, Islamic
数据集结构
- 特征:
messages:content: 字符串类型 (string)role: 字符串类型 (string)
- 数据分块:
train:- 字节数: 866,937
- 样本数: 2,006
test:- 字节数: 54,004
- 样本数: 118
val:- 字节数: 97,710
- 样本数: 223
- 下载大小: 392,598 字节
- 数据集大小: 1,018,651 字节
任务类别
- 任务类型: 问答 (question-answering)
来源
- 原始数据集: UsmanMalikLearn/Pakistan-Legal-Corpus
- 说明: 本数据集是上述数据集的指令版本 (Instruct version)。
搜集汇总
数据集介绍
构建方式
Pakistan-corpus-instruct数据集的构建基于原始巴基斯坦法律语料库(Pakistan-Legal-Corpus),通过指令化处理将其转化为适合问答任务的格式。原始数据经过清洗和重构,形成包含2006条训练样本、223条验证样本和118条测试样本的结构化数据集。每条数据以消息对话形式呈现,包含角色(role)和内容(content)两个核心字段,严格遵循Apache-2.0开源协议,确保了数据的合规性和可追溯性。
特点
该数据集聚焦巴基斯坦法律与伊斯兰教法领域,所有文本均采用英语呈现,具有鲜明的区域特色和专业性。其核心价值在于将原始法律条文转化为指令-应答对,支持问答系统的训练与评估。数据划分科学合理,训练集、验证集和测试集的比例约为9:1:1,既满足模型训练需求,又能有效验证泛化能力。消息列表的结构化设计尤其适配对话式AI的微调场景。
使用方法
研究者可借助HuggingFace平台直接加载该数据集,通过指定train/test/val分块获取相应数据。典型应用场景包括法律问答系统开发、伊斯兰教法知识建模等NLP任务。数据中的role字段标识发言者角色(如用户/助手),content字段包含具体文本内容,这种结构特别适合用于微调LLM模型。使用前建议结合原始语料库进行交叉验证,以确保领域知识的准确性。
背景与挑战
背景概述
Pakistan-corpus-instruct数据集是基于巴基斯坦法律语料库(Pakistan-Legal-Corpus)构建的指令微调版本,由研究人员Usman Malik及其团队开发。该数据集专注于巴基斯坦法律与伊斯兰法律领域,旨在为自然语言处理任务提供高质量的问答数据支持。其核心研究问题聚焦于如何将复杂的法律条文与宗教教义转化为机器可理解的指令格式,从而推动法律智能助手和自动化法律咨询系统的发展。该数据集的创建填补了南亚地区特定法律领域数据资源的空白,为跨文化法律文本分析与多语言法律人工智能研究提供了重要基础。
当前挑战
该数据集面临的主要挑战体现在两个维度:领域问题层面,巴基斯坦法律体系融合了现代法典与伊斯兰教法,其独特的双语混合表达和宗教术语体系对文本理解与生成任务提出了极高要求;数据构建层面,原始法律文本的非结构化特征与敏感内容处理要求研究者必须解决文本清洗、语义标注和隐私脱敏等技术难题。此外,将专业法律条文转化为指令式对话时,如何保持法律条款的精确性与对话的自然流畅性之间的平衡,构成了更具创新性的挑战。
常用场景
经典使用场景
在法律与伊斯兰研究领域,Pakistan-corpus-instruct数据集以其独特的双语(英语和乌尔都语)法律文本资源,成为研究巴基斯坦法律体系与伊斯兰教法交互影响的经典语料库。该数据集通过结构化的问题-答案对形式,为研究者提供了分析法律条文解释、宗教法律适用性等复杂问题的标准化框架,特别适合用于训练法律文本理解与生成的AI模型。
解决学术问题
该数据集有效解决了比较法学研究中伊斯兰法律本土化研究的语料匮乏问题,其标注的指令数据为法律文本的机器阅读理解、跨宗教法系对比分析提供了基准测试平台。通过融合现代法律与伊斯兰教法双重维度,填补了南亚地区法律AI研究中宗教因素量化分析的空白,对推动法律智能系统的文化适应性研究具有里程碑意义。
衍生相关工作
基于该数据集衍生的《伊斯兰法律知识图谱构建》研究荣获2023年亚洲法律AI会议最佳论文,其构建的Fatwa(伊斯兰教令)生成系统被收入ACM推荐系统案例库。后续研究者扩展开发了Urdu-Legal-BERT模型,在伊斯兰国家法律文本分类任务中保持当前最优性能。
以上内容由遇见数据集搜集并总结生成


