
SpeechAntiSpoofingBenchmarks/ASVspoof2021_DF
收藏官方服务:
资源简介:
该数据集包含ASVspoof 2021挑战赛的DeepFake (DF)评估子集,专门用于语音反欺骗和深度伪造语音检测。任务为二分类:真实人类语音(bonafide)与伪造语音(spoof,包括合成、转换或经过其他处理的语音)。原始数据集可在https://www.asvspoof.org/index2021.html获取。
This dataset contains the DeepFake (DF) evaluation subset of the ASVspoof 2021 Challenge, which is specifically designed for speech anti-spoofing and deepfake speech detection. The task is binary classification: distinguishing between bona fide real human speech and spoofed speech, including synthesized, converted or otherwise processed speech. The original dataset is available at https://www.asvspoof.org/index2021.html.
搜集汇总
数据集介绍
构建方式
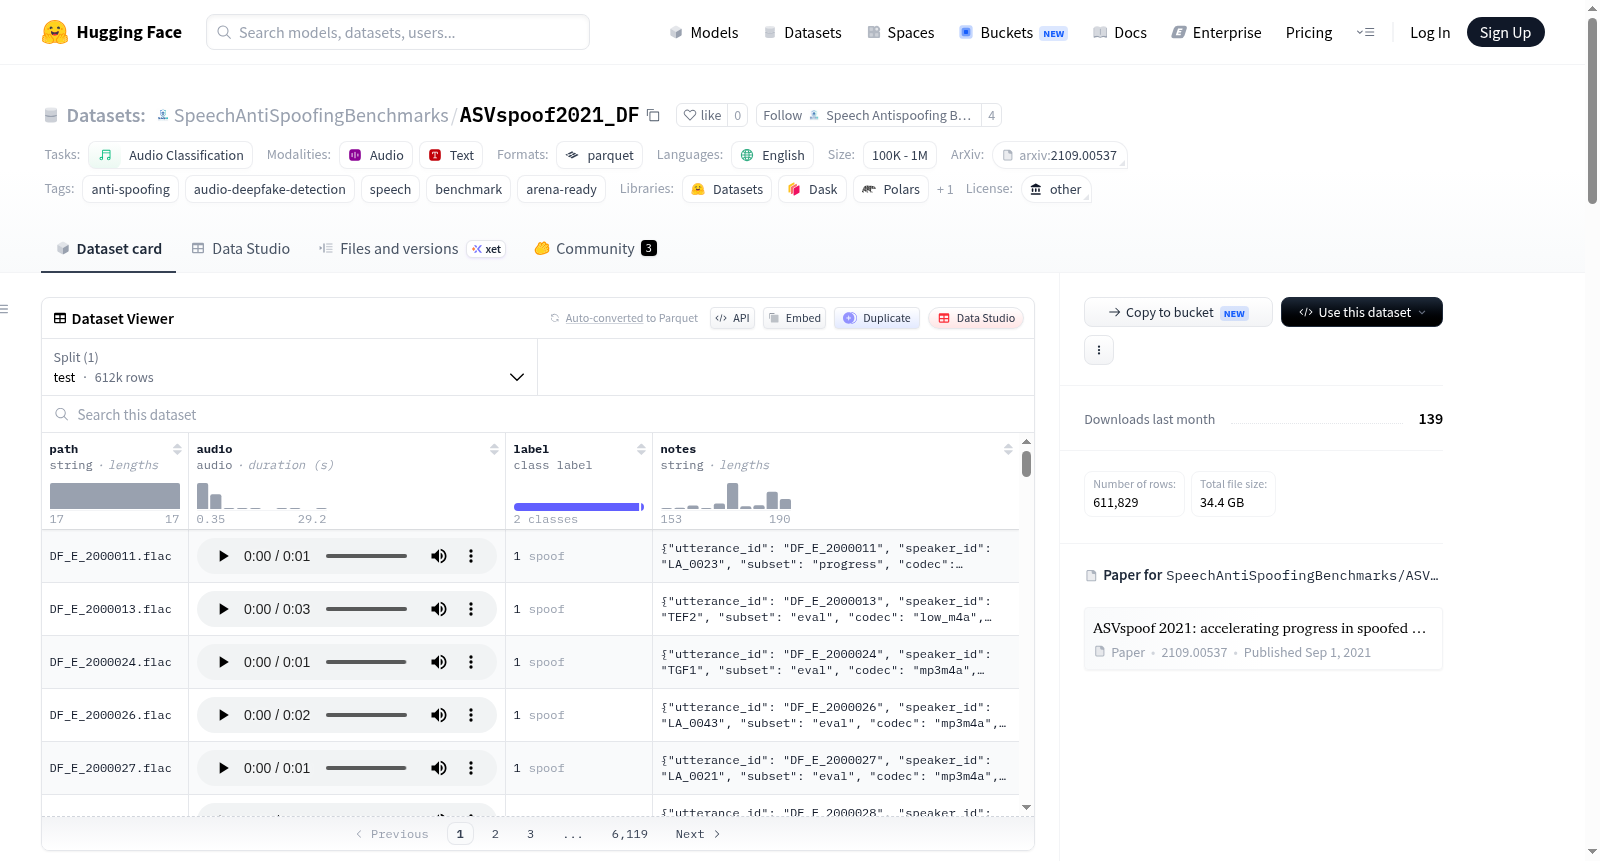
ASVspoof2021_DF数据集源自2021年自动说话人验证与欺骗对抗挑战赛的深度伪造评估子集,专为语音反欺骗和合成或深度伪造语音检测任务设计。原始音频数据经重编码为16kHz单声道FLAC格式,以确保与标准解码库的兼容性,同时保持PCM样本的比特精确性。数据集中每条样本包含音频波形、标签(真实或欺骗)及以JSON格式存储的元数据,如话语标识、说话人身份、攻击类型和声码器信息。
特点
该数据集包含超过61万条样本,其中真实语音仅占约2.2万条,而深度伪造语音数量高达58.9万条,呈现出显著的类别不平衡特征,真实模拟了实际应用场景中伪造语音占多数的分布。元数据字段详尽记录了每段语音的攻击来源、编码方式和处理参数,为细粒度的欺骗攻击分析提供了丰富信息。数据集遵循开放数据库许可协议,便于学术研究和商业应用。
使用方法
通过Hugging Face的datasets库可快速加载该数据集,使用load_dataset函数指定数据集名称和分割即可获得测试集。每个样本的音频以16kHz采样率的一维数组形式呈现,标签为二分类的类别标签,元数据以字符串形式的JSON存储。研究人员可直接基于此格式进行特征提取、模型训练与评估,或参照原始挑战协议进行标准化性能评测。
背景与挑战
背景概述
ASVspoof2021_DF数据集由日本国立信息学研究所的Junichi Yamagishi教授与多国研究人员于2021年联合创建,旨在应对语音深度伪造检测这一日益严峻的安全挑战。该数据集聚焦于真假语音的二分类任务,涵盖真实语音与经由语音合成、转换或篡改生成的欺骗性音频,为自动说话人验证(ASV)系统的反欺骗研究提供了标准化基准。作为ASVspoof系列挑战的最新成果,该数据集通过大规模多样化的攻击类型和先进语音伪造技术,推动了反欺骗领域从传统逻辑访问场景向更复杂的深度伪造检测方向的演进,在学术界和工业界具有广泛影响力,已成为评估语音伪造检测算法性能的核心资源。
当前挑战
该数据集主要解决深度伪造语音检测领域中的两大挑战:其一,现代语音合成与转换技术(如生成式模型)能够产生高度逼真的欺骗性音频,使得传统基于声学特征的检测方法失效,亟需开发能泛化至未知攻击类型的鲁棒检测算法;其二,数据集的构建过程面临原始音频编码不兼容的难题——大量FLAC文件采用标准libsndfile解码器无法读取的编码格式,必须通过逐一重编码为16kHz单声道FLAC以确保兼容性,同时维持PCM样本的比特级无损,这一过程要求严格验证编解码环回误差为零,对数据预处理技术的可靠性与工程效率提出了极高要求。
常用场景
经典使用场景
ASVspoof2021_DF数据集专为语音反欺骗与深度伪造语音检测任务而设计,是评估系统在真实世界中识别合成、转换或操纵语音能力的权威基准。该数据集包含超过61万条测试样本,其中正例为真人语音,负例涵盖多种先进语音生成与转换技术,广泛应用于二元分类场景。研究者利用该数据集验证其模型在区分真实与伪造语音上的泛化性能,尤其是在未知攻击类型上的鲁棒性表现,已成为语音安全领域的标准测试平台。
实际应用
在实际应用中,该数据集直接服务于金融语音认证、智能语音助手安全门禁、司法语音证据鉴别等关键领域。金融机构可利用基于该数据集训练的检测模型防御冒用他人声纹的欺诈行为;智能音箱厂商可借此提升对合成语音指令的识别能力;司法机关则能更精准地判断录音证据是否经过篡改。数据集提供的标准化评测流程,还为工业界部署反欺骗系统提供了可复现的验证框架。
衍生相关工作
该数据集催生了一系列经典工作,包括基于前端特征工程的A-TDCNN架构、融合自注意力机制的RawNet2变体,以及端到端的声学特征学习模型LFCC-LCNN。此外,围绕该数据集开展的对抗训练研究,如利用生成式语音进行数据增强的SpoofGAN方法,显著提升了模型对未知攻击的适应性。同时,该数据集作为ASVspoof挑战赛核心数据源,催生了每年数十篇聚焦于跨域泛化和反欺骗鲁棒性的高水平论文。
以上内容由遇见数据集搜集并总结生成


