
遇见数据集

csuhan/OneLLM_InstructionTuning

收藏
Hugging Face2024-03-08 更新2024-06-22 收录
官方服务:

资源简介:

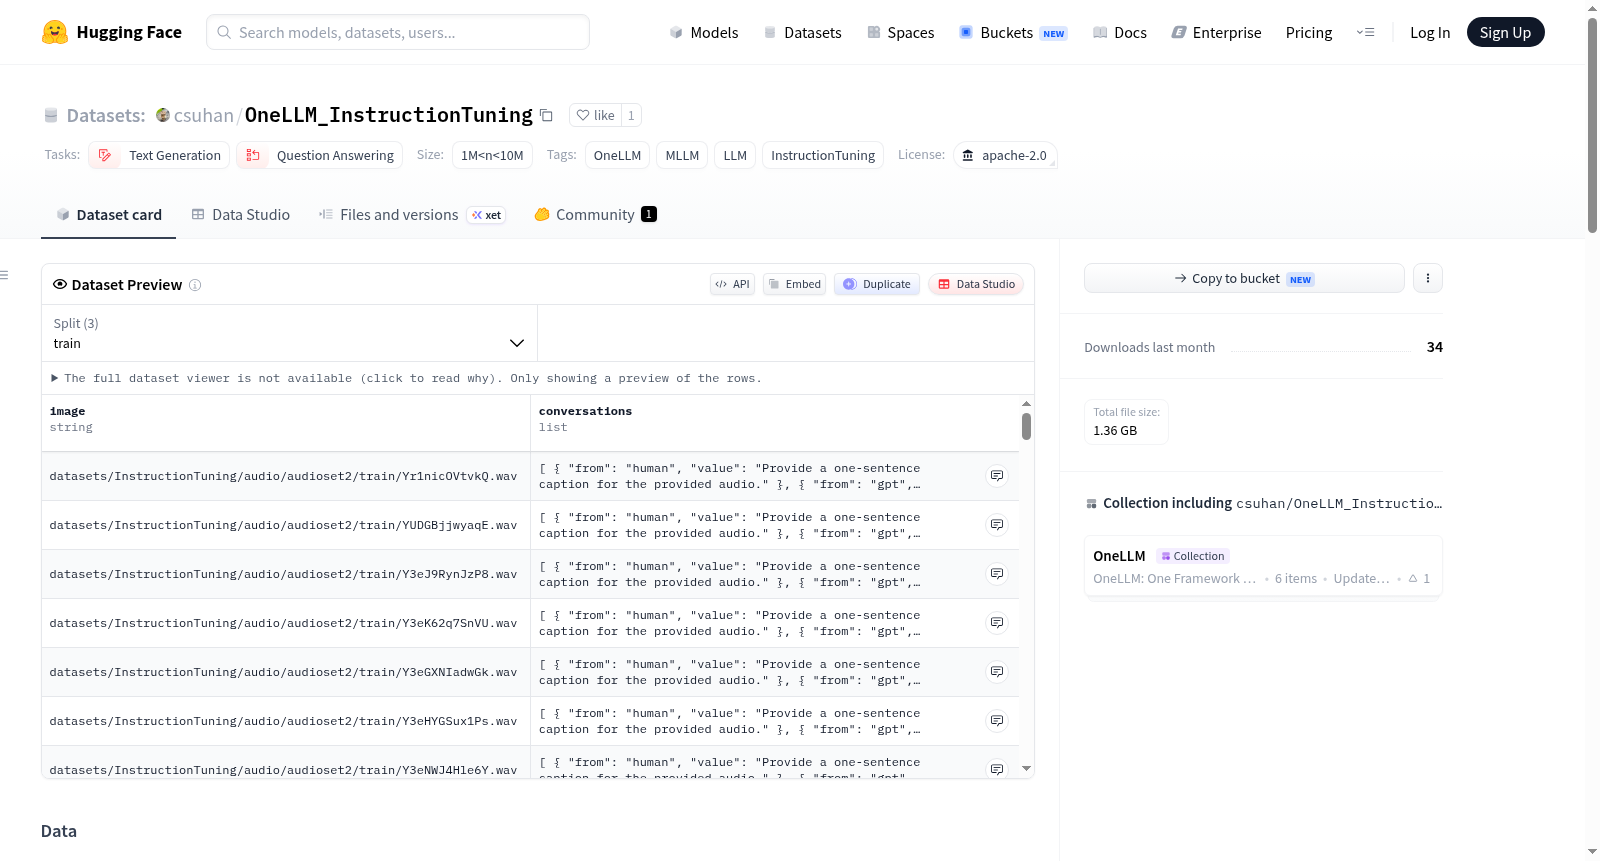
该数据集被转换为多轮对话格式,每个样本包含`id`、`image`和`conversations`等键。数据集涵盖了多种模态,包括图像、视频、音频、点云、深度图、法线图、IMU数据和fMRI数据。这些数据用于预训练和指令微调任务。下载链接部分提供了不同模态数据集的下载地址,指令微调数据部分详细说明了如何下载和存储这些数据。

该数据集被转换为多轮对话格式,每个样本包含`id`、`image`和`conversations`等键。数据集涵盖了多种模态,包括图像、视频、音频、点云、深度图、法线图、IMU数据和fMRI数据。这些数据用于预训练和指令微调任务。下载链接部分提供了不同模态数据集的下载地址,指令微调数据部分详细说明了如何下载和存储这些数据。

提供机构:
csuhan
原始信息汇总

数据集概述

数据格式

所有微调数据被转换为多轮对话格式。.json文件包含一系列训练样本,每个样本包含以下键:idimageconversations。例如: json {id: 000000033471, image: InstructionTuning/image/coco/train2017/000000033471.jpg, conversations: [{from: human, value: What are the colors of the bus in the image?}, {from: gpt, value: The bus in the image is white and red.}, {from: human, value: What feature can be seen on the back of the bus?}, {from: gpt, value: The back of the bus features an advertisement.}]}

下载链接

阶段 预训练 下载链接 指令微调 下载链接
模态 数据集 LAION-400M LLaVA-mix665K link
图像 LAION-COCO link COCO Caption link
视频 WebVid-2.5M link MSRVTT Caption link
MSRVTT-QA link
Video Conversation link
音频 WavCaps link AudioCaps link
Audio Conversation link
点云 Cap3D link Point Conversation link
深度图 CC3M link LLaVA-150K link
法线图 CC3M link LLaVA-150K link
IMU Ego4D link Ego4D link
fMRI NSD link NSD link

指令微调数据

注释下载: 请下载注释并将它们放在datasets/InstructionTuning目录下。

然后从上表下载原始数据集,并将它们放在相应的文件夹中。文件结构应如下:

datasets └── InstructionTuning ├── audio │ ├── audioset2 │ ├── audiocap_train.json │ ├── audiocap_val.json │ └── audio_conversation.json ├── depth_normal │ ├── depth │ ├── normal │ ├── llava_instruct_50k_depth.json │ └── llava_instruct_50k_normal.json ├── fmri │ ├── NSD │ └── fmri_fixed_train.json ├── image │ ├── coco │ ├── gqa │ ├── ocr_vqa │ ├── vg │ ├── cococap_train.json │ ├── llava_v1_5_mix665k_image.json │ └── llava_v1_5_mix665k_text.json ├── imu │ ├── ego4d │ └── imu_fixed_50k.json ├── point │ ├── pointllm/8192_npy │ └── pointllm_70k.json └── video ├── msr-vtt/MSR-VTT ├── msrvtt_cap_test.json ├── msrvtt_cap_trainval.json ├── msrvtt_vqa_test.json ├── msrvtt_vqa_train.json ├── msrvtt_vqa_val.json ├── video_complex_reasoning_10k.json ├── video_conversation_10k.json └── video_detail_10k.json
搜集汇总
数据集介绍
csuhan/OneLLM_InstructionTuning 数据集图片
构建方式
在视觉与语言模型研究的前沿领域,指令微调数据集的质量直接决定了多模态大模型的泛化能力。csuhan/OneLLM_InstructionTuning数据集通过整合图像、视频、音频、点云、深度图、法线图、IMU及fMRI等八种模态的异构数据,构建了一个统一的多轮对话格式的指令微调资源。其构建过程首先从公开数据源(如LAION-400M、WebVid-2.5M、WavCaps等)采集原始素材,随后将各模态数据转化为标准化的多轮对话结构,每条样本包含唯一标识符、对应模态文件路径及人类与模型交替的问答序列。此外,深度与法线图由预训练DPT模型从CC3M和LLaVA-150K子集中生成,IMU数据则经专门脚本预处理,最终形成层次分明的文件目录体系,确保不同模态数据的便捷调用与一致性管理。
特点
该数据集的核心特色在于其前所未有的模态多样性与统一表征能力。它突破了传统视觉语言数据集仅覆盖图像与文本的局限,首次将点云、IMU信号、fMRI脑成像等非视觉模态纳入指令微调框架,为多模态大模型提供了跨越感知边界的学习素材。所有数据均采用一致的多轮对话格式,消除了异构数据在结构上的差异,使模型能够自然习得跨模态推理与交互能力。同时,数据规模宏大,涵盖百万级训练样本,且每个模态均包含预训练与指令微调两阶段资源,这种双重配置支持模型从基础对齐到复杂任务理解的渐进式学习。此外,数据集对深度、法线等衍生模态采用生成式预处理,展现了其在高阶空间特征学习上的前瞻性设计。
使用方法
使用该数据集时,研究者需首先从提供的链接下载各原始数据集及对应的标注文件,并按照指定的目录结构将文件存放于datasets/InstructionTuning路径下。随后,通过加载JSON格式的对话数据,即可将多模态样本输入模型进行训练。每条样本的image字段指向具体模态文件,而conversations列表则包含人类提问与模型回答的交替序列,可直接用于序列到序列的指令微调范式。值得注意的是,对于视频、音频等时序模态,数据已预组织为问答对形式,便于直接适配至现有的大语言模型框架。用户可依据实际任务需求,选择特定模态的子集进行训练,或利用全部八种模态实现统一的跨模态对齐与推理能力提升。
背景与挑战
背景概述
多模态大语言模型(MLLM)的飞速发展催生了对统一、高质量指令微调数据的迫切需求。在此背景下,由学术界研究团队构建的OneLLM_InstructionTuning数据集应运而生,旨在为跨模态的指令跟随能力提供系统性训练资源。该数据集整合了图像、视频、音频、点云、深度图、法线图、IMU及fMRI等八种模态的数据,覆盖了从LAION-400M、WebVid-2.5M到WavCaps、Cap3D等广泛来源,并通过统一的多轮对话格式进行组织。其核心研究问题在于如何构建一个通用且可扩展的指令微调框架,以支持多模态理解与生成任务。自发布以来,该数据集为OneLLM等统一多模态模型提供了关键的训练基础,推动了多模态人工智能从单一模态向融合感知的范式转变,在学术界与工业界均产生了深远影响。
当前挑战
该数据集所面临的挑战首先体现在多模态数据源的异构性与规模差异上。不同模态的数据在格式、标注粒度与语义分布上迥异,例如,图像数据可依赖COCO Caption等成熟标注,而IMU与fMRI数据则需从Ego4D、NSD等专业项目中提取并预处理,导致数据对齐与融合过程极为复杂。其次,构建过程中需解决指令格式的统一性问题,将问答、描述、推理等多样化任务转化为多轮对话形式,这要求设计精细的转换模板以避免语义失真。此外,数据集的规模达到百万级,如何平衡各模态样本量以防止模型偏向高频模态,以及确保来自不同源数据的质量一致性(如音频与点云数据的噪声控制),均是构建过程中的核心难题。这些挑战共同决定了数据集在多模态指令微调领域的实用性与泛化能力。
常用场景
经典使用场景
在视觉与语言多模态研究的浪潮中,指令微调数据集成为连接大规模预训练模型与下游任务的关键纽带。OneLLM_InstructionTuning数据集以其独特的多轮对话格式,将图像、视频、音频、点云、深度图、法线图、IMU信号乃至fMRI脑成像数据统一转化为结构化对话样本。这一设计使得单一模型能够在跨模态指令理解与生成任务上实现统一训练,为多模态大语言模型(MLLM)的泛化能力提供了坚实的基准。经典使用场景涵盖视觉问答、视频描述、音频理解、点云识别等多模态交互任务,研究者可基于此数据集系统性地评估模型在异构感知输入下的指令跟随能力。
实际应用
在现实世界部署中,OneLLM_InstructionTuning数据集赋能了一系列高价值应用场景。例如,在智能驾驶领域,模型可同时处理摄像头图像、激光雷达点云与IMU惯性数据,实现环境感知与驾驶指令的实时交互;在医疗影像分析中,结合fMRI脑信号与视觉描述,辅助医生进行神经疾病诊断;在工业机器人领域,融合深度图与法线图信息,提升物体抓取与操作任务的精度。此外,该数据集还支持无障碍技术开发,如将音频场景描述转化为文字反馈,服务于听障人士的日常生活。这些应用充分体现了多模态指令微调在提升人机交互自然性与系统适应性方面的实用价值。
衍生相关工作
基于OneLLM_InstructionTuning数据集,学术界涌现出一系列具有里程碑意义的研究工作。其中,OneLLM统一框架首次证明了在单一模型中同时处理图像、视频、音频、点云、深度图、法线图、IMU与fMRI八种模态的可行性,为多模态基础模型的设计提供了新范式。后续工作如PointLLM通过引入点云对话数据,实现了三维场景下的细粒度指令理解;ChatBridge则利用该数据集中的视频与音频对话样本,探索了跨模态时序推理机制。此外,该数据集还被用于分析指令微调中数据规模与模态多样性对模型泛化性能的影响,催生了关于多模态数据混合策略的系列研究,显著推动了多模态预训练领域的发展。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

