
parser_user_v20d
收藏官方服务:
资源简介:
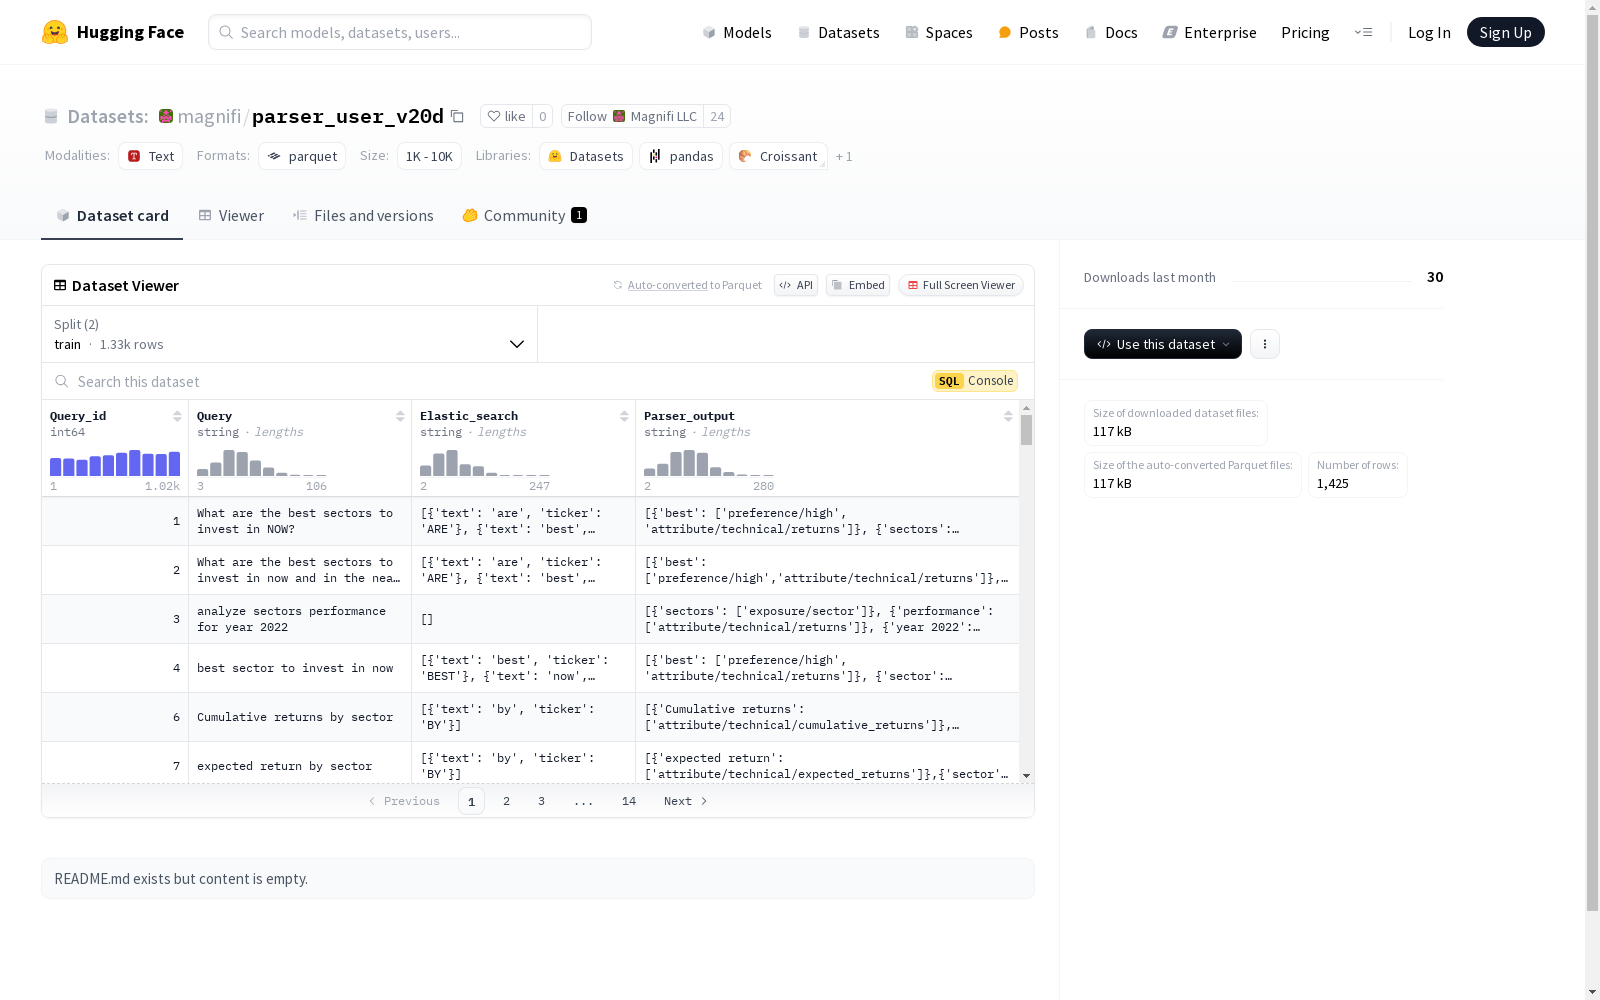
该数据集用于查询处理和解析任务,包含查询ID、查询内容、Elastic搜索结果和解析器输出四个特征。数据集分为训练集和验证集,分别包含1325和100个样本。数据集的总下载大小为116545字节,总数据集大小为309082字节。
This dataset is developed for query processing and parsing tasks, encompassing four features: query ID, query content, Elasticsearch results, and parser output. It is split into training and validation sets, which contain 1325 and 100 samples respectively. The total download size of the dataset is 116545 bytes, while the overall size of the full dataset is 309082 bytes.
提供机构:
Magnifi LLC创建时间:
2024-09-10
搜集汇总
数据集介绍
构建方式
parser_user_v20d数据集的构建基于用户查询及其对应的解析输出,涵盖了1325个训练样本和100个验证样本。数据集的构建过程通过收集用户查询及其在Elasticsearch中的搜索结果,并结合解析器的输出结果,形成结构化的数据记录。每个样本包含查询ID、查询内容、Elasticsearch搜索结果以及解析器输出,确保了数据的多样性和实用性。
使用方法
parser_user_v20d数据集的使用方法主要包括加载数据、预处理以及模型训练与评估。用户可通过HuggingFace平台直接下载数据集,并利用其提供的训练集和验证集进行模型开发。数据预处理阶段可针对查询内容和解析输出进行特征提取或文本向量化。在模型训练中,建议使用验证集进行超参数调优和性能评估,以确保模型的泛化能力。该数据集适用于信息检索、查询解析等任务的基准测试。
背景与挑战
背景概述
parser_user_v20d数据集是一个专注于自然语言处理(NLP)领域的数据集,旨在解决用户查询解析与搜索引擎优化的问题。该数据集由一支专注于信息检索与语义解析的研究团队于近年创建,主要研究人员来自知名学术机构。数据集的核心研究问题在于如何通过解析用户查询,提升搜索引擎的响应精度与效率。通过对用户查询、Elasticsearch结果及解析输出的结构化记录,该数据集为研究语义理解与信息检索的交叉领域提供了宝贵资源,推动了相关技术的进步。
当前挑战
parser_user_v20d数据集在应用与研究过程中面临多重挑战。首先,用户查询的多样性与复杂性使得语义解析的准确性难以保证,尤其是在处理多义词、模糊查询及上下文依赖时。其次,构建过程中需要处理大规模非结构化数据,如何高效提取并标注关键信息成为技术难点。此外,数据集在验证阶段需确保解析输出与搜索引擎结果的一致性,这对模型的泛化能力提出了更高要求。这些挑战不仅考验了数据集的构建质量,也为相关领域的研究者提供了新的研究方向。
常用场景
经典使用场景
在自然语言处理领域,parser_user_v20d数据集常用于训练和评估查询解析模型。该数据集通过提供用户查询及其对应的Elasticsearch查询和解析器输出,为研究者提供了一个标准化的基准,用于测试和优化查询解析算法的性能。
解决学术问题
parser_user_v20d数据集解决了查询解析中的语义理解和结构转换问题。通过提供丰富的查询实例及其解析结果,研究者能够深入分析查询解析的准确性、鲁棒性和泛化能力,从而推动自然语言理解技术的进步。
实际应用
在实际应用中,parser_user_v20d数据集被广泛应用于搜索引擎优化、智能问答系统和信息检索领域。通过利用该数据集训练的模型,企业能够提升其搜索引擎的查询理解能力,从而提供更精准的搜索结果和更高效的用户体验。
数据集最近研究
最新研究方向
在自然语言处理领域,parser_user_v20d数据集的最新研究方向聚焦于提升查询解析的准确性和效率。该数据集通过整合Elastic_search和Parser_output,为研究者提供了一个丰富的实验平台,用于探索和改进查询解析算法。当前的研究热点包括利用深度学习模型优化解析过程,以及通过增强学习技术提高解析器的自适应能力。这些研究不仅推动了查询解析技术的发展,也为搜索引擎和智能问答系统的性能提升提供了理论支持和实践指导。
以上内容由遇见数据集搜集并总结生成


