
kimmchii/translated-th-flickr30k
收藏官方服务:
资源简介:
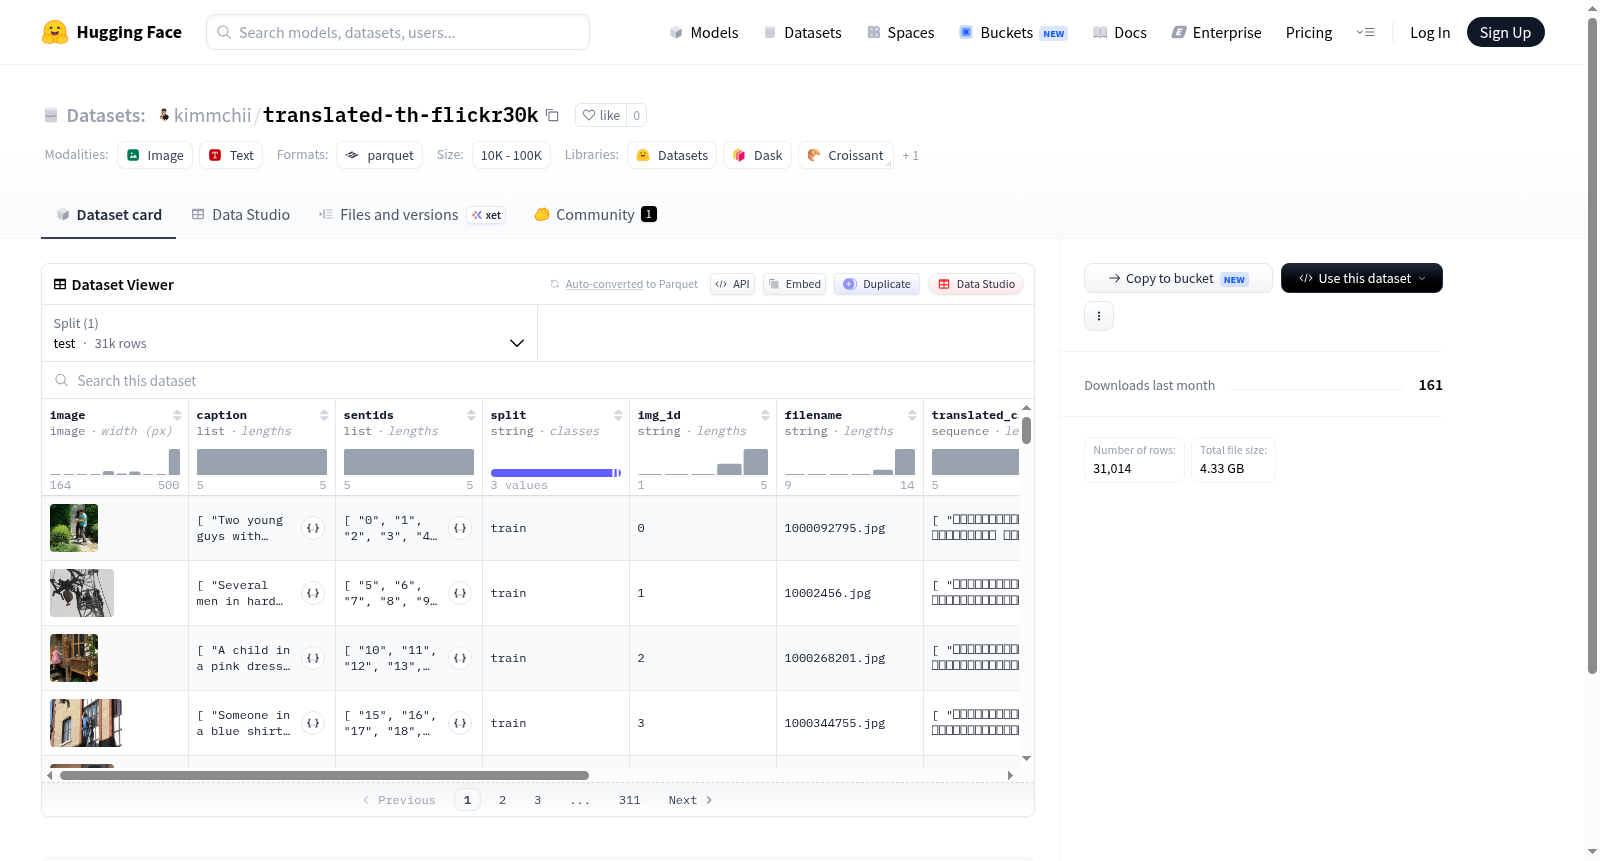
该数据集包含图像及其相关标题、句子ID、分割类型、图像ID、文件名以及通过HelsinkiTranslator、NLLBTranslator和VistecTranslator翻译的标题。数据集仅包含一个测试分割,包含31014个示例,下载大小为4331206428字节,数据集大小为4394903218.86字节。
This dataset contains images with their associated captions, sentence IDs, split types, image IDs, filenames, as well as captions translated by HelsinkiTranslator, NLLBTranslator, and VistecTranslator. The dataset only includes one test split, which contains 31014 examples. Its download size is 4331206428 bytes, and the total dataset size is 4394903218.86 bytes.
提供机构:
kimmchii原始信息汇总
数据集概述
数据特征
- image: 图像数据
- caption: 字符串列表
- sentids: 字符串列表
- split: 字符串
- img_id: 字符串
- filename: 字符串
- translated_caption_HelsinkiTranslator: 字符串序列
- translated_caption_NLLBTranslator: 字符串序列
- translated_caption_VistecTranslator: 字符串序列
数据分割
- test:
- 字节数: 4394903218.86
- 样本数: 31014
数据集大小
- 下载大小: 4331206428
- 数据集大小: 4394903218.86
配置
- default:
- 数据文件路径: data/test-*
搜集汇总
数据集介绍
构建方式
在跨语言视觉语义理解的研究中,多语言图像描述数据集扮演着不可或缺的角色。kimmchii/translated-th-flickr30k数据集基于经典的Flickr30k数据集构建,通过引入泰语翻译扩展了其语言覆盖范围。具体而言,研究者保留了原始图像及其英文描述,并采用三种不同的神经机器翻译系统——Helsinki Translator、NLLB Translator和Vistec Translator,将英文描述分别翻译为泰语,从而生成多源翻译版本。这一构建方式不仅确保了图像内容的一致性,还通过多翻译器的并行应用,为后续研究提供了对比不同翻译质量与风格的宝贵资源。
使用方法
使用该数据集时,研究者可直接通过HuggingFace Datasets库加载,指定配置为'default'并访问'test'分割。数据以图像与文本对的形式组织,其中'image'字段提供图像数据,'caption'字段包含原始英文描述,而三个以'translated_caption_'开头的字段则分别对应不同翻译器的泰语输出。用户可根据研究目标灵活选择翻译来源,例如评估特定翻译系统的性能,或融合多源翻译以提升鲁棒性。此外,'sentids'与'img_id'字段便于进行细粒度的跨模态检索与匹配实验。
背景与挑战
背景概述
在自然语言处理与计算机视觉交叉领域中,图像描述生成任务长期受限于多语言资源的匮乏。泰语作为使用人数众多的语言,其在视觉-语言数据集中的代表性严重不足。kimmchii/translated-th-flickr30k数据集应运而生,它基于经典的Flickr30k英文图像描述数据集,由研究团队通过多种机器翻译引擎(包括Helsinki、NLLB和Vistec翻译器)将英文描述转化为泰语,构建了一个包含超过31000条测试样本的泰语图像描述数据集。该数据集的核心研究问题在于评估不同翻译引擎在视觉语言任务上的表现差异,并为低资源语言的图像理解研究提供基准。该数据集的发布为泰语多模态研究提供了重要资源,推动了跨语言视觉语义理解的发展。
当前挑战
该数据集面临多重挑战。首先,在领域问题层面,泰语图像描述生成任务本身缺乏大规模高质量标注数据,现有模型多依赖英文预训练,跨语言迁移时面临严重的语义鸿沟和语法结构差异。其次,构建过程中,机器翻译的准确性成为关键瓶颈,不同翻译引擎(如Helsinki、NLLB、Vistec)生成的泰语描述在词汇选择、句式流畅度和文化适应性上存在显著差异,缺乏人工校验可能导致噪声累积。此外,原始Flickr30k的英文描述具有文化特异性,直接翻译可能丢失上下文隐含信息或引入不合语境的表达,这对下游模型训练和评估构成了严峻挑战。
常用场景
经典使用场景
在跨语言视觉语义理解的研究领域中,kimmchii/translated-th-flickr30k数据集为多模态语言模型的跨语言迁移学习提供了宝贵的资源。该数据集基于经典的Flickr30k图像描述语料库,通过多种机器翻译引擎将英文描述转化为泰语,形成了包含原始图像、英文描述以及三种不同翻译引擎生成的泰语描述的多层次结构。研究者可借此探索图像与泰语文本之间的语义对齐关系,评估不同翻译质量对视觉-语言联合表示的影响,从而推动低资源语言在多模态任务中的表现提升。
解决学术问题
该数据集核心解决了泰语在视觉-语言跨模态研究中数据匮乏的学术困境。传统Flickr30k等基准数据集主要面向英语,导致泰语等多语言场景下的图像描述生成、跨语言检索等任务缺乏标准评估平台。通过提供大规模、多源翻译的泰语描述,数据集使研究者能够系统比较不同翻译策略对下游任务的影响,揭示机器翻译误差在跨模态语义理解中的传播机制,为构建鲁棒的多语言视觉语言模型奠定了实验基础。
实际应用
在实际应用层面,该数据集可直接服务于泰语地区的智能图像检索系统、多语言社交媒体内容理解以及辅助视障人士的泰语图像描述工具开发。例如,电商平台可利用该数据集训练模型自动为泰语用户生成产品图片的本地化描述,旅游应用可基于图像内容提供泰语导览信息。此外,数据集的多翻译来源特性可帮助开发者评估不同翻译服务在视觉场景下的适用性,从而优化实际部署中的翻译引擎选择策略。
数据集最近研究
最新研究方向
在跨语言多模态理解的前沿探索中,kimmchii/translated-th-flickr30k数据集应运而生,它基于经典的Flickr30k基准,通过集成Helsinki、NLLB及Vistec三种先进翻译引擎提供的泰语字幕,构建了一个面向低资源语言场景的图像描述翻译语料库。当前,该数据集正推动视觉与语言模型在泰语环境下的零样本与少样本学习研究,尤其关注神经机器翻译与多模态对齐的协同优化。随着东南亚数字生态的蓬勃发展,这一资源为打破语言壁垒、促进区域文化内容的智能检索与生成提供了关键支撑,其影响力延伸至跨语种视觉问答、自动字幕生成及多模态对话系统等热点应用,显著增强了模型在非英语语境下的泛化能力与鲁棒性。
以上内容由遇见数据集搜集并总结生成


