
atlasia/english-to-darija-arabic-script-formatted
收藏官方服务:
资源简介:
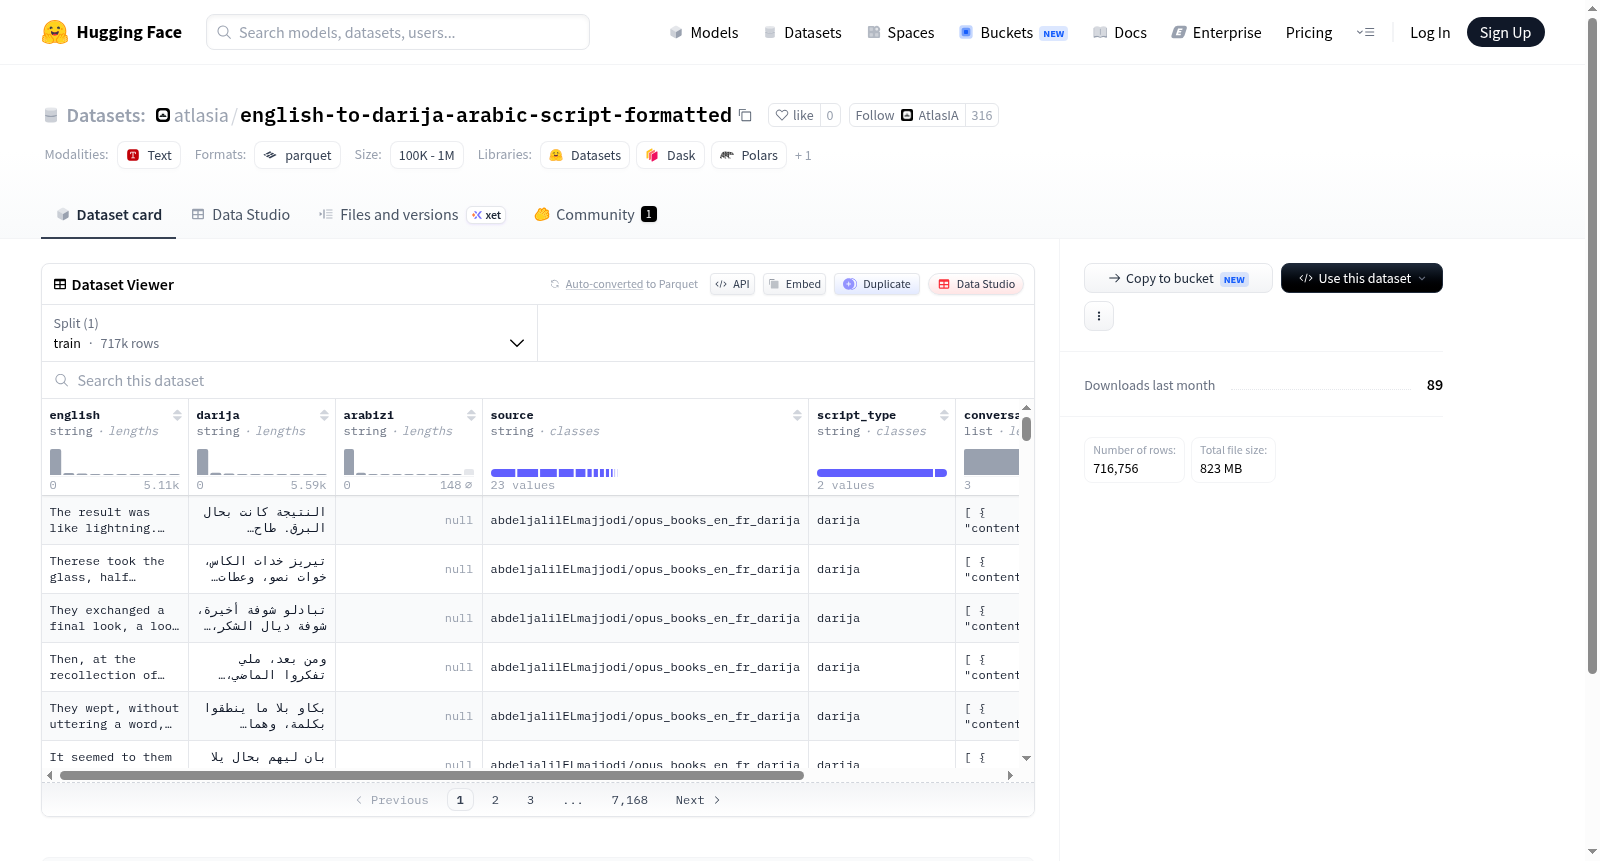
这是一个多语言数据集,包含英语、摩洛哥阿拉伯语(Darija)和阿拉伯语罗马化文本(Arabizi)的字段,可能用于翻译或对话任务。数据集中还包括来源、脚本类型、对话内容(包含角色和内容)以及文本字段。数据集提供训练分割,共716,756个示例,总大小约2.04 GB,用于支持自然语言处理应用。
This is a multilingual dataset containing fields for English, Moroccan Arabic (Darija), and Arabizi (Arabic romanized text), likely intended for translation or dialogue tasks. The dataset also includes source, script type, conversations (with role and content), and text fields. It provides a train split with 716,756 examples and a total size of approximately 2.04 GB, designed to support natural language processing applications.
提供机构:
atlasia搜集汇总
数据集介绍
构建方式
该数据集名为english-to-darija-arabic-script-formatted,专注于英语与摩洛哥阿拉伯语(Darija)之间的翻译任务,同时涵盖阿拉伯语拉丁转写(Arabizi)形式。构建方式基于大规模平行语料采集与清洗,原始数据经过对齐、过滤和格式化处理,最终形成包含英语、Darija、Arabizi、来源标签、脚本类型以及多轮对话结构(conversations字段)的规范化数据。每条样本均保留完整的双语对照文本和元信息,以JSON格式存储,便于直接用于序列到序列模型的训练与评估。
特点
该数据集的核心特点在于其多模态的语言表征:不仅提供标准阿拉伯字母书写的Darija,还包含拉丁转写的Arabizi,覆盖了摩洛哥地区最常用的两种书写形式。同时,数据附带来源(source)和脚本类型(script_type)字段,便于研究者分析不同数据来源与书写风格对翻译质量的影响。此外,conversations字段按照角色(role)和内容(content)组织,支持多轮对话场景下的翻译任务,增强了数据在对话系统与指令微调中的适用性。训练集包含716,756个样本,总字节数超过2GB,规模庞大且质量可靠。
使用方法
使用时,可直接通过HuggingFace的datasets库加载该数据集,指定config_name为'default'并读取训练集(train)分片。每条数据包含'english'、'darija'、'arabizi'等文本字段,可直接作为翻译模型的输入-输出对。对于对话式应用,可利用'conversations'字段按角色轮次构建序列,配合指令微调框架(如ChatML格式)进行训练。此外,脚本类型和来源标签可用于过滤数据子集,例如仅保留纯阿拉伯字母样本或特定来源的数据,以适配不同的研究场景。下载大小为823MB,适合在单机或分布式环境下使用。
背景与挑战
背景概述
该数据集名为english-to-darija-arabic-script-formatted,专注于摩洛哥阿拉伯语(Darija)与英语之间的机器翻译任务,特别涵盖了Darija的阿拉伯文字体与拉丁转写体(Arabizi)两种书写形式。该数据集由Hugging Face社区贡献者整理创建,旨在解决北非地区低资源语言在神经机器翻译领域的数据匮乏问题。数据集包含约71.7万条训练样本,每条记录包括英语句子、Darija的阿拉伯文翻译及其Arabizi转写,并标注了数据来源与书写类型。作为首个大规模、多脚本对齐的英语-Darija平行语料库,它为阿拉伯语方言处理、跨文字系统翻译以及低资源语言的自然语言处理研究提供了重要基准,推动了相关领域模型性能的评估与改进。
当前挑战
该数据集所应对的核心领域挑战在于低资源语言机器翻译的固有困境:摩洛哥Darija作为非标准化的阿拉伯语口语方言,缺乏统一的拼写规则与大规模标注语料,传统统计方法与神经模型均难以有效建模。此外,Darija同时存在阿拉伯文和Latin转写的Arabizi两种书写系统,而现有翻译系统多针对单一文字设计,难以处理输入脚本的多样化与混合使用。数据构建过程中面临的挑战包括:从社交媒体、口语对话等非正式渠道收集高质量双语对齐句子,人工标注中处理同音字、俚语与外来词的多义性,以及确保Arabizi转写的一致性与标准化,这些均对数据质量与模型鲁棒性提出了严苛要求。
常用场景
经典使用场景
该数据集专门服务于英语与摩洛哥阿拉伯语(Darija)之间的机器翻译任务,尤其聚焦于将Darija的阿拉伯字母书写形式(阿拉伯文脚本)与拉丁字母转写形式(Arabizi)进行系统化对齐。由于Darija作为一种口语化方言,在书面语中常混用阿拉伯字母和拉丁字母,传统翻译模型难以统一处理。该数据集通过提供三列平行语料(英语、Darija、Arabizi),为构建多脚本翻译系统奠定了坚实基础,成为研究低资源方言机器翻译的经典基准。
实际应用
在实际应用中,该数据集可驱动摩洛哥地区的实时翻译服务,例如在旅游导览、跨境电商客服、医疗问诊等场景中,帮助阿拉伯语标准语使用者与Darija使用者之间实现高效沟通。基于该数据集训练的翻译模型,还能嵌入手机键盘预测、社交媒体内容过滤等功能,自动识别并转写Arabizi形式的Darija文本,提升本地化应用的可用性。此外,该数据集的脚本感知能力对多语言语音助手和移民社区信息服务具有重要的落地价值。
衍生相关工作
基于该数据集,学术界已衍生出多项经典工作:有研究对比了Transformer模型在单一脚本与多脚本数据下的翻译质量差异,提出了脚本自适应注意力机制;亦有团队利用该数据集的对话结构(conversations字段),构建了面向Darija的问答系统与任务型对话模型。更值得关注的是,部分工作将该数据集与大规模多语言模型(如M2M-100、NLLB)结合,针对低资源方言进行微调,显著提升了少样本翻译中Darija的BLEU得分。该数据集还催生了阿拉伯方言翻译评测基准,推动了跨阿拉伯语方言的模型迁移学习研究。
以上内容由遇见数据集搜集并总结生成


