tgif-recaption
收藏资源简介:
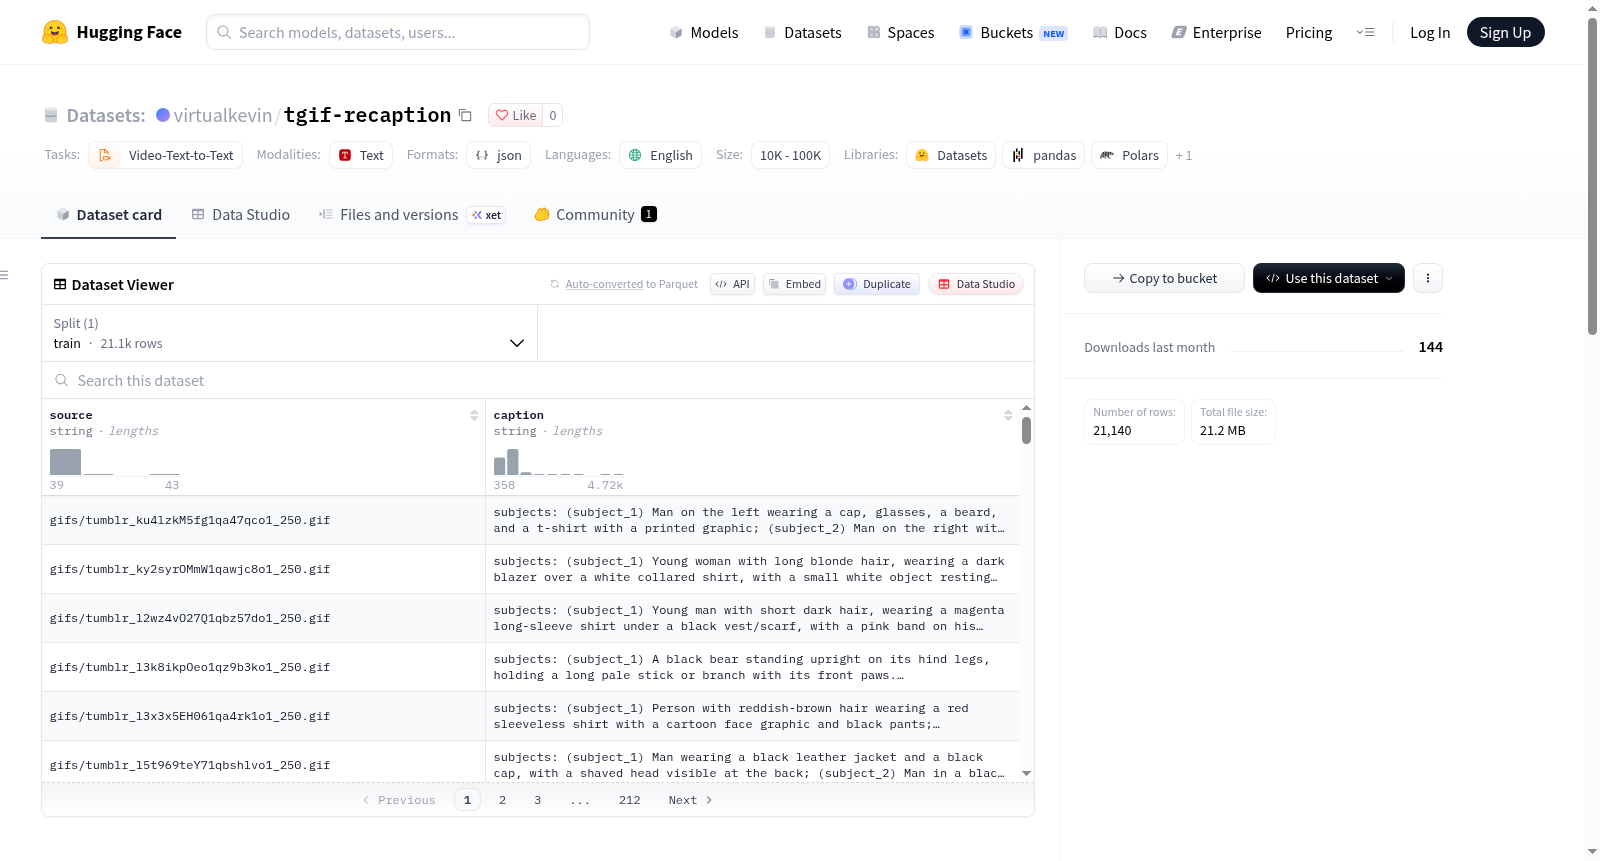
该数据集是 TGIF 数据集的重新描述版本,包含 19,137 条机器生成的视频描述。每条数据包含两个字段:source(原始 GIF 存档中的文件名)和 caption(英文描述,包括主体描述、镜头和带时间戳的动作)。描述由本地服务的模型生成,输入为原始 GIF 的 RGB 帧,采样率目标为 8 fps,最多处理 32 帧,最大图像边长 512 像素并保持宽高比。生成过程启用模型推理,推理努力度为 xhigh,最大输出长度 8192 tokens(含推理过程)。描述格式参照 MiniMax 视频提示写作指南,包含稳定的视觉主体标识、镜头描述和有时间标记的动作。数据经过可解析性、主体引用和时间边界验证,但不保证视觉正确性。该数据集仅包含文本,不包含原始 GIF 文件、图像或视频。完整的重新描述目标覆盖 TGIF 的所有 102,066 个 GIF 文件,当前版本为部分发布。适用于视频描述生成、视频到文本等任务。
This dataset is a re-described version of the TGIF dataset, containing 19,137 machine-generated video descriptions. Each entry has two fields: source (filename in the original GIF archive) and caption (English description including subject description, shot, and timestamped actions). Descriptions are generated by a locally served model using RGB frames from the original GIF, with a target sampling rate of 8 fps, processing up to 32 frames, maximum image side length of 512 pixels while maintaining aspect ratio. The generation uses model inference with reasoning effort set to xhigh, maximum output length of 8192 tokens (including reasoning). The description format follows the MiniMax video prompt writing guide, including stable visual subject identification, shot descriptions, and time-stamped actions. Data is validated for parsability, subject reference, and time boundaries, but visual correctness is not guaranteed. The dataset contains only text, no original GIF files, images, or videos. The full re-description target covers all 102,066 GIFs in TGIF, and the current version is a partial release. Suitable for video description generation, video-to-text, etc.
TGIF Recaption v1 数据集概述
基本信息
- 数据集名称:TGIF Recaption v1
- 数据集地址:https://huggingface.co/datasets/virtualkevin/tgif-recaption
- 语言:英语(en)
- 任务类别:视频-文本到文本(video-text-to-text)
- 配置名称:v1
- 数据文件:data/train.jsonl(split: train)
数据集内容
- 为原始 TGIF GIF 生成的一组实验性机器生成字幕,共 22,145 条。
- 该仓库仅包含文本。不包含源 GIF、图像、采样帧或视频负载。
source标识原始tgif.tar.gz中确切的 GIF 成员路径,并非托管下载 URL。
字段说明
| 列名 | 含义 |
|---|---|
source |
原始归档成员文件名,例如 gifs/tumblr_....gif。 |
caption |
英文主体描述,后接镜头与带时间标记的视觉动作。 |
数据划分说明
train为导出划分名称,并非 TGIF 官方基准划分。- 完整归档重述任务目标为全部 102,066 个源 GIF 文件。
- 中间检查点不完整,按归档位置排序,包含 64 条带种子的随机基准字幕。
- 失败条目在本地跟踪,并从已发布字幕中排除。
字幕生成方法
- 本地服务的模型 ID 为
model。 - RGB 帧覆盖整个原始 GIF,并保留其帧时长。
- 采样目标为 8 fps,上限为 32 帧,图像最大边长为 512 像素,保持宽高比。
- 缺失或无效的帧时长在本地使用 100 毫秒。
- vLLM 输入模式为
video。 - 原生视频请求使用虚拟毫秒时基来表示 GIF 的可变帧时序。
- 模型推理为启用状态。
- 推理强度:
xhigh。 - 最大输出配额:8,192 token(含推理)。
- 仅发布渲染后的标注,内部推理保留在本地。
格式来源
- 格式改编自 MiniMax 视频提示词编写指南:稳定的视觉主体标识符、镜头描述、带时间戳的动作。
- 主体 ID 与动作区间为扩展内容。
- 不推断任何音频或对话。
- 精确标注指令见 docs/prompt.txt。
校验说明
- 字幕针对可解析性、主体引用与时间边界进行校验,然后渲染为文本。
- 这些检查不证明视觉正确性。
- 字幕可能误识别物体、动作、外观、镜头运动或文本。
- 稀疏帧可能遗漏短暂动作与剪辑;文本中的时间戳精度仅为格式,而非毫秒级标注精度。
- 编码助手的视觉审查仅覆盖样本,并非全部行;未进行人工标注的准确性基准测试。
性能与来源
- 实测请求时序与输出校验和见 docs/benchmark.json。
- 其描述本次运行与服务器配置,不保证全数据集吞吐量。
- 恢复的运行可能在观察窗口内包含空闲间隙。
- 完全字节重复的内容可复用标注。
- 解码/推理失败记录在本地,不会作为空字幕发布。
原始数据来源
- 原始数据集来源:TGIF(https://github.com/raingo/TGIF)。
- 本字幕数据集不授予底层 GIF 媒体的相关权利。