
AnimeShooter
收藏官方服务:
资源简介:
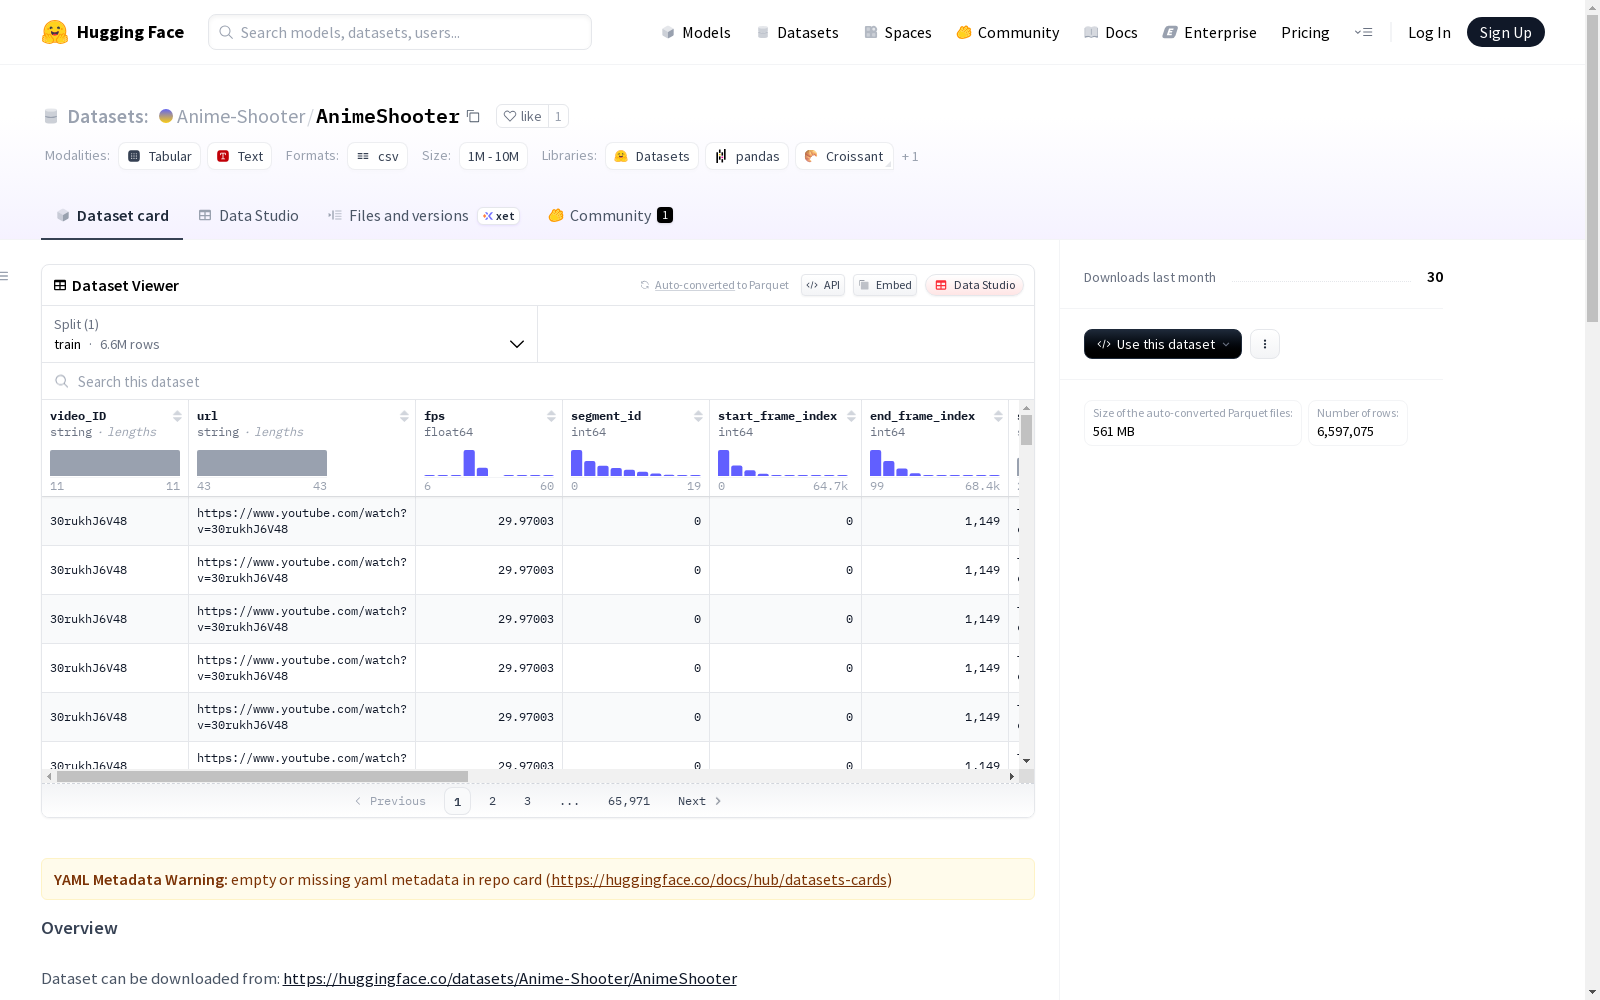
AnimeShooter数据集包含来自YouTube视频的注解视频片段,用于训练故事驱动的视频生成模型。每个视频被分解为具有丰富元数据的有意义叙事单元,包括角色、环境和视觉组件。数据集提供训练CSV文件和完整注释的ZIP文件,注释以JSON格式存储,包括参考图像掩码。
The AnimeShooter Dataset contains annotated video clips sourced from YouTube videos, intended for training story-driven video generation models. Each video is decomposed into meaningful narrative units with rich metadata, including characters, environments and visual components. The dataset provides training CSV files and ZIP archives of complete annotations. The annotations are stored in JSON format and include reference image masks.
创建时间:
2025-05-15
搜集汇总
数据集介绍
构建方式
在动漫叙事视频生成领域,AnimeShooter数据集的构建采用了系统化的视频分解方法。该数据集源自YouTube平台的精选动漫视频,通过人工标注将每个视频划分为具有连贯叙事逻辑的片段。每个片段进一步细分为镜头单元,并辅以多层次元数据标注,涵盖角色外观、场景环境和视觉元素描述。构建过程中特别引入了参考图像掩码机制,利用运行长度编码技术精确标记角色轮廓,为模型训练提供结构化叙事单元。
特点
该数据集最显著的特征在于其层次化叙事标注体系。视频级元数据包含原始视频标识与时间对齐参数,片段级则通过剧情脚本完整记录叙事脉络与角色互动关系。镜头级标注创新性地融合了情节驱动描述与视觉元素清单,同时配备四秒时间窗口优化机制以适应短视频生成需求。独特的角色参考图像掩码系统能够精准捕捉动态场景中的角色形态变化,为视觉一致性建模提供重要支撑。
使用方法
使用该数据集时,研究者可通过两种结构化数据格式开展实验。训练阶段推荐采用扁平化的shot级标注文件,其中包含完整的叙事元素与视觉描述,适用于端到端视频生成模型训练。进阶研究则可调用完整压缩包中的JSON文件,利用参考图像掩码实现角色感知的生成任务。数据加载时需注意时间戳与帧索引的对应关系,通过解析嵌套JSON结构可分别获取视频、片段与镜头三个层级的语义信息。
背景与挑战
背景概述
在人工智能驱动的视频生成技术快速发展背景下,AnimeShooter数据集应运而生,专门针对动漫风格叙事视频的生成任务。该数据集由Anime-Shooter研究团队构建,通过系统化采集YouTube平台上的动漫视频内容,致力于解决故事驱动视频生成中的结构化语义理解难题。其核心价值在于将视频内容分解为具有完整叙事逻辑的片段单元,为生成模型提供角色、场景与视觉元素的丰富标注信息,显著推动了叙事连贯性视频生成技术的发展。
当前挑战
该数据集面临的双重挑战体现在领域问题与构建过程两个维度。在领域层面,故事驱动视频生成需克服叙事连贯性保持、多角色一致性维护以及时空逻辑合理构建等核心难题。构建过程中,研究人员需要应对视频片段叙事单元划分的主观性挑战,角色外观描述与视觉元素标注的精确性要求,以及参考图像掩码与视频帧时序对齐的技术复杂性。这些挑战共同构成了数据集在支持高质量视频生成模型训练过程中的关键瓶颈。
常用场景
经典使用场景
在动漫视频生成领域,AnimeShooter数据集凭借其精细的叙事单元划分和丰富的元数据标注,成为训练故事驱动型视频生成模型的基石。该数据集将视频分解为具有连贯情节的片段,并详细标注角色、场景及视觉元素,为模型学习叙事结构和视觉一致性提供了理想素材。研究人员可基于其层级化标注体系,开发能够理解并生成复杂动漫叙事的智能系统,推动生成内容从碎片化向故事化演进。
解决学术问题
该数据集有效解决了视频生成研究中叙事连贯性缺失的关键难题。通过提供角色外观描述、环境设定及情节摘要等多维度标注,它使模型能够捕捉叙事逻辑与视觉元素的关联性。其带时间戳的镜头级标注尤为珍贵,为时序动作生成和场景转换研究提供了精准监督信号,显著提升了生成视频在情节推进与角色行为方面的合理性,填补了长序列视频语义控制的理论空白。
衍生相关工作
该数据集催生了多项里程碑式研究,例如基于角色掩码的跨镜头一致性生成框架,通过参考图像与RLE掩码实现了角色形象的稳定延续。其叙事脚本标注启发了多模态故事板生成模型,能够同步输出视觉画面与情节描述。近期工作更结合音频扩展版本,开发出视听同步的动漫视频生成系统,这些衍生成果共同构建起基于结构化叙事的智能内容生成技术体系。
以上内容由遇见数据集搜集并总结生成


