Praxel/codeswitch-pairs-lase-heldout
收藏资源简介:
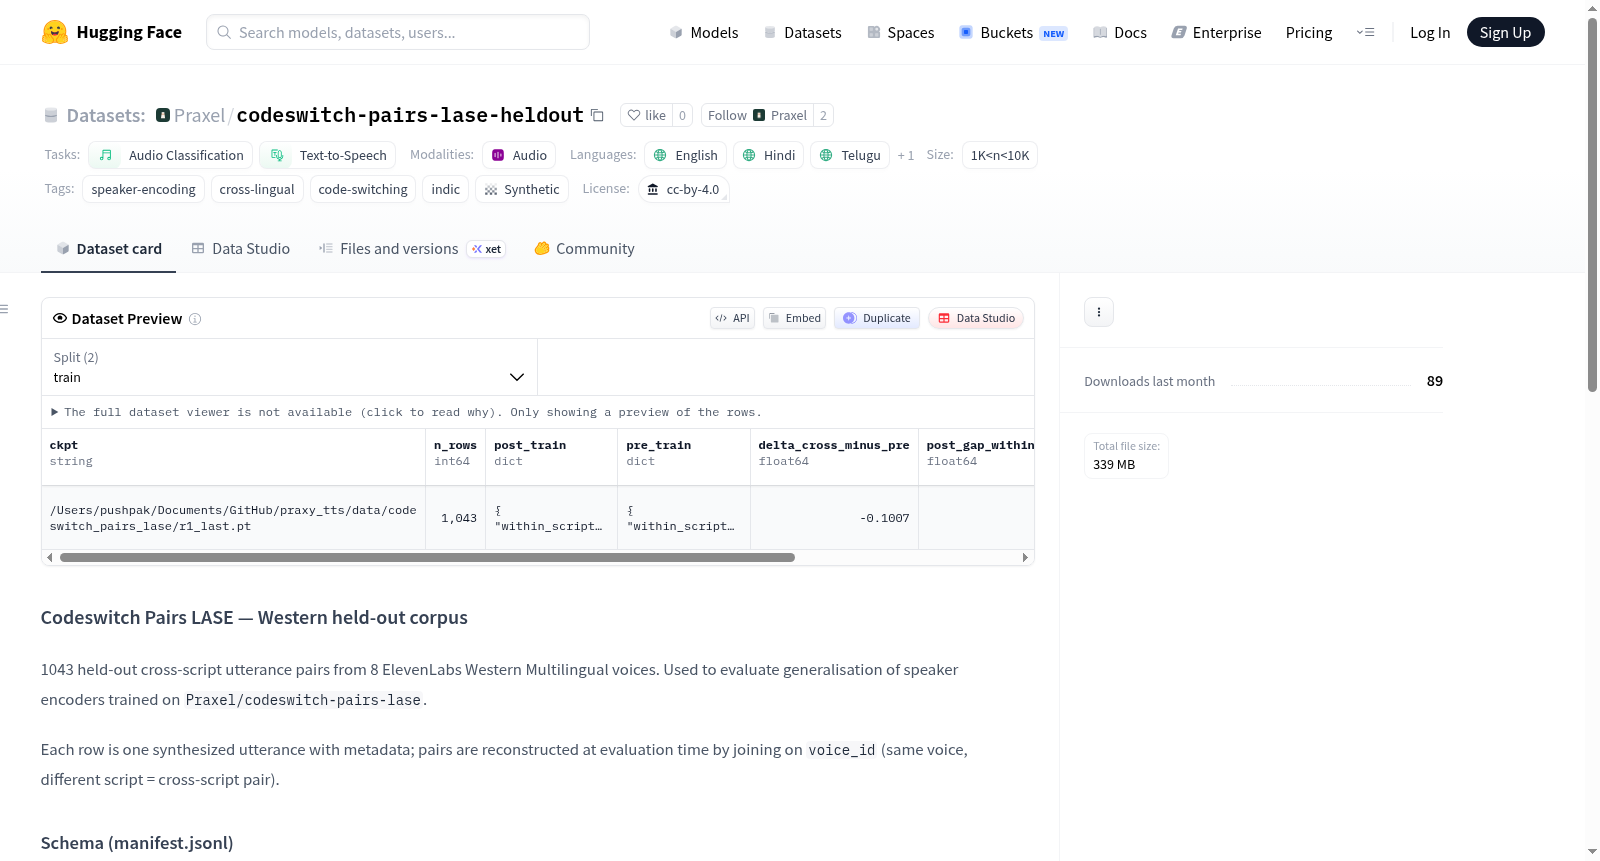
Codeswitch Pairs LASE — Western held-out corpus数据集包含1043个跨脚本的语音对,用于评估在`Praxel/codeswitch-pairs-lase`上训练的说话人编码器的泛化能力。数据集由8个ElevenLabs西方多语言语音生成,支持英语(en)、印地语(hi)、泰卢固语(te)和泰米尔语(ta)四种语言。每个语音对包含元数据,如语音ID、语言、文本提示、音频路径和质量评分。音频为16 kHz单声道WAV格式,每段约2秒。数据集还提供了统计信息,如语音对数量、语音数量、语言种类和质量门槛。数据集的来源是通过ElevenLabs Multilingual v2 API合成的,语音ID是公开的ElevenLabs目录语音,用于研究/评估目的。文本提示是短通用英语短语的翻译/音译。
The Codeswitch Pairs LASE — Western held-out corpus dataset contains 1043 held-out cross-script utterance pairs from 8 ElevenLabs Western Multilingual voices, used to evaluate generalisation of speaker encoders trained on `Praxel/codeswitch-pairs-lase`. The dataset supports four languages: English (en), Hindi (hi), Telugu (te), and Tamil (ta). Each utterance pair includes metadata such as voice ID, language, text prompt, audio path, and quality scores. The audio is in 16 kHz mono WAV format, approximately 2 seconds per utterance. The dataset also provides statistics like the number of pairs, voices, languages, and quality gate. The data was synthesized using the ElevenLabs Multilingual v2 API, with voice IDs from the public ElevenLabs catalog used for research/evaluation purposes. The text prompts are short generic English phrases translated/transliterated into each target script.