
FoundationVision/groma_instruct
收藏官方服务:
资源简介:
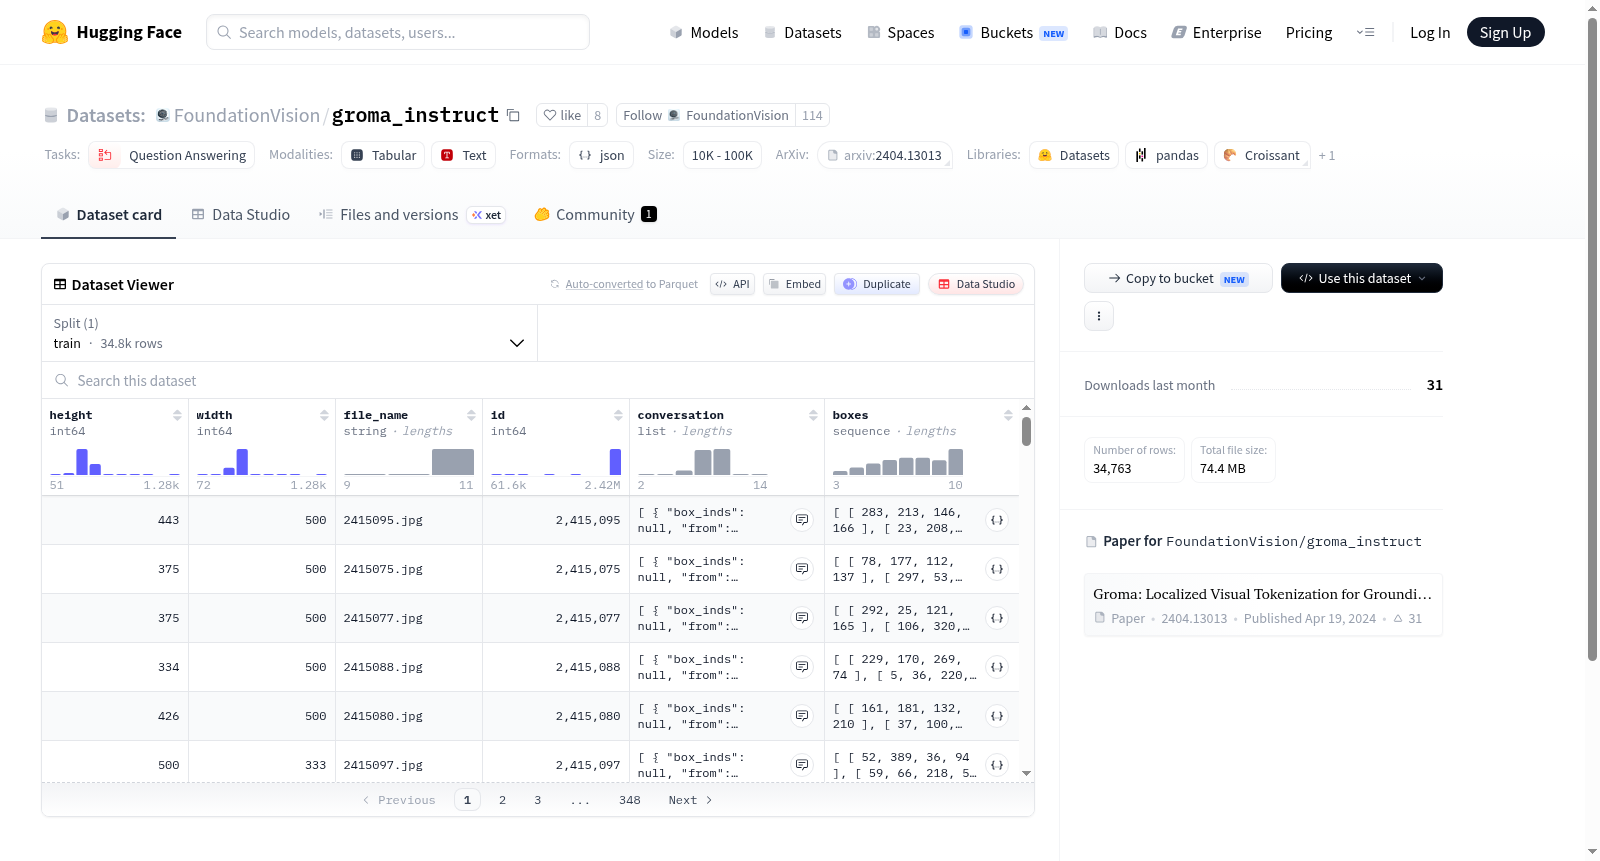
Groma Instruct数据集包含30k视觉基础对话,用于指令微调。这是第一个结合视觉和文本提示构建的基于聊天的数据集,利用了GPT-4V进行数据生成。
Groma Instruct数据集包含30k视觉基础对话,用于指令微调。这是第一个结合视觉和文本提示构建的基于聊天的数据集,利用了GPT-4V进行数据生成。
提供机构:
FoundationVision原始信息汇总
数据集概述
数据集名称
Groma Instruct
数据集大小
包含30,000个视觉基础对话
数据集特点
- 首个结合视觉和文本提示的接地聊天数据集
- 利用GPT-4V进行数据生成
任务类别
- 问答
搜集汇总
数据集介绍
构建方式
在视觉定位对话领域,高质量指令微调数据的稀缺性长期制约着多模态大模型的发展。Groma Instruct数据集应运而生,其构建过程创新性地融合了视觉与文本提示,借助GPT-4V的卓越生成能力,自动产生包含图像区域定位信息的对话样本。具体而言,研究者首先设计多模态提示模板,引导GPT-4V在理解图像内容的同时,对特定区域进行语义标注,从而生成30,000条视觉定位对话对。这一方法不仅大幅降低了人工标注成本,还确保了对话的自然多样性与定位精度。
特点
该数据集的核心优势在于其开创性的双模态提示机制,即同时以文本问题和图像区域为输入,驱动模型生成带有空间感知的回复。这使得Groma Instruct成为首个兼具视觉与文本引导的定位对话数据集。此外,30k的规模在保证数据质量的同时兼顾了训练效率,每条样本均包含精确的边界框坐标与语义描述,为多模态指令微调提供了丰富的空间上下文信息。数据集的领域覆盖广泛,涉及物体识别、关系推理和空间理解等任务,显著增强了模型的细粒度视觉推理能力。
使用方法
使用Groma Instruct数据集时,研究者可将其直接用于多模态大模型的指令微调阶段,以提升模型对图像中特定区域的对话响应能力。推荐采用标准的监督微调范式,将视觉编码器与语言模型结合,利用数据集中的图像-文本对及区域标注进行端到端训练。具体实践中,需将边界框坐标转换为模型可理解的格式,并与文本指令拼接成统一输入序列。该数据集兼容主流框架如HuggingFace Transformers,用户可通过加载FoundationVision/groma_instruct快速获取数据,并参考官方论文与GitHub仓库提供的基线代码进行实验配置。
背景与挑战
背景概述
在大型多模态模型的研究浪潮中,视觉定位对话能力成为衡量模型细粒度理解与交互水平的关键指标。Groma Instruct数据集由FoundationVision团队于2024年创建,旨在突破传统视觉问答数据集仅依赖文本查询的局限,首次引入兼具视觉与文本提示的定位对话样本。该数据集依托GPT-4V的强大生成能力,构建了包含3万条高质量指令微调样本的资源库,为多模态模型从粗粒度描述迈向细粒度定位推理提供了核心训练支撑。其研究问题聚焦于如何使模型在自然对话中精准关联图像区域与语义表述,这一方向对推动具身智能、辅助视觉系统等应用具有深远影响。
当前挑战
当前Groma Instruct数据集面临的核心挑战在于:其一,领域问题层面,现有视觉定位对话任务仍受限于标注数据的稀疏性与场景覆盖不足,难以应对开放世界中多样化的物体形态与复杂空间关系,模型在长尾分布下的泛化能力亟待提升。其二,构建过程中,依赖GPT-4V生成数据虽保证了多样性,但存在幻觉与一致性偏差风险,需通过人工校验与多步过滤机制确保标注可靠性;同时,视觉与文本提示的联合设计缺乏标准化协议,不同模态间的语义对齐易引入歧义,对数据集的可重复利用性构成障碍。
常用场景
经典使用场景
Groma Instruct数据集的核心应用在于多模态指令微调,其独特之处在于融合了视觉与文本双重提示,构建了首个具备视觉定位能力的对话数据集。在视觉问答与图像描述等经典任务中,研究者利用该数据集训练模型,使其不仅能理解自然语言指令,还能精准定位图像中的目标区域,从而生成含有空间位置信息的响应。这种基于视觉锚点的对话生成范式,为多模态大模型在细粒度视觉理解与交互式推理方面提供了关键的数据支撑。
解决学术问题
该数据集有效解决了多模态大模型在视觉定位与语言生成之间缺乏对齐的学术难题。传统数据集常将图像描述与物体检测割裂,导致模型难以在对话中同时完成“指认”与“回答”。Groma Instruct通过GPT-4V生成的3万条视觉定位对话,使得模型能够学习到从文本指令到图像区域映射的端到端推理能力,显著提升了多模态系统在开放场景下的指代消解与空间关系理解水平。
衍生相关工作
基于Groma Instruct,学界已衍生出多项经典工作,如Groma模型本身即为该数据集的核心成果,其创新性地将视觉定位能力融入多模态对话框架。后续研究进一步探索了基于该数据集的视觉基础模型微调策略,以及将视觉定位对话扩展至视频理解与三维场景解析。此外,该数据集还催生了关于数据合成质量评估与多模态指令多样性分析的方法论工作,推动了视觉-语言联合建模领域向更细粒度、更可解释的方向发展。
以上内容由遇见数据集搜集并总结生成


