
ios-ioe/nepali-bias-dataset
收藏官方服务:
资源简介:
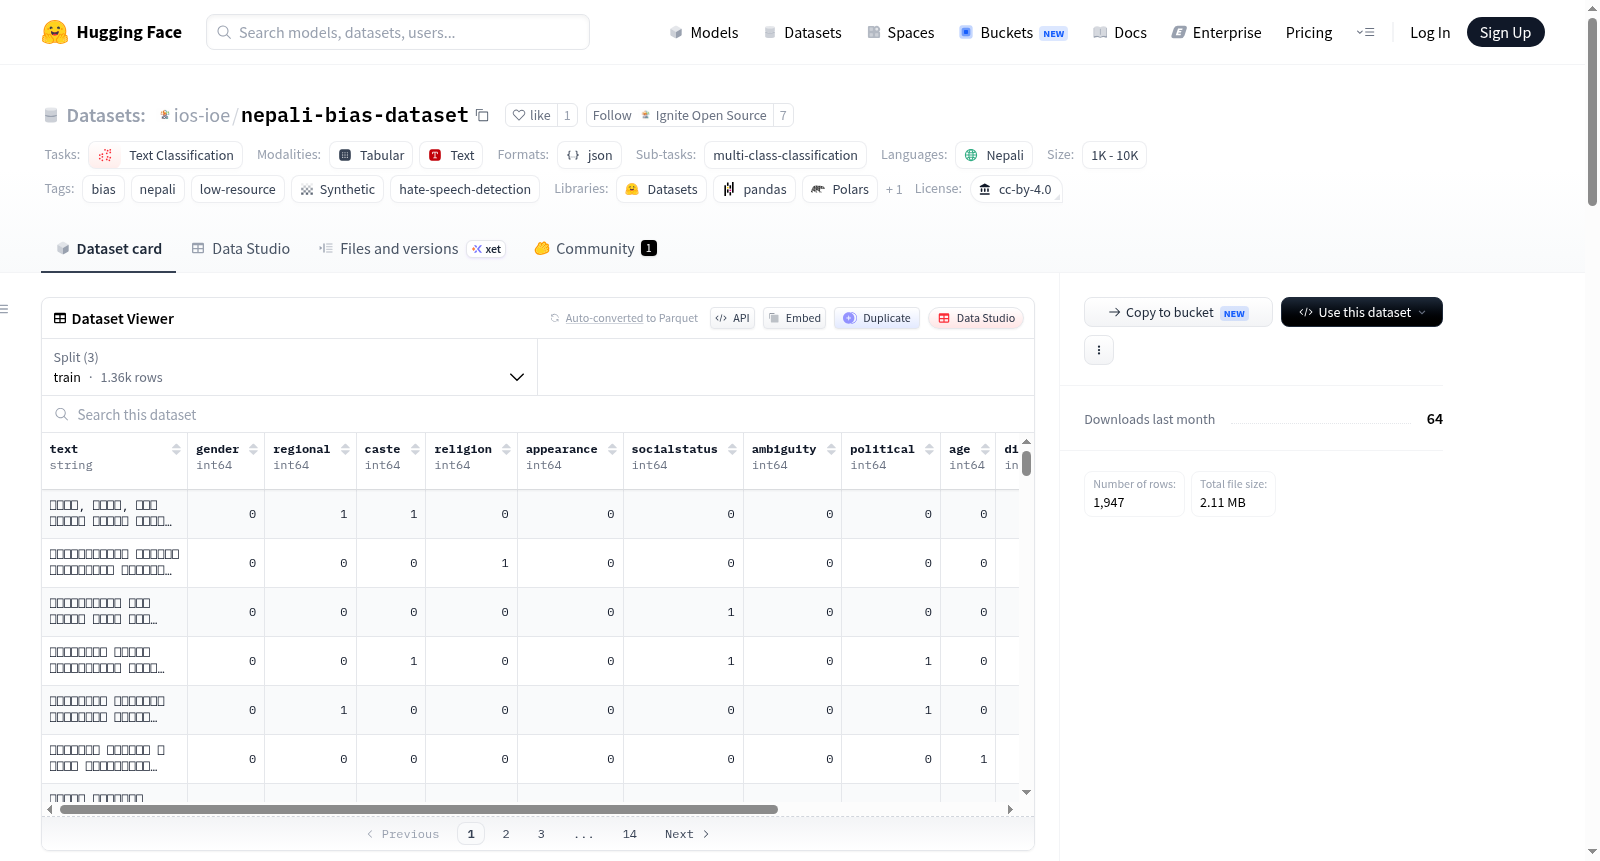
一个尼泊尔语句子的合成数据集,标注了包括性别、宗教、种姓、地区、外貌、社会地位、政治、年龄和残疾偏见在内的偏见类别。句子首先由大型语言模型(如ChatGPT、Grok)根据真实尼泊尔新闻上下文生成并标注,然后由人工标注者手动审查和纠正。
A synthetic dataset of Nepali sentences annotated with bias categories including gender bias, religious bias, caste bias, regional bias, appearance-related bias, social status bias, political bias, age bias, and disability bias. The sentences were first generated and annotated by large language models (LLMs, e.g., ChatGPT, Grok) based on real Nepali news contexts, followed by manual review and correction by human annotators.
提供机构:
ios-ioe搜集汇总
数据集介绍
构建方式
该数据集以尼泊尔新闻文章和社交媒体为源文本,借助大型语言模型(如ChatGPT和Grok)在真实新闻语境提示下自动生成带有偏见类别的合成语句。随后,由人工标注者对生成内容进行逐项审查与修正,确保标签质量。最终标注方案采用多标签二元分类框架,每个样本可被赋予零个或多个偏见类别标签,初始标签与人工修正后标签的精确匹配度约为95%。
特点
数据集涵盖性别、宗教、种姓、地域、外貌、社会地位、政治、年龄及残疾等九种具体偏见类别,并设有歧义与无偏见类别,共包含1947个样本,划分为训练集(1362例)、验证集(292例)与测试集(293例)。其独特之处在于聚焦于低资源语言尼泊尔语,填补了该语言在偏见检测领域的空白,同时合成数据与人工校验的结合确保了标注的一致性与可靠性。
使用方法
用户可通过HuggingFace的datasets库轻松加载该数据集,调用load_dataset('ios-ioe/nepali-bias-dataset')即可获取完整内容,亦可指定split参数分别加载训练、验证或测试子集。每个样本以字典形式呈现,包含尼泊尔语句子的文本字段、唯一标识符、各偏见类别的二元标签以及标注者的可选注释。该数据集适用于训练尼泊尔语偏见检测模型、评估多语言公平性工具,并助力低资源语言的偏见研究。
背景与挑战
背景概述
在自然语言处理领域,偏见检测是确保模型公平性与社会伦理适配的关键任务,尤其对于尼泊尔语等低资源语言而言,相关研究长期受限于标注数据的匮乏。nepali-bias-dataset由Khagendra Neupane、Sangam Silwal、Rupak Adhikari和Sambhav Regmi等研究者创建,旨在填补这一空白。该数据集通过融合大语言模型(如ChatGPT、Grok)自动生成与人工审核校正的策略,构建了涵盖性别、宗教、种姓、地域、外貌、社会地位、政治、年龄和残疾等九类偏见的1947条标注句子,原始文本来源于尼泊尔新闻与社交媒体。作为首个系统覆盖尼泊尔社会多元偏见维度的合成数据集,它为本地区偏见检测模型的训练与多语言公平性工具评估提供了基准资源,推动了低资源语言情境下社会语言学与计算伦理学的交叉研究。
当前挑战
该数据集解决的核心领域挑战是尼泊尔语语境下偏少样本与多标签分类的复杂交织问题:偏见在尼泊尔社会中常以多维交叉形式呈现(如种姓与地域偏见共存),使得单一标签模型难以准确刻画;同时,低资源语言缺乏大规模人工标注语料,传统方法难以捕捉真实世界中微妙的偏见表达。在构建过程中,研究者面临合成数据与真实语境偏差的挑战——大语言模型生成的示例可能过于模板化,未能充分模拟口语化或网络非正式用语中的隐性偏见;此外,偏见类别的边界存在模糊性,尤其在多重叠类别样本中,初始LLM标签与人工修正的精确匹配率仅达95%,表明标注一致性受主观解释差异影响显著,且需谨慎处理文化规范随时代演化的动态适应问题。
常用场景
经典使用场景
在自然语言处理与计算社会学交叉领域,nepali-bias-dataset作为尼泊尔语首个系统性偏见检测数据集,被广泛用于多标签文本分类任务的模型训练。研究者通过其涵盖的性别、宗教、种姓、地域等九类社会偏见标签,能够构建针对低资源语言的细粒度偏见识别系统。该数据集特别适用于训练基于BERT等预训练模型的分类器,在尼泊尔语语境下实现从新闻文本到社交媒体内容的偏见自动标注。其多标签架构允许同一句子包含多重偏见类型,真实模拟了现实语言中偏见交织的复杂现象。
实际应用
在实际应用中,该数据集赋能尼泊尔语内容审核系统,帮助社交媒体平台自动识别涉及种姓歧视、性别偏见等敏感言论。新闻机构可借助基于此数据集训练的模型,在发布前标注潜在偏见措辞,提升报道的客观性与包容性。此外,政府与非政府组织能将其用于公共舆情监测,实时追踪社会歧视话语的传播路径。教育领域亦可开发反偏见教学工具,通过分析学生文本中的偏见倾向,进行针对性干预。
衍生相关工作
以nepali-bias-dataset为基础,衍生出多项突破性工作。研究者开发了首个尼泊尔语仇恨言论检测模型,通过迁移学习将本数据集的偏见分类知识应用于更宽泛的仇恨言论定义。后续工作探索了多标签损失函数的优化方案,针对偏见类别不平衡问题提出了加权Focal Loss变体。还有团队基于该数据集构建了跨语言偏见对齐模型,对比尼泊尔语与印地语、英语中的偏见表达差异,推动了多语言公平性研究的进展。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


