FreeSyntheticGenomicReads200M
收藏资源简介:
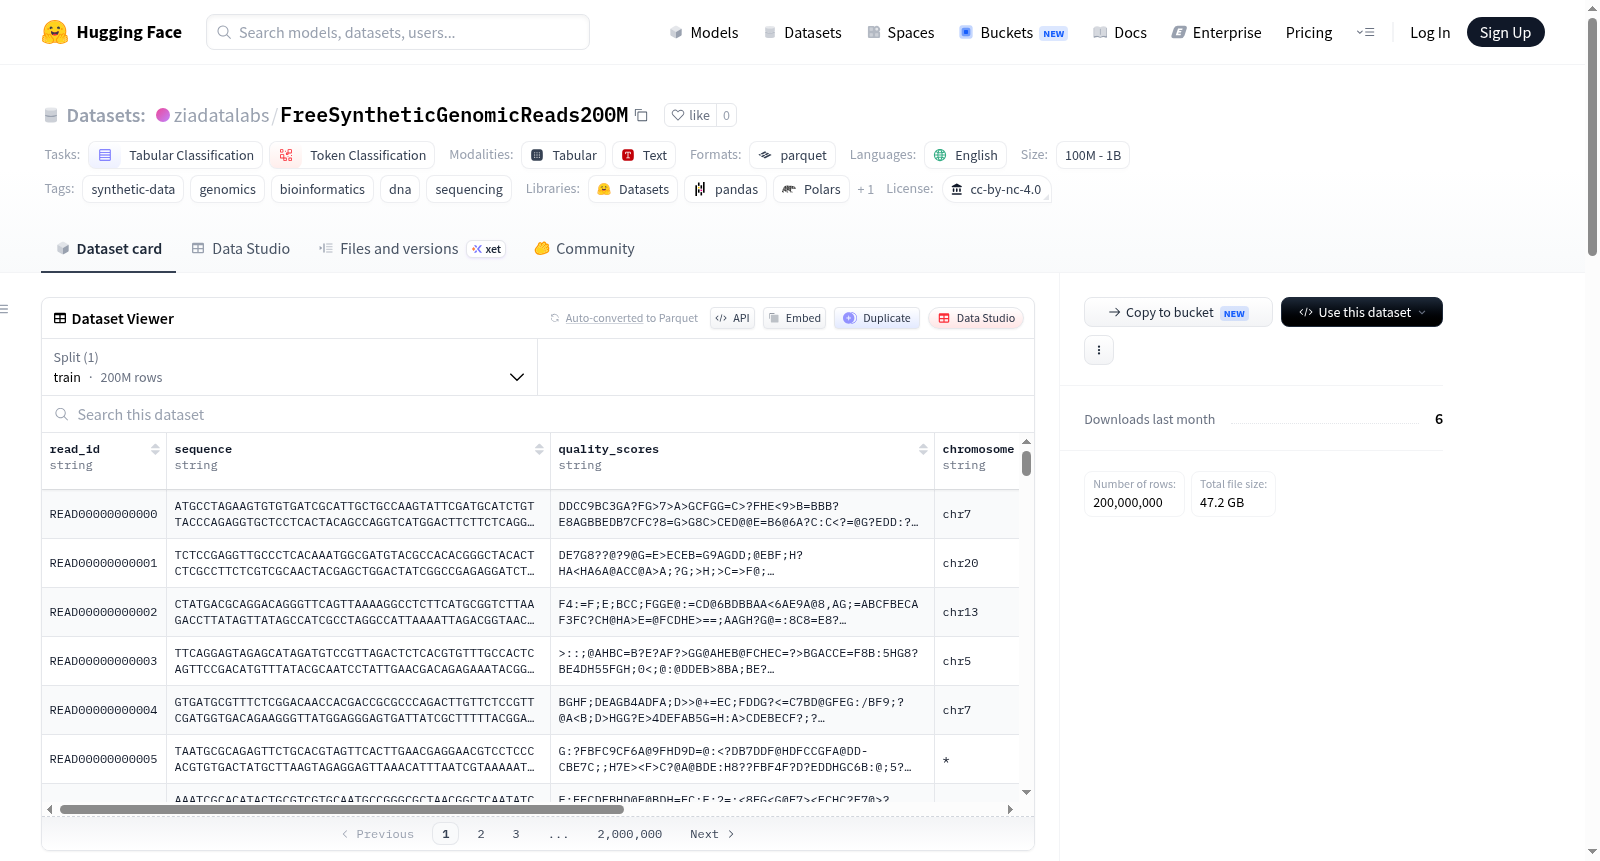
FreeSyntheticGenomicReads200M 是一个包含 2 亿条全合成短读 DNA 序列的免费数据集,每条序列长度为 150 碱基对。该数据集专为开发人员、研究人员和学生设计,用于测试生物信息学管道、序列比对工具、读处理系统以及计算生物学教学。数据以单个 Parquet 文件形式存储,采用 Snappy 压缩,大小约 44 GB,包含 10 个字段:读标识符(read_id)、序列(sequence,A/C/G/T)、质量分数(quality_scores,Phred+33 格式)、染色体(chromosome,chr1-22、chrX、chrY、chrM 或 *)、位置(position,1-based 或 0)、链(strand,+/- 或 *)、映射质量(mapping_quality,0-60)、GC 含量(gc_content,0-1)、是否映射(is_mapped,布尔值)和读长度(read_length,固定 150)。所有序列完全随机生成,不包含任何真实生物序列,但模拟了真实测序数据的特征:约 94% 的读段映射到参考染色体(权重基于真实人类染色体大小),质量分数偏向高质量区域。该数据集在 CC BY-NC 4.0 许可下发布,允许个人、研究和教育用途,但禁止商业使用。
FreeSyntheticGenomicReads200M is a free dataset containing 200 million fully synthetic short-read DNA sequences, each 150 base pairs in length. Designed for developers, researchers, and students, it is used for testing bioinformatics pipelines, sequence alignment tools, read processing systems, and computational biology teaching. The data is stored as a single Parquet file with Snappy compression, approximately 44 GB in size, and includes 10 fields: read_id, sequence (A/C/G/T), quality_scores (Phred+33 format), chromosome (chr1-22, chrX, chrY, chrM, or *), position (1-based or 0-based), strand (+/- or *), mapping_quality (0-60), gc_content (0-1), is_mapped (boolean), and read_length (fixed 150). All sequences are fully randomly generated and contain no real biological sequences, but simulate characteristics of real sequencing data: approximately 94% of reads map to reference chromosomes (weighted based on real human chromosome sizes), and quality scores are biased toward high-quality regions. The dataset is released under the CC BY-NC 4.0 license, allowing personal, research, and educational use but prohibiting commercial use.
FreeSyntheticGenomicReads200M 数据集总结
数据集简介
FreeSyntheticGenomicReads200M 是一个包含 2亿条完全合成的短读长 DNA 序列 的免费数据集,专为需要大规模真实测序风格数据的开发者、研究人员和学生设计,适用于测试生物信息学流程、序列比对工具、读段处理系统或用于计算生物学教学。数据集中不包含任何真实基因组、生物体或个体信息,所有序列均为随机生成。
数据规模与格式
- 数据量:200,000,000 行记录
- 文件格式:单个 Parquet 文件,Snappy 压缩,约 44 GB
- 序列长度:每条序列 150 碱基对(bp)
数据模式(Schema)
| 列名 | 类型 | 描述 |
|---|---|---|
| read_id | string | 唯一读段标识符 |
| sequence | string | 150 bp 读段序列(A/C/G/T) |
| quality_scores | string | 每碱基 Phred+33 质量字符串(150 字符) |
| chromosome | string | 比对到的染色体(chr1-chr22, chrX, chrY, chrM),未比对则为 * |
| position | int | 基于 1 的参考位置,未比对则为 0 |
| strand | string | 比对读段为 + 或 -,未比对则为 * |
| mapping_quality | int | MAPQ 分数(0-60) |
| gc_content | float | 读段 GC 占比(0-1) |
| is_mapped | bool | 读段是否已比对 |
| read_length | int | 读段长度(碱基数,固定为 150) |
数据特征
- 序列为 150 bp 随机 A/C/G/T,质量分数偏向高质量,模拟真实短读段输出形态。
- 约 94% 的读段被比对到染色体上,染色体权重依据真实人类染色体大小分配,并填充了比对质量、位置、链方向和 GC 含量等信息。
- 未比对读段使用标准的 * / 0 占位符。
- 所有数据均为完全合成,不包含任何真实生物序列。
使用建议
由于数据集体积约 44 GB、2 亿行,建议采用流式或批量处理方式,避免一次性全量加载。推荐方式包括:
- DuckDB:使用 SQL 查询进行抽样或筛选。
- PyArrow:通过迭代批次(如每批 100,000 行)处理。
- Hugging Face Datasets:启用流式加载模式。
许可与用途
- 许可证:CC BY-NC 4.0(知识共享-非商业使用)
- 允许用途:个人、研究和教育用途,需注明出处。
- 禁止用途:商业用途。
- 创建方:Zia Data Labs(联系邮箱:zia.data.team@protonmail.com)