
遇见数据集

Trotquonalize/ksl-pose-dictionary-poc

收藏
Hugging Face2026-05-27 更新2026-05-31 收录
官方服务:

资源简介:

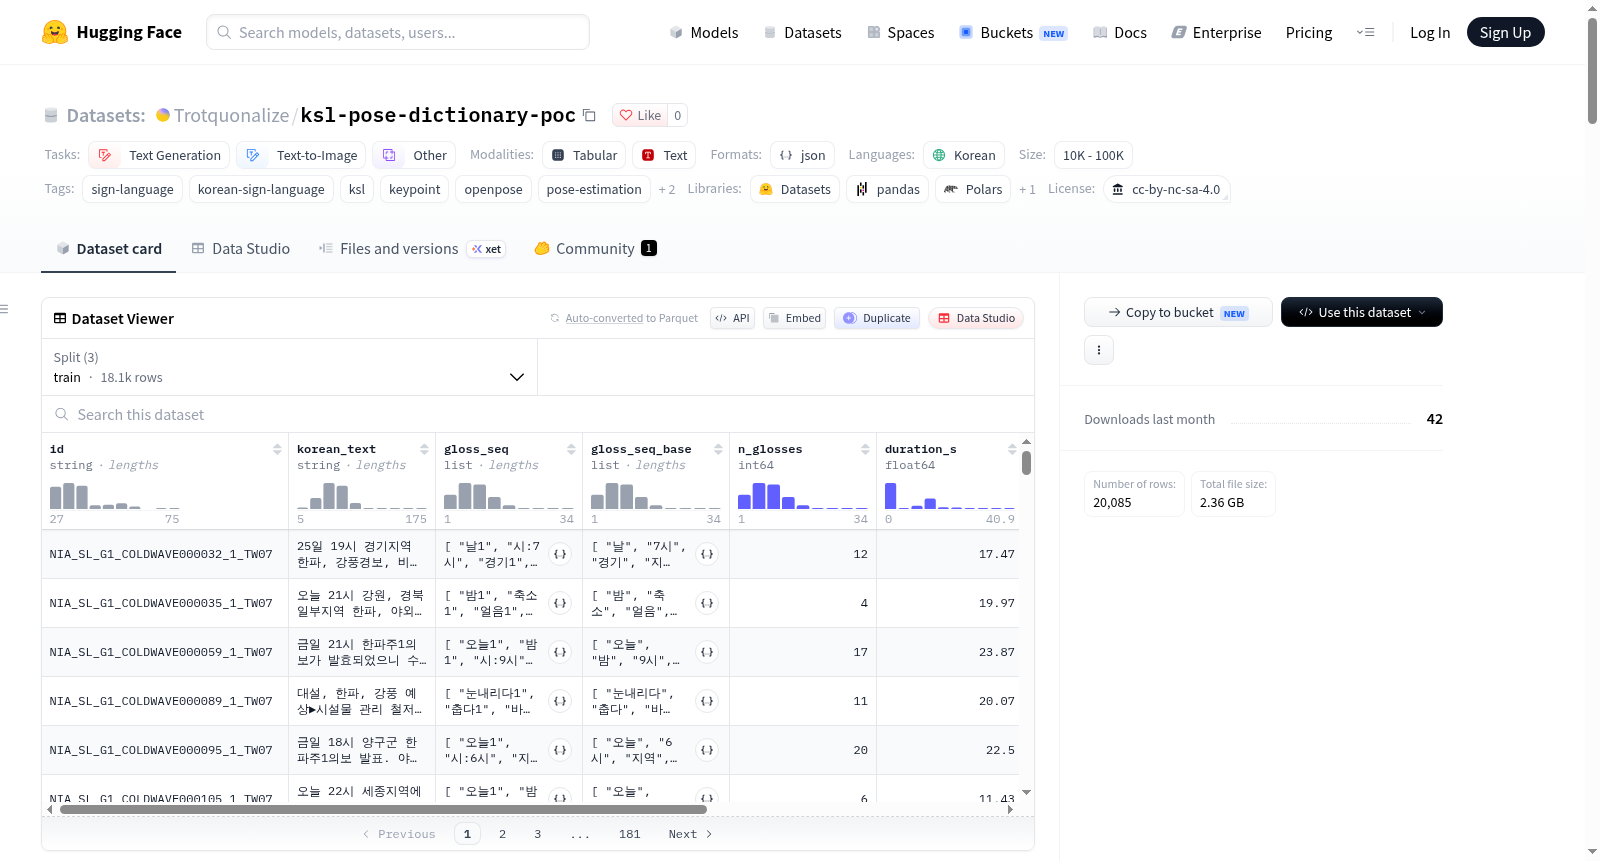
KSL Pose Dictionary (PoC) 是一个用于韩国手语文本到姿态生成研究的关节点数据集,属于原型验证阶段。它包含来自两个主要来源的混合关节点数据:一是韩国国立国语院韩国手语词典的1,444个单词的关节点(使用OpenPose 137格式,通过RTMW-DW-L-M模型提取),二是NIASL2021数据集中灾难安全领域的2,287个基础手势片段的关节点(原始OpenPose 137格式)。数据集整合成一个包含4,511个独特手势的混合索引,并提供了用于第一阶段训练的语料库,包含20,085个样本(训练集18,067、验证集986、测试集1,032),每个样本由韩语句子和对应的KSL手势序列组成。此外,还包括一个包含2,984个唯一基础词元的KSL词汇表。该数据集主要用于支持基于字典的韩国手语生成原型开发,覆盖了NIASL2021原始手势间隔的93.3%。数据以JSON格式存储,包含身体、面部和手部的137个关节点坐标,适用于序列到序列模型训练和关节点可视化任务。

KSL Pose Dictionary (PoC) is a keypoint dataset for Korean sign language (KSL) text-to-pose prototype development. It consists of hybrid keypoint data from two main sources: 1,444 word keypoints from the National Institute of the Korean Languages Korean Sign Language Dictionary (in OpenPose 137 format extracted via RTMW-DW-L-M), and 2,287 base gloss segmentation keypoints from the NIASL2021 disaster safety domain (original OpenPose 137). The dataset integrates into a hybrid sign index with 4,511 unique signs and provides a Stage 1 training corpus of 20,085 samples (train 18,067 / val 986 / test 1,032), each containing a Korean text and corresponding KSL gloss sequence. It also includes a KSL vocabulary of 2,984 unique base lemmas. Designed for dictionary-based KSL production research, it covers 93.3% of NIASL2021 raw gloss intervals. Data is stored in JSON format with 137 keypoints per frame (body, face, hands), suitable for seq2seq model fine-tuning and pose visualization tasks.

提供机构:
Trotquonalize
搜集汇总
数据集介绍
Trotquonalize/ksl-pose-dictionary-poc 数据集图片
构建方式
数据集构建遵循神经手语演员框架,自韩国手语资源中提取关键点。首先,从国立国语院韩国手语词典中采集1,444个单词视频,运用RTMW-DW-L-M模型提取OpenPose 137维关键点,涵盖身体、面部及双手。其次,对AI Hub的NIASL2021灾难安全语料进行手语 gloss 切分,依据时间戳截取关键点片段,得到2,287个基础 gloss。最后,融合两者构建混合索引,并以韩语文本-手语 gloss 序列对生成2万余条训练样本,形成多层级关键点数据集。
特点
该数据集以混合索引为核心,整合4,511个独特手语符号,具备多源异构特性。关键点数据统一采用OpenPose 137格式,涵盖身体25点、面部70点及双手各21点,精度较高。语料覆盖灾难安全与日常词汇,混合索引支持93.3%的NIASL原始gloss区间直接映射。训练集、验证集与测试集划分明确,附带词汇频率表,便于序列建模。但数据存在灾难域偏倚、单签名者及缺乏非手控标记等局限。
使用方法
使用者可通过HuggingFace Hub下载数据,利用hybrid_sign_index.json实现手语符号检索,获取对应关键点路径。加载单个JSON文件即可解析关键点序列,进行可视化或动画生成。训练时,加载stage1目录下的jsonl文件,以韩语文本为输入、gloss基础序列为目标,微调KLUE-BERT等韩语预训练模型,完成文本到手语 gloss 的序列转换。整个过程依赖公开脚本与标准化格式,便于复现与扩展。
背景与挑战
背景概述
韩国手语(KSL)的自动化生产长期受限于标注资源稀缺与数据模态单一。2024年CVPR提出的Neural Sign Actors方法为基于关键点的动作生成提供了新思路,但将其迁移至KSL面临语料匮乏的瓶颈。在此背景下,研究者JangHyun-bin于2026年发布KSL Pose Dictionary(PoC)数据集,系docent_AI_sign_research_02项目核心产出。该数据集融合国立国语院韩国手语词典的1,444词条与AI Hub NIASL2021灾难安全域2,287个基元手语,构建混合索引覆盖4,511个手语词汇,并提供20,085条韩语句子至手语基元序列的训练语料。作为KSL文本到姿势生成的概念验证资源,其为后续韩国手语神经生产研究奠定了数据基础。
当前挑战
该数据集所服务的文本到手语姿势生成任务,需在缺乏平行视频-文本对的条件下学习跨模态映射,其本质困难在于手语的多通道特性——手部动作、面部表情与身体姿态必须协同建模,而现有关键点表示往往割裂了这些通道。构建过程中,数据来源的异质性带来显著挑战:sldict词典视频与NIASL2021灾难域语料在拍摄条件、手语者风格及标注规范上存在差异,整合时需建立稳健的跨源映射;NIASL2021原始手语脚本的gloss切分依赖时间戳对齐,精度受标注质量制约。此外,仅137关键点无法编码非手动信号,且单一手语者采样限制了姿势生成的多样性,这些因素共同构成了从概念验证走向实际应用的主要障碍。
常用场景
经典使用场景
在韩国手语计算语言学与手语生成研究领域,该数据集最经典的使用场景是支撑基于词典的文本到手语姿态(text-to-pose)生产流程,具体表现为以韩语自然语言句子为输入,经由KLUE-BERT等韩语预训练语言模型进行序列到序列微调,输出对应的韩国手语gloss序列,再借助混合索引检索OpenPose 137维关键点序列,从而驱动虚拟手语者完成手语表达。该流程覆盖从韩语文本到连续手语动作的完整链条,为神经手语演员方法在韩国手语上的落地提供了可复现的数据基础。
实际应用
在实际应用层面,该数据集可服务于灾难安全信息的手语自动播报系统、公共机构无障碍服务终端以及韩国手语教学辅助工具的开发。其Stage 1语料包含20,085条韩语文本与手语gloss序列配对样本,覆盖寒冷、强风等灾害场景,能够直接用于训练面向紧急信息传递的文本到手语序列模型。混合索引机制允许系统优先调用灾难领域关键点,并以词典资源作为通用词汇补充,从而在非商业研究原型中实现较高覆盖率的自动手语内容生成,为听障人士获取关键信息提供技术支持。
衍生相关工作
该数据集衍生自docent_AI_sign_research_02项目,其核心思路借鉴了CVPR 2024提出的Neural Sign Actors方法,并将其Path B词典式路线适配至韩国手语场景。围绕该数据集已形成一系列相关工作,包括基于KLUE-BERT的韩语文本到手语gloss序列转换模型、混合索引构建与验证流程、以及OpenPose 137关键点提取管线。这些工作共同推动了韩国手语神经生成从概念验证向系统化数据基础设施的演进,并为后续引入非手动信号规则与多手语者扩展研究奠定了基础。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

