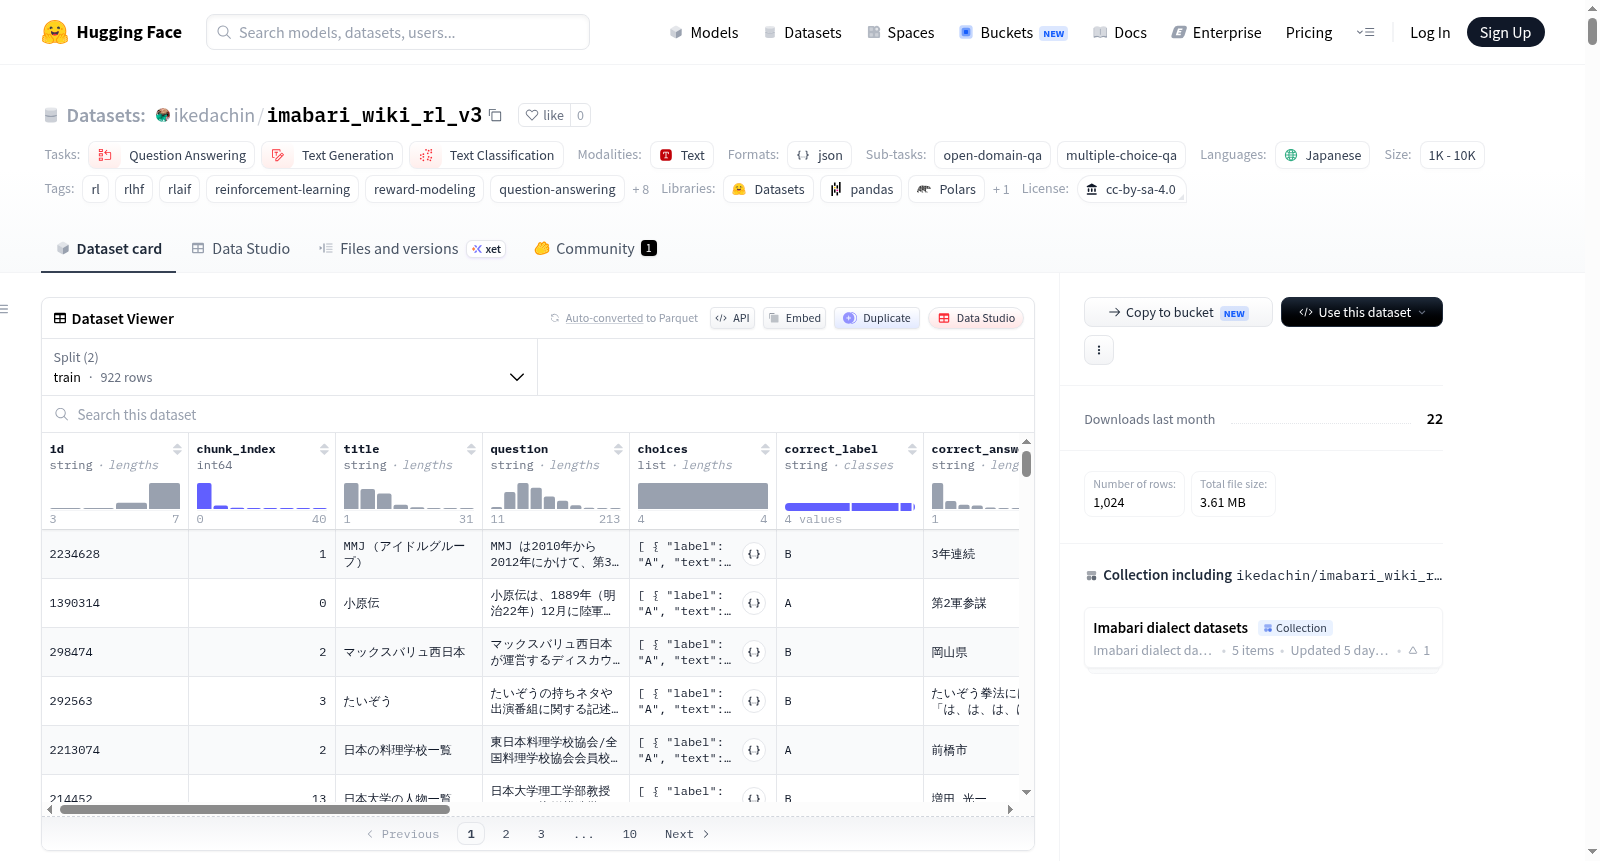
imabari_wiki_rl_v3
收藏资源简介:
Imabari Wiki RL v3数据集是一个专为日语强化学习设计的合成数据集,基于本地知识源数据集`ikedachin/imabari_wiki_cpt_v3`构建。它旨在支持RLHF、RLAIF、GRPO、PPO等强化学习训练流程,以及奖励建模、基于证据的问答评估和本地知识问答对齐等任务。数据集包含1024个日语多项选择题问答示例,其中训练集922个,验证集102个。每个示例结构丰富,包括问题、带标签的选项、正确答案标签和文本。其核心特色是同时提供“盲答”(不基于证据生成的答案)和“基于证据的答案”,并附有支持证据文本。此外,每个样本还包含难度评级、RL训练适用性标签、拒绝原因、QA生成模型信息以及ChatML格式的对话消息。该数据集主要用于优化语言模型在事实准确性、证据利用、答案校准和多项选择推理方面的能力,而非简单的答案模仿。用户可通过过滤`rl_suitability`为“accepted”的样本来获取适用于RL训练的数据子集。需要注意的是,数据集为合成生成,可能包含事实错误、幻觉或过时信息,且反映了源数据的覆盖偏差,不建议用于高风险决策或作为绝对事实来源。
The Imabari Wiki RL v3 dataset is a synthetic dataset specifically developed for Japanese-language reinforcement learning applications, constructed upon the local knowledge source dataset `ikedachin/imabari_wiki_cpt_v3`. It is designed to support reinforcement learning training pipelines including RLHF, RLAIF, GRPO, and PPO, as well as tasks such as reward modeling, evidence-based question answering (QA) evaluation, and local knowledge QA alignment. The dataset comprises 1,024 Japanese multiple-choice QA examples, with 922 samples in the training split and 102 in the validation split. Each example features a comprehensive structure, containing the question, labeled options, correct answer label, and corresponding text. Its core distinctive feature is the provision of both "blind answers" (answers generated without leveraging supporting evidence) and "evidence-based answers", accompanied by supporting evidence texts. Additionally, each sample includes a difficulty rating, RL training suitability label, rejection reason, QA generation model information, and ChatML-formatted conversation messages. This dataset is primarily intended to optimize language models' capabilities in factual accuracy, evidence utilization, answer calibration, and multiple-choice reasoning, rather than simple answer imitation. Users can acquire the data subset suitable for RL training by filtering samples where the `rl_suitability` field is set to "accepted". Notably, the dataset is synthetically generated and may contain factual errors, hallucinations, or outdated information, and reflects the coverage bias of the source data. It is not recommended for high-risk decision-making or as an absolute factual source.
数据集概述
数据集名称: Imabari Wiki RL v3 Dataset (今治 Wiki RL v3 データセット)
许可证: cc-by-sa-4.0
语言: 日语 (ja)
数据集大小: n<1K (训练集 922 个样本,验证集 102 个样本)
任务类别: 问答 (question-answering)、文本生成 (text-generation)、文本分类 (text-classification)
数据集标签: 强化学习 (rl)、RLHF、RLAIF、GRPO、PPO、奖励建模、问答、选择题、日语、今治、爱媛、本地知识、合成数据、基于证据的问答、ChatML
数据集详情
该数据集是基于源数据集 ikedachin/imabari_wiki_cpt_v3 创建的日语强化学习数据集。它包含基于源数据集中本地知识的选择题问答示例。每个示例包含问题、答案选项、正确答案标签、正确答案文本、盲答、基于证据的答案、支持性证据、难度、RL 适用性以及聊天风格的 messages。
该数据集专为日语语言模型的强化学习样式训练和评估而设计,适用于 RLHF、RLAIF、GRPO、PPO、奖励建模、基于证据的问答评估和本地知识问答对齐等场景。不同于纯 SFT 数据集,它旨在作为提示、候选答案、参考标签、基于证据的答案和面向奖励的评估信号的来源。
主要特征:
- 日语选择题问答数据集
- 为强化学习样式训练和评估设计
- 基于
ikedachin/imabari_wiki_cpt_v3的本地知识 - 包含标签为 A、B、C、D 的答案选项
- 包含正确答案标签和正确答案文本
- 包含盲答和盲答置信度
- 包含基于证据的答案和支持性证据
- 包含难度标签
- 包含 RL 适用性标签
- 包含不适合示例的拒绝原因
- 包含聊天风格的
messages - 包含 QA 生成模型的名称
- 每个记录通过
chunk_index与原始源数据块关联
数据来源:
- 源数据集:
ikedachin/imabari_wiki_cpt_v3(https://huggingface.co/datasets/ikedachin/imabari_wiki_cpt_v3) - 自身:
ikedachin/imabari_wiki_rl_v3 - QA 生成模型: Qwen3.5-35B-A3B-GPTQ-Int4
数据集结构
每个记录以 JSON Lines 格式存储,包含以下字段:
| 字段名 | 类型 | 描述 |
|---|---|---|
| id | string | 示例 ID |
| chunk_index | integer | 种子数据集中源数据块的索引 |
| title | string | 源数据块的标题或主题 |
| question | string | 选择题问题 |
| choices | list | 答案选项,每个选项包含 label 和 text |
| correct_label | string | 正确答案标签,如 A、B、C 或 D |
| correct_answer | string | 正确答案文本 |
| blind_answer | string | 未使用证据时生成的答案,可能不正确 |
| blind_confidence | string | 盲答的置信度标签 |
| grounded_answer | string | 使用证据生成或验证的答案 |
| evidence | string | 用于确定基于证据答案的支持性证据 |
| difficulty | string | 示例的难度标签 |
| rl_suitability | string | 对 RL 训练的适用性标签 |
| rejection_reason | string | 如示例不适合,则提供拒绝原因 |
| qa_generator | string | 用于生成 QA 样本的模型 |
| messages | list | 聊天格式的提示和答案 |
数据划分:
- 训练集 (train): 922 个样本
- 验证集 (validation): 102 个样本
- 总下载大小: 1,402,592 字节
- 总数据集大小: 1,793,829 字节
示例记录: json { "id": "19395", "chunk_index": 1, "title": "成人式", "question": "2018 年現在、名古屋市 16 区の成人式会場について、小学校の学区毎に主に学校施設を使用して行われているのはどの区の数か。", "choices": [{"label": "A", "text": "10 区"}, {"label": "B", "text": "12 区"}, {"label": "C", "text": "14 区"}, {"label": "D", "text": "16 区"}], "correct_label": "B", "correct_answer": "12 区", "blind_answer": "10", "blind_confidence": "中", "grounded_answer": "12", "evidence": "参照情報「成人式に関する現状と課題」の記述「名古屋市 16 区のうち、東区・中区・昭和区・熱田区を除く 12 区では、小学校の学区毎に、主に学校施設を使用して成人式を行っとるんや」に基づき、対象となる区は 12 区であることが確定します。", "difficulty": "borderline", "rl_suitability": "accepted", "rejection_reason": "", "qa_generator": "Qwen3.5-35B-A3B-GPTQ-Int4", "messages": [ {"role": "user", "content": "2018 年現在、名古屋市 16 区の成人式会場について、小学校の学区毎に主に学校施設を使用して行われているのはどの区の数か。
A. 10 区 B. 12 区 C. 14 区 D. 16 区
正しい選択肢をA、B、C、Dから1つ選んでください。"}, {"role": "assistant", "content": "B. 12 区"} ] }
数据用途
直接用途:
- 日语语言模型的强化学习
- RLHF / RLAIF 实验
- GRPO、PPO 或其他基于奖励的优化工作流
- 奖励模型训练或奖励信号设计
- 选择题问答评估
- 基于证据的问答评估
- 盲答与基于证据的答案对比
- 本地知识问答对齐
- 日语问答模型评估
- 区域聊天机器人优化
- 将 CPT/RAG 样式源数据转化为 RL 训练数据的实验
- 评估合成 QA 生成和评分流程
推荐的使用模式:
- 基于提示的 RL 训练: 使用
question和choices作为提示,根据correct_label或correct_answer给予奖励。 - 基于证据的 QA 训练: 使用
question、choices和evidence作为输入,训练模型生成grounded_answer。 - 奖励建模: 使用正确和错误的选项构建偏好对,将匹配
correct_label的响应视为首选。 - GRPO / PPO 训练: 使用选择题作为rollout提示,根据与
correct_label或correct_answer的精确匹配进行评分。 - 数据过滤: 仅使用
rl_suitability为accepted且rejection_reason为空的示例,并可通过difficulty进行分层。
不适用场景:
- 作为医疗、法律、金融或灾难响应等高风险应用唯一的事实来源
- 未经核实的官方行政指导
- 实时的旅游或公共服务信息
- 将合成证据视为始终完整或权威
- 将方言式表达视为语言上权威的今治方言
- 将数据集用作完全经核实的今治百科全书
- 将
blind_answer用作正确答案 - 将
blind_confidence视为校准的概率 - 未经检查便将
rl_suitability视为客观质量保证
数据创建
选择依据: 为向本地知识语言模型提供包含本地实体、地名、文化背景、历史信息和区域特定表达的 RL 训练数据,使其不仅能模仿答案,还能通过奖励优化答案正确性、证据使用、校准和选择题推理。
源数据: 来自 ikedachin/imabari_wiki_cpt_v3 的数据块。
生成流程:
- 从
ikedachin/imabari_wiki_cpt_v3中检索一个数据块 - 基于该数据块生成一个选择题
- 生成答案选项
- 确定正确答案标签和正确答案文本
- 在不使用证据的情况下生成或记录一个盲答
- 使用证据生成或验证一个基于证据的答案
- 添加支持基于证据答案的证据
- 分配难度和 RL 适用性标签
- 添加元数据,如 id、title、chunk_index 和 qa_generator
- 将结果转换成聊天格式的 messages
QA生成模型: Qwen3.5-35B-A3B-GPTQ-Int4
评估与奖励信号
数据集包含多个可用于评估或奖励设计的字段:
correct_label: 可用于精确匹配评分。correct_answer: 可用于答案文本匹配。blind_answer: 可作为基线响应。grounded_answer: 可作为证据感知的答案。evidence: 可用于检验答案是否基于证据。difficulty: 可用于课程学习或分层评估。rl_suitability: 可用于过滤 RL 训练的示例。rejection_reason: 可用于排除不合适的示例。
一个简单的奖励函数可对匹配 correct_label 的响应给予正奖励,否则给予负奖励。更高级的奖励函数还可检查答案是否与证据一致。
局限性与风险
局限性:
- 合成数据,可能包含幻觉
- 生成的问题或选项可能包含事实错误
- 源数据可能已过时
- 证据可能不完整
- 盲答可能不代表稳定的模型基线
- 基于证据的答案仍可能包含错误
- 方言式表达可能不准确代表真实今治方言
- 数据集是区域性的,可能不会提高通用 QA 能力
rl_suitability取决于数据集创建标准- 在此数据集上优化的模型可能学会利用精确匹配奖励格式
- 模型可能只学会用标签回答而不解释推理过程
- 如果包含证据进行训练,模型可能过度依赖证据样式提示
偏差:
- 反映了源数据的覆盖范围和偏差,知名地点、历史人物、寺庙、旅游景点、行政主题和公共设施可能被过度代表
- 生成的问题、选项、盲答和基于证据的答案可能包含 QA 生成模型导致的风格或事实偏差
- 难度和 RL 适用性标签可能反映了评分和过滤过程的假设
推荐:
- 训练前检查样本
- 仅使用
rl_suitability为accepted的示例 - 检查具有非空
rejection_reason的示例 - 使用
difficulty进行课程学习或评估子集划分 - 使用
correct_label进行精确匹配评分 - 使用
evidence进行基于证据的奖励设计 - 在保留的本地知识问题上评估模型
- 结合 RAG 或外部事实核查进行事实性应用
- 评分前规范化答案格式
- 避免仅依赖标签精确匹配来判断最终模型质量
引用
如果您使用此数据集,请引用此数据集和源数据集:
@misc{ikedachin_imabari_wiki_cpt_v3, title = {Imabari Wiki CPT v3}, author = {ikedachin}, year = {2026}, publisher = {Hugging Face}, howpublished = {url{https://huggingface.co/datasets/ikedachin/imabari_wiki_cpt_v3}}, note = {Source dataset. Licensed under CC BY-SA 4.0.} } @misc{ikedachin_imabari_wiki_rl_v3, title = {Imabari Wiki RL v3 Dataset}, author = {ikedachin}, year = {2026}, publisher = {Hugging Face}, howpublished = {url{https://huggingface.co/datasets/ikedachin/imabari_wiki_rl_v3}}, note = {Derived from ikedachin/imabari_wiki_cpt_v3. Licensed under CC BY-SA 4.0.} }