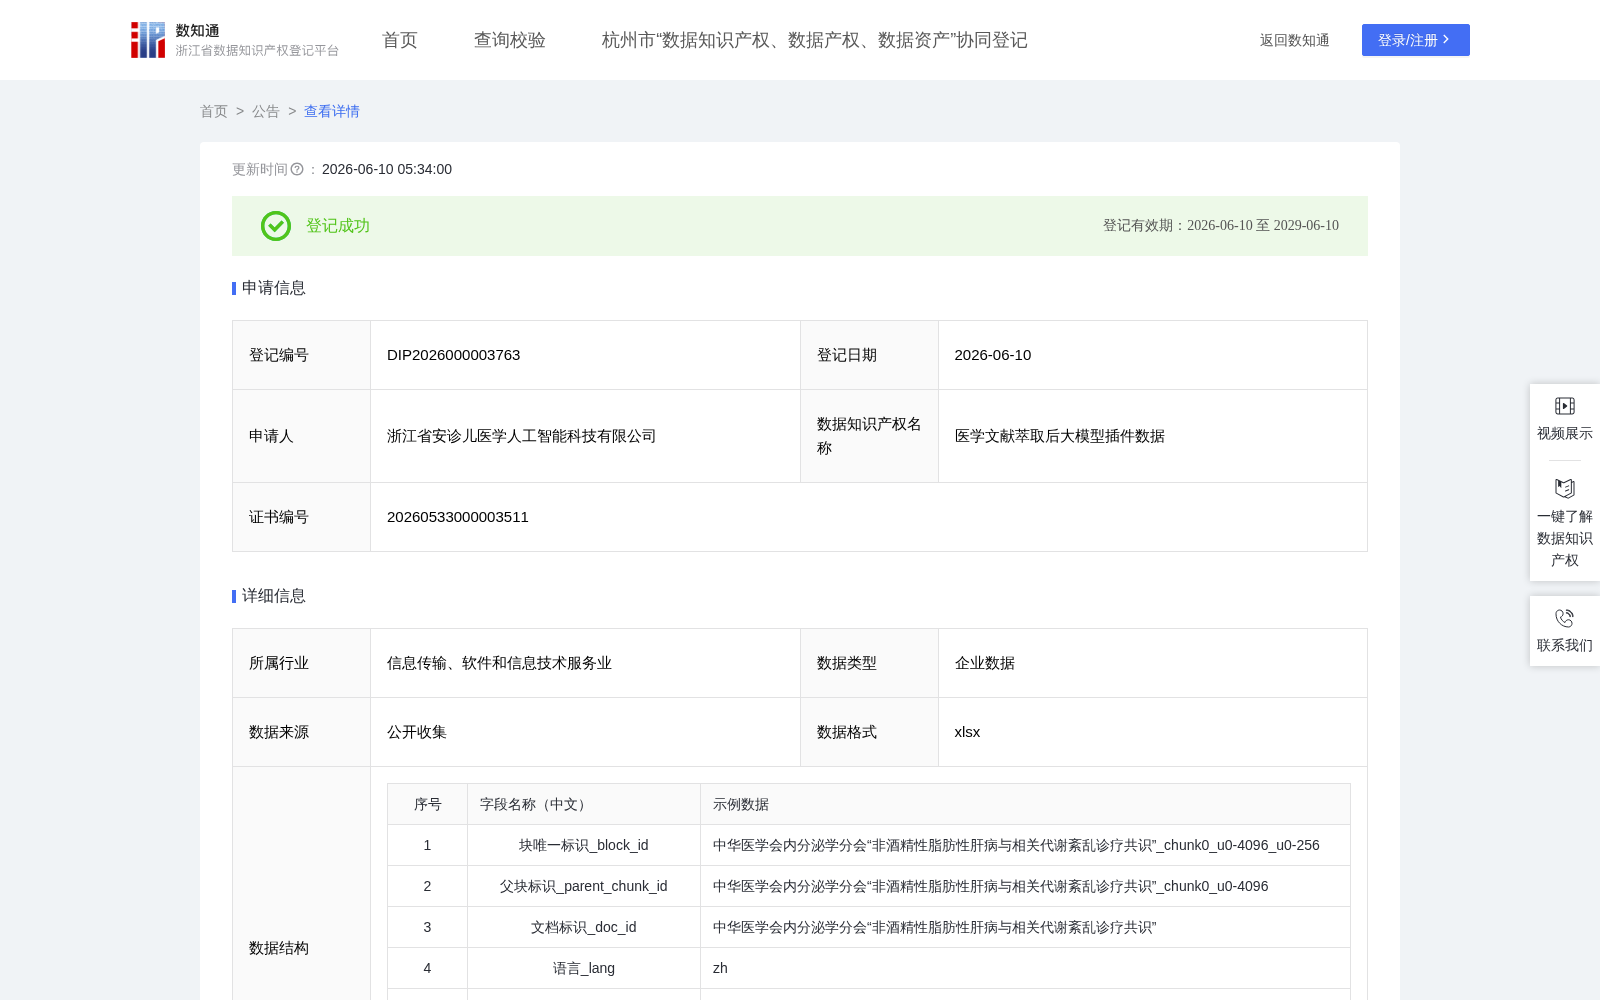
医学文献萃取后大模型插件数据
收藏资源简介:
本数据集合为自主构建的知识胶囊提取与外部KV注入(KVI)算法框架的直接产出,通过将医学文献等公开语料输入自研的文档分块与三元组提取流水线,由冻结基础大语言模型(frozen LLM)自动抽取并编译生成,是对现有公开语料进行系统性结构化转化的智力成果。生成后的数据集合本身具有独立的应用价值:作为可直接注入大语言模型注意力机制的结构化知识记忆,可在不更新任何模型参数的前提下,为各类大语言模型提供外部知识支持,适用于知识密集型问答、事实核查、幻觉抑制等多种场景。 本数据集合包含多跳关联事实、结构化知识及长上下文推理所需的高密度信息条目,适用于大语言模型在知识密集型问答场景中的检索与生成任务;适用条件为需要基于精准事实进行多步推理、处理长文本信息及跨段落或跨文档的关联知识整合;适用范围涵盖开放域通用问答、生物医药等专业领域深度问答、事实一致性核查及幻觉抑制评估等任务,适用对象包括各类基座大语言模型、检索增强生成(RAG)系统及知识增强型自然语言处理应用;通过该数据集合提供的结构化知识内存级表示,可缓解传统RAG因文本token注入导致的知识传递间接性、长上下文或多跳推理不稳定等问题。一、加工前的数据说明 原始数据为公开领域非个人文本语料,涵盖通用百科文档、生物医药学术文献、公开QA基准数据集等,来源于维基百科、公开学术语料库等合法公共知识资源。数据不含任何个人身份信息、隐私或敏感信息,无需开展脱敏处理。 二、处理规则 基于冻结大语言模型(frozen LLM)构建知识胶囊提取与外部KV注入(KVI)算法框架,主要处理步骤如下: 1. 文档分块:按段落对原始文档进行滑动窗口切分,生成具有层级关系的文本块,形成块唯一标识(block_id)、父块标识(parent_chunk_id)、文档标识(doc_id)及Token数量、窗口起止位置、重叠与步长等分块参数字段。 2. 元数据标注:对每个分块提取文档级元数据,包括语言(lang)、是否OCR(ocr_used)、段落类型(paragraph_type)等共11个字段。 3. 三元组抽取与语义标注:通过冻结LLM对分块文本抽取关系三元组(主体-关系-客体),并进行情感极性判断与语义类型分类,生成情感极性(polarity)和语义类型(semantic_type)字段。 4. 知识图谱构建与KV张量编译:以三元组为基础构建知识图谱,将胶囊编译为实体锚点KV张量(Entity Anchor KV)与三元组KV张量(Triple KV),以JSON/Parquet格式存入KV Bank,供推理阶段注入Transformer注意力层。 三、数据内容描述 处理后生成结构化知识数据,包含以下四类字段: 1. 文档分块层:block_id、parent_chunk_id、块窗口起止Token、块重叠/步长Token等分块参数字段,描述知识胶囊的文本切分来源与粒度。 2. 元数据层:lang、ocr_used、提取页数、文本/表格字符数、paragraph_type、文档表格数、knowledge_filter等,标识来源文献的语言类型、获取方式、内容规模及领域分类。 3. 语义标注层:polarity(正负极性)和semantic_type(语义类别,如流行病学事实、风险因素、控制策略等),为知识检索与推理提供结构化语义索引。 4. 知识表示层:由图谱构建与KV编译算法生成,三元组关系映射为图谱边,实体与三元组编译为预计算KV张量,存入KV Bank,可直接注入Transformer注意力层,无需重新编码。