sts-tr-magibu
收藏资源简介:
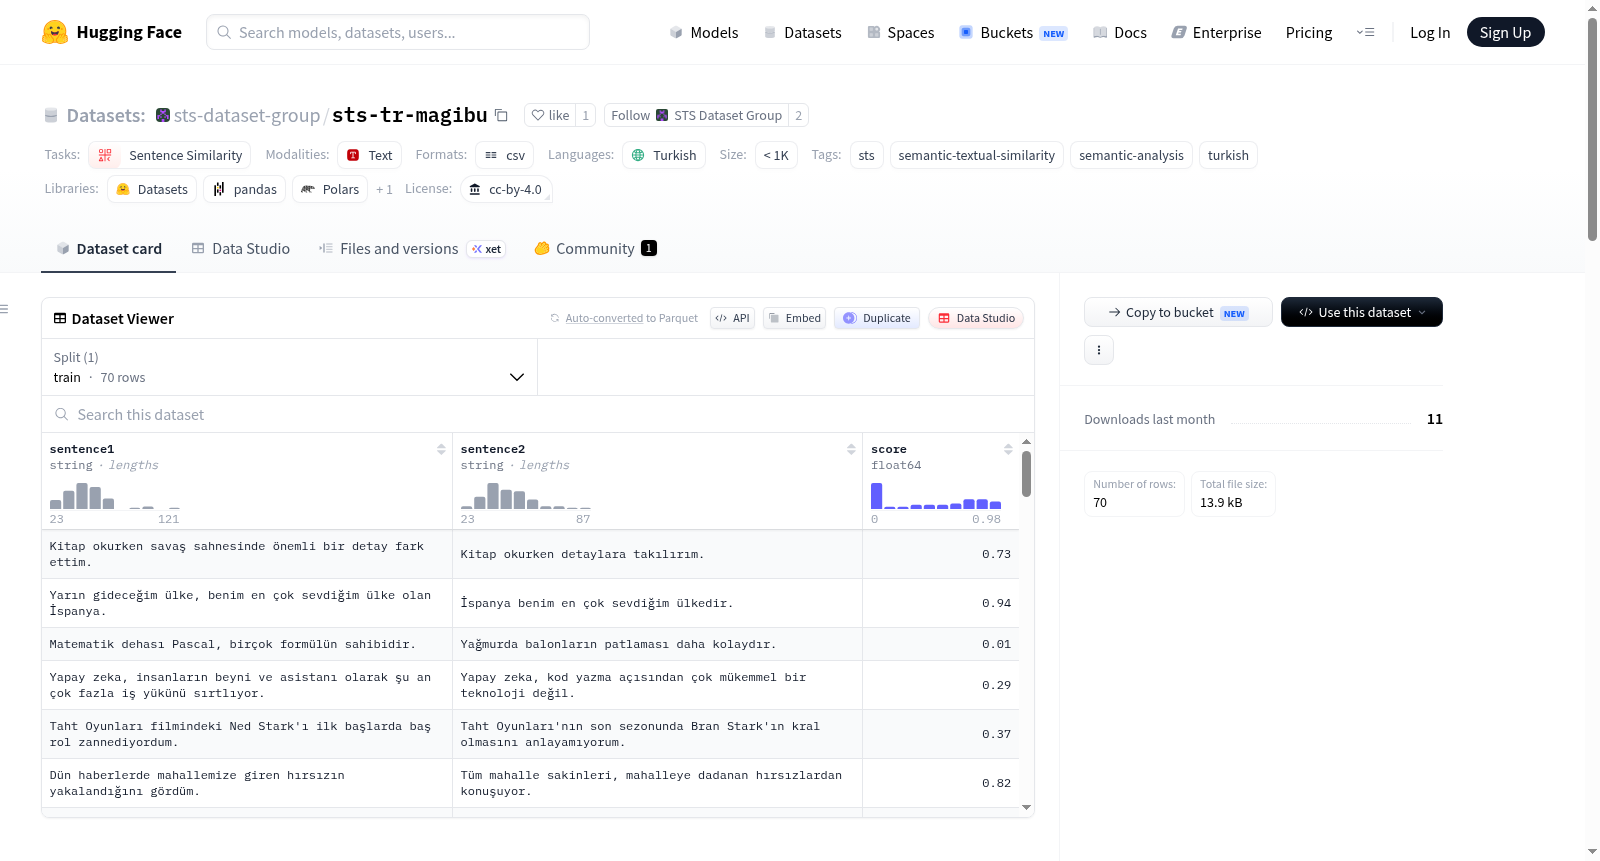
STS-TR是一个面向土耳其语的语义文本相似度(STS)数据集,由学生团队项目创建,参考了trmteb/stsb-tr数据集的结构。该数据集旨在支持土耳其语句子对的语义相似性分析和相关研究。数据集包含70个句子对,其中15对由人工完全手动编写,并特别包含了11对完全无关的句子。句子对覆盖了不同的语义关系级别:相同或几乎相同、高度相似、部分相似或相关主题、弱相关、反义以及完全无关。数据集包含三个字段:sentence1(第一句)、sentence2(第二句)和score(语义相似度分数,初始为空,由评分者根据0-1的尺度手动标注)。评分参考尺度包括:1.00(完全相同)、0.75(高度相似)、0.50(部分相似或相关主题)、0.25(弱相关)、0.00(完全无关),允许使用中间值进行更细致的评分。数据集以CSV格式存储,采用CC BY 4.0许可证,适用于教育和小规模土耳其语语义相似度研究。
STS-TR is a Turkish Semantic Textual Similarity (STS) dataset created by a student team project, referencing the structure of the trmteb/stsb-tr dataset. It aims to support semantic similarity analysis and related research on Turkish sentence pairs. The dataset contains 70 sentence pairs, of which 15 are manually written entirely by humans, and includes 11 completely unrelated pairs. The pairs cover different levels of semantic relation: identical or almost identical, highly similar, partially similar or related topics, weakly related, opposite meaning, and completely unrelated. The dataset has three fields: sentence1, sentence2, and score (a semantic similarity score initially empty, manually annotated by raters on a 0-1 scale). The reference scale includes: 1.00 (identical), 0.75 (highly similar), 0.50 (partially similar or related topic), 0.25 (weakly related), 0.00 (completely unrelated), with intermediate values allowed for finer granularity. The dataset is stored in CSV format, licensed under CC BY 4.0, and suitable for educational and small-scale Turkish semantic similarity research.
STS-TR Türkçe Cümle Benzerliği Veri Seti
数据集概述
STS-TR,全称为“STS-TR Öğrenci Grup Projesi”,是一个用于土耳其语语义文本相似度(STS)研究的小规模数据集。该数据集由学生小组项目制作,参考了 Hugging Face 上的 trmteb/stsb-tr 数据集结构,旨在为土耳其语句子对的语义相似度分析提供数据资源。
基本信息
- 语言: 土耳其语(tr)
- 许可证: CC BY 4.0
- 任务类别: 句子相似度(sentence-similarity)
- 标签: STS、语义文本相似度、语义分析、土耳其语
- 数据集规模: n < 1K(少于1000个样本)
- 配置文件: default(包含一个训练集,数据文件为
sts_tr_dataset.csv)
数据内容
数据集共包含 70 对土耳其语句子,其中:
- 15 对 完全由人工编写
- 11 对 为完全不相关的句子
其余句子对覆盖了不同语义关联程度,包括:
- 意义相同或几乎相同的句子
- 高度相似的句子
- 部分相似或涉及同一主题的句子
- 低度相关的句子
- 意义相反的句子
- 完全无关的句子
数据列说明
| 列名 | 描述 |
|---|---|
sentence1 |
句子对中的第一个句子 |
sentence2 |
句子对中的第二个句子 |
score |
两句之间的语义相似度分数 |
注意: score 列在首次上传时被有意留空,计划由小组成员根据语义关联程度在 0 到 1 之间 进行打分。
评分标准
| 分数 | 语义关联程度 |
|---|---|
| 1.00 | 句子意义相同或几乎相同 |
| 0.75 | 句子高度相似 |
| 0.50 | 句子部分相似或主题相关 |
| 0.25 | 句子之间存在弱语义关联 |
| 0.00 | 句子完全不相关 |
可以使用中间值(如 0.60 或 0.85)以更细致地反映相似度程度。
文件结构
数据集包含两个文件:
README.mdsts_tr_dataset.csv
CSV 文件包含三列:sentence1,sentence2,score。
参考来源
参考数据集:trmteb/stsb-tr
许可证
该数据集以 CC BY 4.0 许可证发布,仅供教育用途使用。