遇见数据集

malaria-medgemma-pairs

收藏
Hugging Face2026-05-31 更新2026-06-01 收录
官方服务:

资源简介:

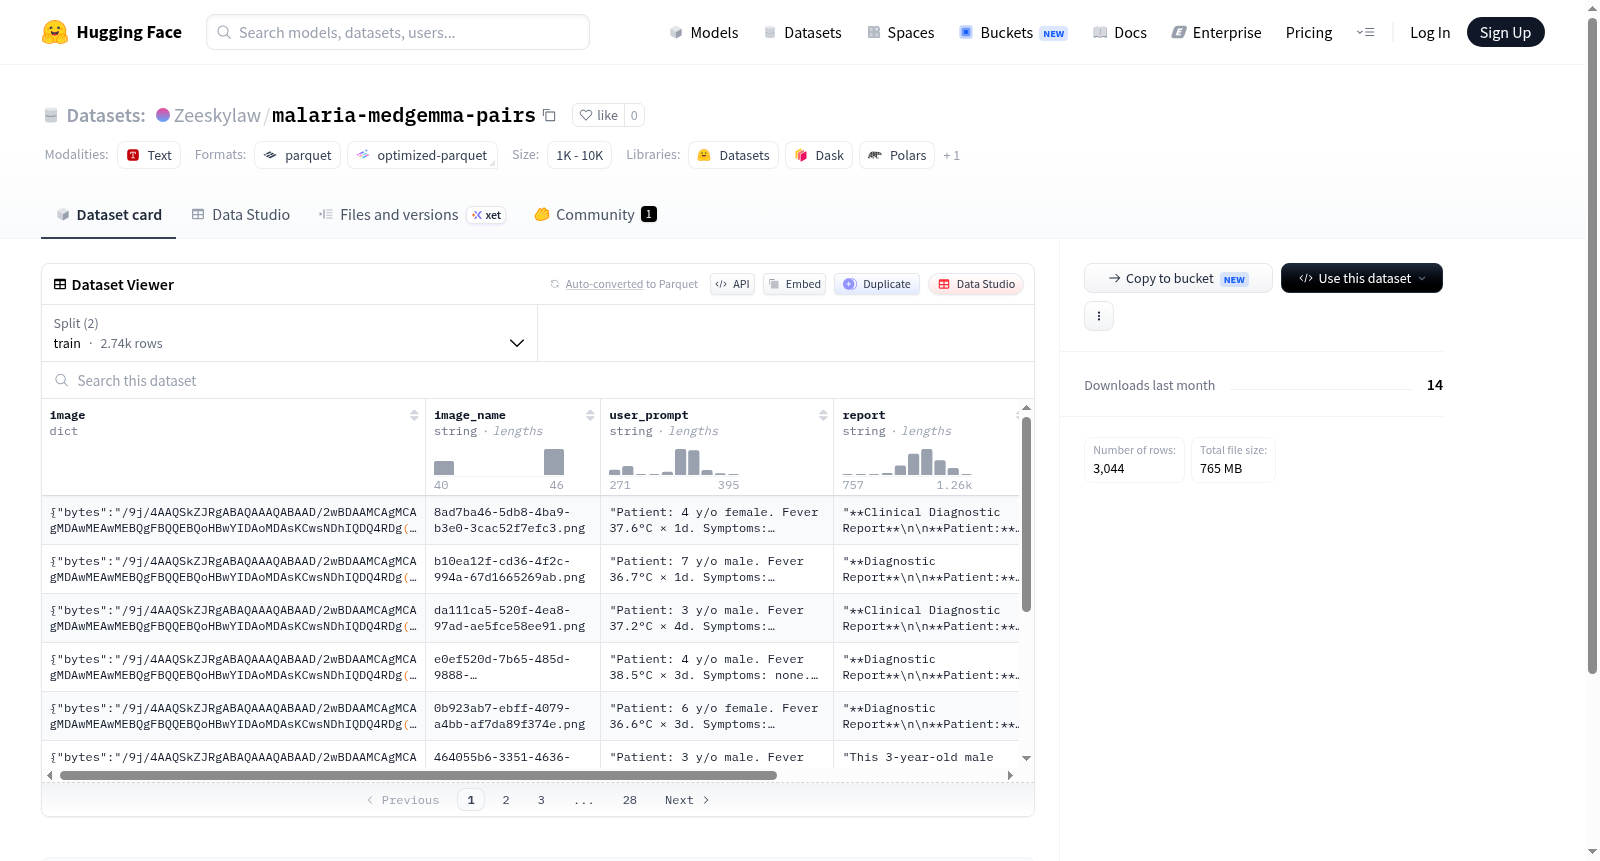
该数据集是一个医学影像分析数据集,包含3044个样本,分为训练集(2739个样本)和验证集(305个样本)。数据集包含图像和文本多模态数据:图像数据以二进制格式存储,同时包含图像路径信息;文本数据包括用户提示(user_prompt)、医学报告(report)和数据来源(source)。每个样本还包含parasitemia(寄生虫血症)的浮点数值标签,表明数据集专注于寄生虫感染相关的医学影像分析任务。数据集适用于结合视觉和文本信息的医学诊断辅助任务,如图像描述生成、病理报告自动生成或寄生虫感染程度评估。

This is a medical imaging analysis dataset consisting of 3044 total samples, split into a training set (2739 samples) and a validation set (305 samples). The dataset includes multi-modal data with both image and text modalities: the image data is stored in binary format and includes image path information. The text data includes user_prompt, medical report, and data source. Each sample additionally contains a floating-point numerical label for parasitemia, indicating that the dataset focuses on medical imaging analysis tasks related to parasitic infections. This dataset is applicable to medical diagnosis assistance tasks that combine visual and textual information, such as image caption generation, automatic pathology report generation, and parasitic infection severity assessment.

创建时间:
2026-05-30
原始信息汇总

数据集详情:malaria-medgemma-pairs

基本信息

  • 来源平台:Hugging Face Datasets
  • 数据集地址:https://huggingface.co/datasets/Zeeskylaw/malaria-medgemma-pairs

数据特征

该数据集包含以下字段:

  • image:图像数据,包含 bytes(二进制)和 path(路径)两个子字段
  • image_name:图像名称(字符串)
  • user_prompt:用户提示文本(字符串)
  • report:报告文本(字符串)
  • source:数据来源(字符串)
  • parasitemia:寄生虫血症指标(浮点数)

数据集划分与规模

数据划分 样本数量 数据大小
训练集 (train) 2,739 条 690,465,483 bytes
验证集 (validation) 305 条 77,875,741 bytes
总计 3,044 条 768,341,224 bytes
  • 下载大小:765,142,221 bytes

数据配置

  • 配置名称:default
  • 训练集路径data/train-*
  • 验证集路径data/validation-*
搜集汇总
数据集介绍
malaria-medgemma-pairs 数据集图片
构建方式
该数据集是基于疟疾领域医学影像与临床诊断报告构建的成对数据资源。首先,从公开医学图像库中筛选出带有寄生虫血症(parasitemia)量化指标的薄血涂片图像,共计3044张。随后,由医学专家为每张图像撰写结构化诊断报告(report),并设计用户查询提示(user_prompt)以模拟临床问答场景。数据被划分为训练集(2739例)和验证集(305例),并保留了图像名称(image_name)、来源(source)等元信息。最终以Parquet格式压缩存储,总大小约765MB,确保了数据的高效加载与兼容性。
特点
本数据集的核心特色在于其多模态对齐能力:每一图像均配有人工精标注的临床报告与用户提示,形成‘图像-提示-报告’三元组结构。寄生虫血症指标以浮点数形式嵌入,可支持定量分析任务。数据集设计兼顾了医学专业性与应用便利性——报告中包含疟疾分型、虫体密度等关键信息,而用户提示则模拟真实诊断流程中的提问逻辑(如‘请描述该涂片中的疟原虫形态’)。此外,数据来源的标注(source字段)便于溯源与交叉验证,适用于医学图像描述生成、视觉问答及报告准确性评估等研究。
使用方法
用户可通过HuggingFace Datasets库直接加载该数据集,仅需一行代码即可获取训练与验证分片。加载后,每一条数据包含二进制图像(image字段)、字符串格式的临床报告(report)及用户提示(user_prompt)。建议将图像解码为PIL或Tensor格式,配合预训练的视觉语言模型(如LLaVA-Med、Med-PaLM)进行微调。寄生虫血症值(parasitemia)可作为回归任务的标签,用于评估模型对病变严重程度的量化理解。数据集预设的train/validation划分已支持标准化评估,无需额外拆分。
背景与挑战
背景概述
疟疾作为全球公共卫生的重大威胁,其快速、准确的诊断对于疾病防控至关重要。传统显微镜检测依赖专业人员,耗时且易受主观因素影响,而基于深度学习的医学影像分析为该问题提供了新的解决方案。malaria-medgemma-pairs数据集由相关研究机构于近期创建,旨在构建疟疾薄血涂片图像与结构化医学报告之间的配对数据,以支持多模态大语言模型在疟疾诊断领域的应用。该数据集包含2739张训练图像及305张验证图像,每张图像均配有用户提示、专业报告及寄生虫密度标注,为探索图像理解与语言生成联合任务提供了宝贵资源。通过将视觉特征与临床文本描述对齐,该数据集有望推动智能诊断系统从单纯的图像分类向可解释性更强的全流程报告生成演进,对远程医疗和资源匮乏地区的疟疾筛查具有重要影响。
当前挑战
该数据集所解决的领域核心挑战在于将疟疾影像诊断从简单的图像分类提升至结构化报告自动生成,这不仅要求模型准确识别寄生虫感染状态,还需生成符合临床逻辑的文本描述。然而,薄血涂片图像的细微形态差异、染色变化及背景噪声使得模型在捕捉与语言对应的细粒度视觉特征时面临巨大困难。构建过程中,专家对图像的标注与报告撰写耗时且成本高昂,同时需要确保不同来源图像(如不同显微镜设备或实验室)的数据一致性。此外,297例验证样本相对有限,可能导致模型泛化性不足,如何在少量高质标注数据下训练出鲁棒的跨模态对齐模型,是推动该数据集实际应用的关键瓶颈。
常用场景
经典使用场景
在医学影像分析与自然语言处理交叉领域,疟疾相关数据集多聚焦于病灶检测或寄生虫计数,而malaria-medgemma-pairs数据集则独树一帜地构建了血涂片图像与临床文本报告的配对资源。其最经典的使用场景在于推动视觉语言模型(VLM)在疟疾诊断中的微调与评估,研究者可基于该数据集训练模型从显微图像中生成结构化诊断报告,或实现图像特征与临床描述间的语义对齐。此外,该数据集还为多模态学习范式提供了精细化的任务设定,如基于图像的寄生虫血症量化预测与报告生成联合建模,从而突破传统单模态诊断方法的局限性。
实际应用
在实际临床场景中,该数据集可助力构建智能辅助诊断系统,通过分析血涂片显微图像自动生成包含寄生虫密度估算的临床报告,大幅提升疟疾筛查效率。特别在医疗资源匮乏的偏远地区,此类模型可部署于移动端或边缘设备,实现快速初筛与分级诊疗建议。同时,该数据集支持的视觉语言框架还能应用于教学培训,通过图像-报告配对样本帮助医学生理解病理特征与临床表述的对应关系,从而加速诊断技能的学习进程。
衍生相关工作
基于malaria-medgemma-pairs的独特设计,学术界已衍生出多项经典工作:一线研究聚焦于MedGemma等轻量级视觉语言模型的指令微调,验证了在其基础上进行面向疟疾诊断的领域适应性能;另一方向则探索了基于提示学习的零样本报告生成,通过对比图像与文本嵌入空间中的映射一致性来优化诊断描述;此外,该数据集还被用于多任务学习框架的基准测试,整合了寄生虫检测、分类与报告生成等子任务,推动了医学多模态评估指标体系的完善。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务