
遇见数据集

pritamdeka/cord-19-abstract

收藏
Hugging Face2022-02-01 更新2024-03-04 收录
官方服务:

资源简介:

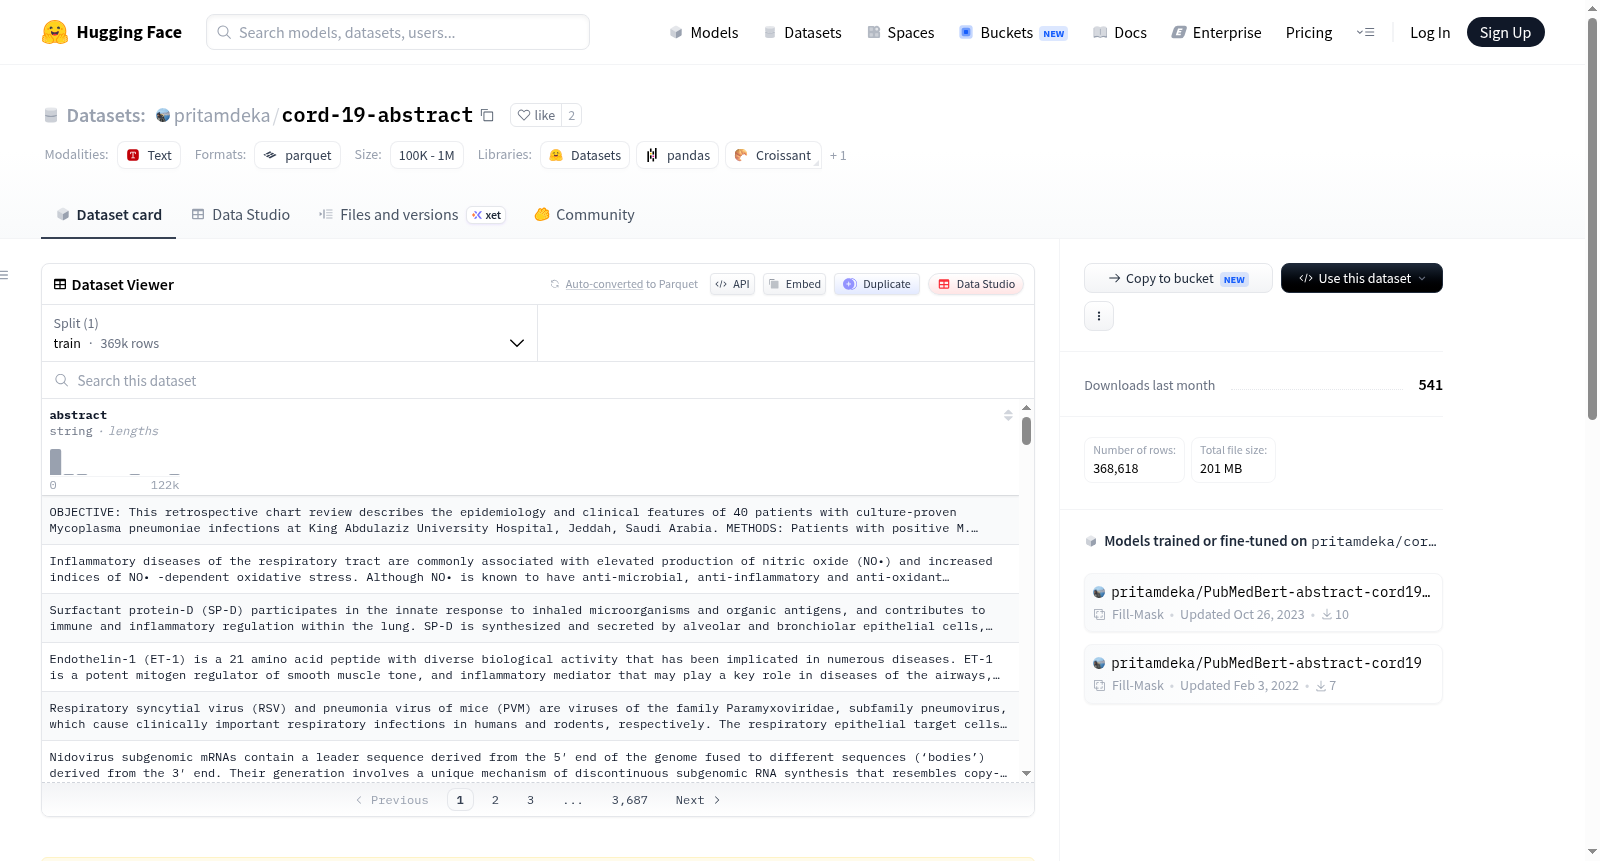
这是一个修改过的cord19数据集,仅包含摘要字段。该数据集可以直接用于语言建模任务。

This is a modified CORD-19 dataset that only includes the abstract field. This dataset can be directly used for language modeling tasks.

提供机构:
pritamdeka
原始信息汇总

数据集概述

数据集名称

[pritamdeka/cord-19-abstract]

数据集描述

数据集总结

本数据集是cord19的一个修改版本,仅包含摘要字段,适用于直接进行语言建模任务。

语言

英语

引用信息

@article{Wang2020CORD19TC, title={CORD-19: The Covid-19 Open Research Dataset}, author={Lucy Lu Wang and Kyle Lo and Yoganand Chandrasekhar and Russell Reas and Jiangjiang Yang and Darrin Eide and K. Funk and Rodney Michael Kinney and Ziyang Liu and W. Merrill and P. Mooney and D. Murdick and Devvret Rishi and Jerry Sheehan and Zhihong Shen and B. Stilson and A. Wade and K. Wang and Christopher Wilhelm and Boya Xie and D. Raymond and Daniel S. Weld and Oren Etzioni and Sebastian Kohlmeier}, journal={ArXiv}, year={2020} }
搜集汇总
数据集介绍
pritamdeka/cord-19-abstract 数据集图片
构建方式
该数据集源自CORD-19(COVID-19开放研究数据集),由pritamdeka团队进行精简与重构。原始CORD-19汇聚了全球范围内关于新冠病毒及相关冠状病毒的海量学术文献,涵盖全文、元数据等丰富信息。在此基础上,构建者通过提取每篇文献的摘要字段,剔除了正文、参考文献等冗余内容,形成了仅包含摘要文本的专门化子集。这一过程保留了文献的核心研究要点,同时大幅压缩了数据规模,便于高效处理与存储。数据集以英文为主,确保了语言的一致性,适用于自然语言处理领域的后续建模任务。
特点
该数据集的核心特点在于其高度聚焦与轻量化设计。仅包含摘要字段,使其成为针对语言建模任务的理想选择,避免了处理冗长全文带来的计算开销。摘要本身作为学术文献的精炼概括,蕴含了研究背景、方法、结果与结论等关键信息,为模型提供了密集且语义丰富的训练语料。此外,数据集继承了CORD-19的权威性与时效性,覆盖了COVID-19疫情期间及前后相关研究的广泛主题,具有鲜明的领域针对性。其简洁的结构也便于快速加载与预处理,降低了使用门槛。
使用方法
该数据集可直接用于语言建模任务,如预训练、微调或特征提取。用户可通过HuggingFace的datasets库轻松加载,调用load_dataset('pritamdeka/cord-19-abstract')即可获取数据。每条样本为一个包含摘要文本的字典,无需额外清洗即可输入模型。适用于构建领域特定的语言模型,例如用于生成医学摘要、挖掘研究趋势或训练文本分类器。研究者可根据需求对摘要进行分词、编码或嵌入,并集成至下游流程中。建议在使用前进行简单的文本规范化处理,以确保与模型兼容性。
背景与挑战
背景概述
在新型冠状病毒肺炎(COVID-19)全球大流行的背景下,科学界以前所未有的速度产出海量相关文献,然而这些知识的分散性严重阻碍了信息的高效获取与利用。为应对这一挑战,艾伦人工智能研究所、白宫科学技术政策办公室等多家机构于2020年联合发布了COVID-19开放研究数据集(CORD-19)。该数据集汇聚了超过数十万篇关于冠状病毒及相关主题的学术论文,核心研究问题在于如何通过自然语言处理技术,从非结构化的文本中快速提取关键见解,以辅助临床决策、药物研发与公共卫生政策制定。pritamdeka/cord-19-abstract作为其衍生版本,专注于提取每篇论文的摘要部分,为语言建模任务提供了更为精炼且聚焦的研究素材,对推动文本挖掘与知识发现领域的发展具有重要影响力。
当前挑战
当前数据集面临的核心挑战首先体现在领域问题的复杂性上:COVID-19相关研究涉及病毒学、流行病学、免疫学等多学科交叉,摘要文本中充斥着大量专业术语、缩写及新兴概念,使得语言模型在语义理解与知识推理上面临严峻考验。其次,在数据集构建过程中,从原始CORD-19海量全文中精准提取摘要字段,需克服文本格式不统一、元数据缺失及部分文献摘要内容不完整等问题。此外,随着疫情发展,新文献持续涌现,如何保持数据集的时效性与动态更新,同时确保不同版本间的兼容性与可复现性,亦是后续研究需要攻克的难点。
常用场景
经典使用场景
在新冠疫情席卷全球的紧急科研背景下,大规模文献的快速分析与知识挖掘成为当务之急。pritamdeka/cord-19-abstract数据集聚焦于CORD-19文献库中的摘要字段,剔除了冗余信息,为自然语言处理模型提供了精炼且语义密集的训练语料。其最经典的用途在于语言建模任务,研究者可借助该数据集训练领域特定的预训练模型,捕捉COVID-19相关文献中独特的术语、概念与逻辑结构,从而提升模型在生物医学文本上的理解与生成能力。
衍生相关工作
围绕此数据集衍生了一系列具有影响力的工作。例如,研究者基于其训练了BioBERT、PubMedBERT等模型的领域微调版本,在COVID-19文献检索任务上取得突破。另有工作利用该数据集构建了文献摘要生成系统,自动为每篇论文生成结构化摘要。此外,结合对比学习框架,衍生出针对科学文献的语义相似度评估模型,推动了科学文献检索系统的智能化升级。这些工作共同丰富了生物医学自然语言处理的研究生态。
数据集最近研究
最新研究方向
在新冠疫情全球大流行的背景下,CORD-19数据集成为推动生物医学自然语言处理领域发展的关键资源。pritamdeka/cord-19-abstract作为其精简版本,聚焦于论文摘要文本,为语言建模任务提供了高效且专注的数据基础。当前前沿研究方向集中于利用该数据集进行预训练模型的微调与评估,特别是在疫情相关文献的语义理解、知识图谱构建及自动摘要生成等任务中。研究人员通过抽象文本的深度挖掘,探索病毒传播机制、药物重定位及公共卫生干预措施等热点议题,显著加速了科学发现与决策支持系统的迭代。该数据集的意义在于降低了计算资源门槛,促进了跨学科协作,为应对未来公共卫生危机奠定了数据驱动的技术基石。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

