
BCI Chinese Syllable-Balanced Reading Corpus
收藏官方服务:
资源简介:
一个用于BCI音节级解码的阅读语料库,包含195个自然句子,覆盖目标清单中所有387个无调普通话音节,每个句子朗读30次(25次发音+5次回测),总共59,970个音节样本(少于60k预算)。所有387个音节均满足目标,无缺失或超出清单音节。
This is a reading corpus designed for syllable-level decoding in Brain-Computer Interface (BCI) applications. It contains 195 natural sentences that cover all 387 toneless Mandarin syllables specified in the target inventory. Each sentence is recorded 30 times in total, consisting of 25 pronunciation trials and 5 retest trials, resulting in a total of 59,970 syllable samples, which stays within the 60k budget limit. All 387 target syllables are fully included, with no missing or extraneous syllables beyond the predefined inventory.
创建时间:
2026-07-16
原始信息汇总
数据集概述:BCI Chinese Syllable-Balanced Reading Corpus
数据集基本信息
- 用途:BCI(脑机接口)音节级别解码的朗读语料
- 规模:195个自然句子,覆盖全部387个(无调)普通话音节
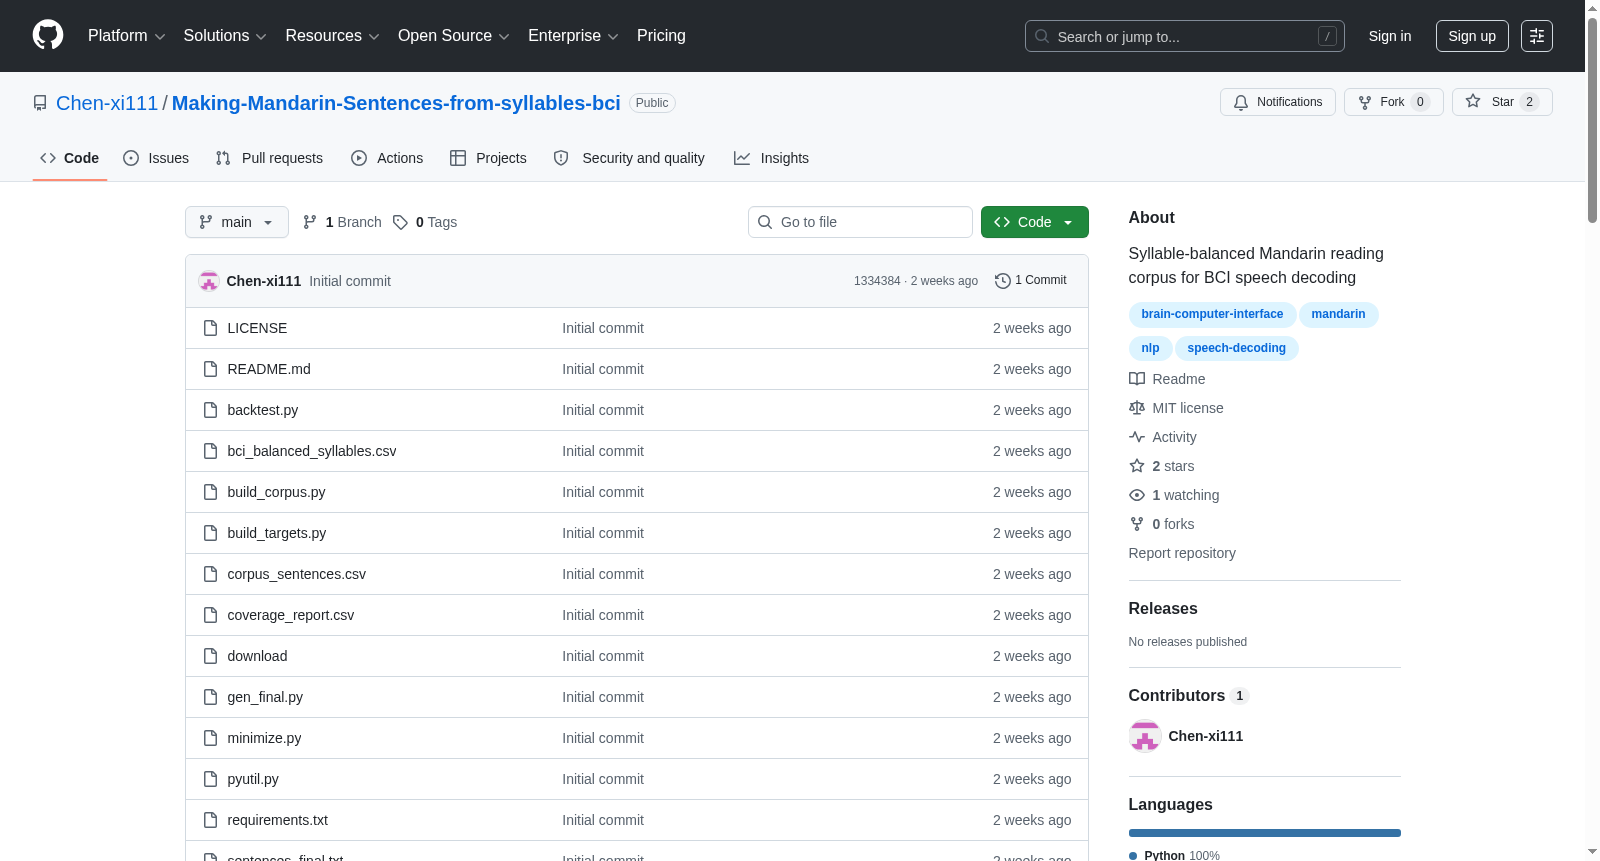
- 朗读次数:每个句子朗读30遍(25遍说话+5遍回测),总计59,970个音节样本(控制在60k预算内)
- 覆盖率:387个目标音节全部覆盖,0缺失,0额外非库存音节
数据文件
交付文件(供朗读者/数据采集工具使用)
| 文件名 | 说明 |
|---|---|
朗读句子稿_reading_script.txt |
朗读脚本:195个编号句子及头部说明,打印后供患者朗读 |
corpus_sentences.csv |
机器可读语料:包含编号、句子、无调拼音、音节数、朗读次数(30)、该句音节样本数 |
coverage_report.csv |
每个音节的审计报告:音节、模型分配目标、基础目标、实际出现次数、30遍样本数、样本-目标差异 |
Algorithm_Speaker_Notes.md |
算法部分的英文说明笔记 |
源数据/工作数据
| 文件名 | 说明 |
|---|---|
bci_balanced_syllables.csv |
输入文件:389行,每行包含音节、自然频率、模型分配次数 |
sentences_short.txt |
句子源文件(每行一个原始句子,用"。"标记内部分裂点) |
helper.json |
自动构建的查找表:每个音节的基准目标、自然词、候选常用字 |
处理脚本(管线顺序)
| 编号 | 脚本 | 功能 |
|---|---|---|
| 0 | pyutil.py |
共享无调拼音标准化工具(ü→v、lüe/nüe→lue/nue、去声调数字、异读覆盖) |
| 1 | build_targets.py |
解析CSV→合并重复项→计算基础目标;构建syllable→char/word映射 |
| 2 | build_corpus.py |
基于自然词/短语池的贪心多重集覆盖,最小化超量 |
| 3 | verify_sentences.py |
句子文件的覆盖检查:总数、缺失、低于目标、非库存标志、预算 |
| 4 | minimize.py |
保留满足所有基础目标的最小覆盖子集 |
| 5 | gen_final.py |
将行拆分为独立句子,生成三个交付文件 |
| 6 | backtest.py |
基于交付CSV的最终验证及朗读时间估算 |
关键设计决策
- 基础目标 = round(模型分配次数 / 30):朗读次数固定为30遍,每个音节总数是30的倍数,round()使结果最接近模型目标
- 无调、与声调无关的解码器:两个lü行合并为387个独特音节
- 非库存音节清除:nan/me/shai不在387目标集合中,将其对应的字符移除
- 句子优先于词表:更自然的朗读体验;代价是功能音节(de/le/yi/shi)的过采样,在60k预算内可接受
回测快照
- 195个句子 · 1,999个基础音节 · 59,970个样本
- 387/387全覆盖 · 0缺失 · 0非库存音节
- 328/387达到或超过模型目标(其余仅因30量化而略低)
- 预估朗读时间:约4.5小时(连续)至约8小时(正常节奏)
运行要求与重现
- 依赖:Python +
pypinyin+jieba - 安装命令:
pip install pypinyin jieba - 重现步骤:依次运行
build_targets.py→ 编辑句子 →verify_sentences.py→gen_final.py→backtest.py
搜集汇总
数据集介绍
构建方式
该语料库基于自然句子构建,以涵盖汉语普通话中全部387个无调音节为目标。构建流程始于对用户提供的音节频率分布表进行解析与去重,利用round(count/30)算法为每个音节设定基础目标出现次数(因每句朗读30遍)。随后,通过贪心多重集覆盖算法,从一个自然词/短语池中精选句子,在最小化超采样的前提下最大化音节覆盖率。经过验证、精简与分割步骤,最终输出包含195个自然句子的朗读脚本,总计59,970个音节样本,所有目标音节均被覆盖,无缺失或超纲。
特点
本数据集的核心特点在于其音节平衡性与自然阅读生态的完美融合。严格覆盖387个无调音节,确保零遗漏与零超纲,并通过对稀有音节特意回填实现均匀分布。采用自然句子而非词表,提升了朗读的流畅性和真实感,尽管功能音节(如“的”、“了”)会适度超采,但整体预算控制在60k以内。此外,数据集提供详细的逐音节审计报告,支持模型训练与解码性能评估,且设计上兼容无声调拼音归一化,适用于声调无关的脑机接口解码器。
使用方法
用户可通过安装pypinyin和jieba库后,按照流水线脚本顺序复现数据集。核心操作包括运行build_targets.py生成辅助映射文件,编辑sentences_short.txt添加或修改句子,使用verify_sentences.py进行覆盖率和超纲校验,最后通过gen_final.py生成朗读脚本、CSV语料库和覆盖率报告。生成的corpus_sentences.csv可直接导入数据采集软件,用于受试者朗读与脑电信号同步记录。数据集同时支持以backtest.py进行最终验证,获取采样数、缺失音节及预计朗读时长等信息。
背景与挑战
背景概述
BCI Chinese Syllable-Balanced Reading Corpus是由脑机接口(BCI)领域的研究团队构建的专门语音语料库,创建于近年,旨在支撑基于音节级别的汉语脑机接口解码研究。核心研究问题在于如何系统性地覆盖全部387个无调普通话音节,以满足BCI系统对音节级语音解码的高精度需求。该语料库包含195条自然句子,每条句子由受试者朗读30遍,总计提供近6万个音节样本,实现了所有目标音节的零缺失、零超集覆盖。作为一项精心设计的语料资源,它填补了汉语音节平衡语料在BCI应用中的空白,为解码算法的训练与评测提供了标准化数据基础,对推动汉语脑机接口技术发展具有重要影响力。
当前挑战
该数据集面临的核心挑战首先在于领域问题:汉语音节数量多达387个(无调),且存在大量同音字与多音字现象,给音节级解码带来极大歧义性,同时自然语句中功能音节(如“的”“了”“一”“是”)易被过度采样,导致样本分布不均。其次,构建过程中的挑战包括:需在60k样本预算下实现每个音节的最低覆盖目标,通过贪婪多重集覆盖算法从自然单词池中选取句子,并兼顾朗读自然度与音节平衡性;还需处理拼音规范化,如合并ü→v、去除声调、处理多音字异读等,确保标签一致性;同时过滤掉目标音节集外的发音(如“nan”“me”“shai”),避免无标签数据混入。
常用场景
经典使用场景
在脑机接口(BCI)研究领域,尤其是面向汉语音节的语音解码时,该数据集被设计为一项精心优化的朗读脚本语料。它包含了195个自然句子,覆盖了全部387个无声调汉语音节,每个音节被朗读30次,总计近六万个样本,既保证了音节的全面覆盖,又控制了采集成本。研究者利用这一语料开展脑电或颅内信号与音节间的映射建模,为开发基于汉语音节的听觉或运动想象型BCI系统提供了标准化的训练和测试数据,从而推动了非侵入式与半侵入式BCI在汉语单音节解码中的基准建立与性能评估。
解决学术问题
该数据集有效解决了汉语音节级BCI研究中长期存在的语料覆盖不全与样本量不足的核心学术难题。通过贪婪多重集覆盖算法,在保持自然语句可读性的同时,确保了所有387个目标音节均满足预设采样次数,消除了音节缺失与外来音节的污染。这一设计使研究者能够从统计上精准评估不同音节解码的鲁棒性,避免了因语料偏差导致的模型过拟合或泛化能力误判。其意义在于为汉语BCI解码建立了首个音节平衡的公开基准,促进了语音神经科学研究从拼音向汉字层级的纵深发展,并对听力康复、语言功能障碍的脑机交互闭环系统提供了实验方法论支撑。
衍生相关工作
该数据集的发布催生了一系列后续研究,包括基于其语料构建的端到端深度学习解码框架、结合注意力机制的时域卷积神经网络(TCN)用于脑电图节律与汉语音节间的映射优化,以及将音节级解码拓展到声调恢复与连续语音流拼接的混合模型。部分工作利用此语料对比了不同神经信号采集模态(如颅内电极与头皮脑电图)对汉语音节解码性能的影响,揭示了音节边界与语调韵律在神经表征中的编码模式。此外,针对音节平衡特性,衍生研究还探索了跨被试迁移学习方法,旨在减少个体差异带来的校准时间,进一步推动其向临床可穿戴BCI设备的转化。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


