enzyme_kcat
收藏资源简介:
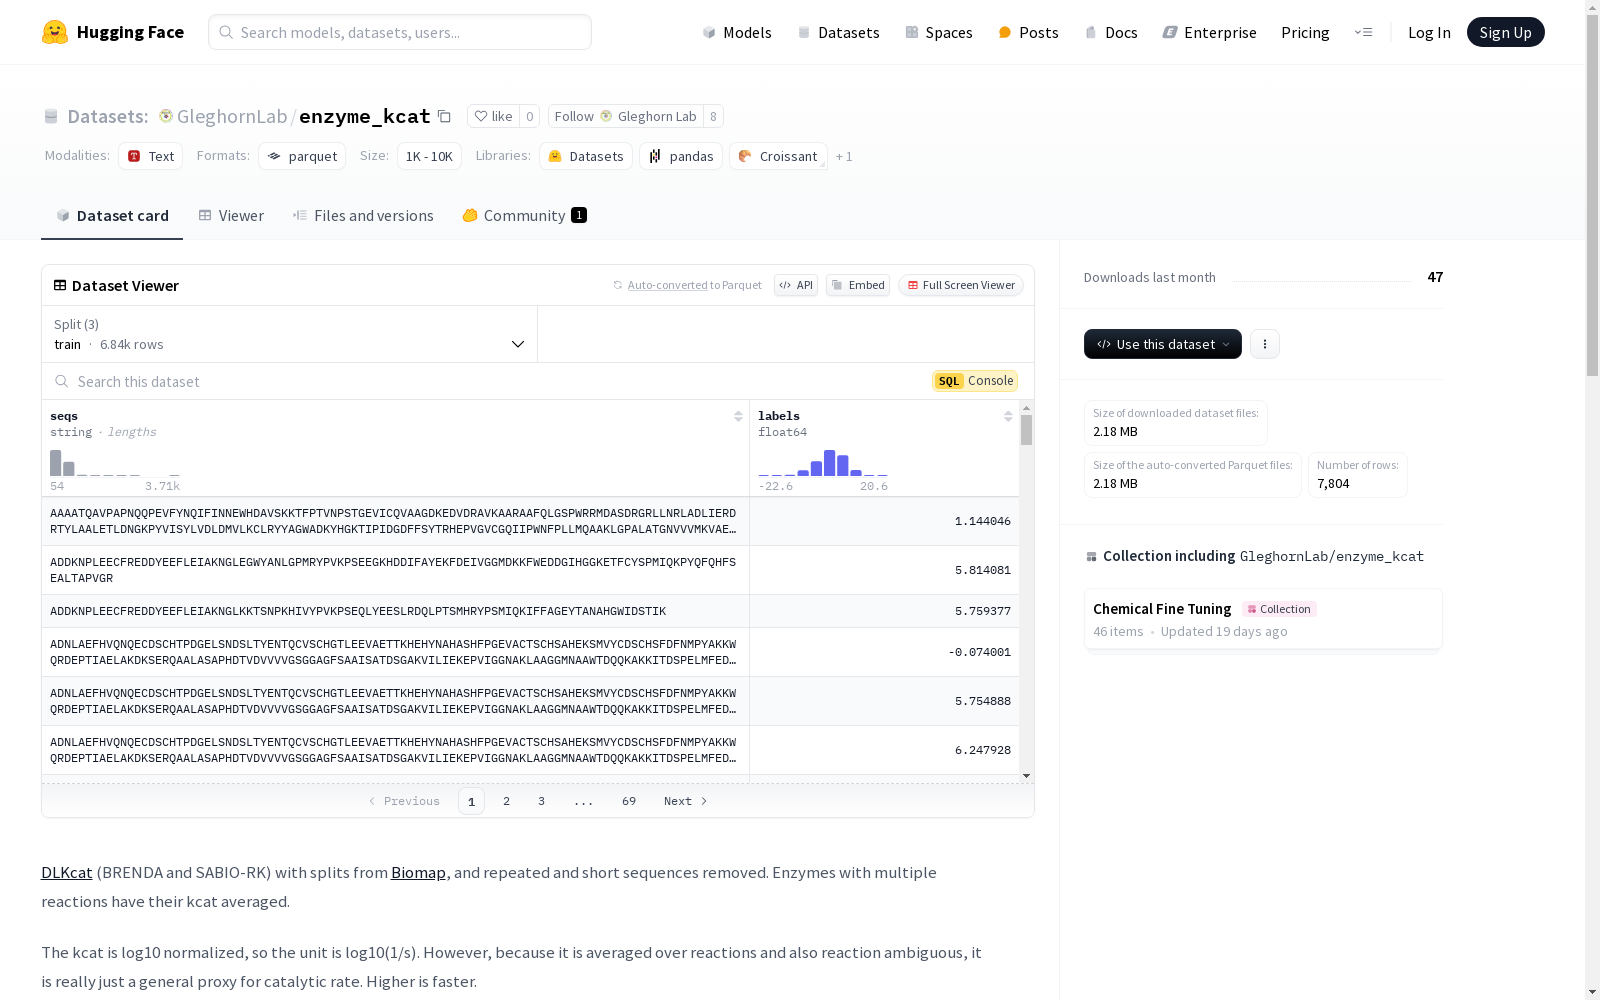
该数据集包含酶的序列和其催化效率的标签。序列('seqs')是字符串类型,标签('labels')是经过log10归一化的float64类型,单位为log10(1/s)。数据集分为训练集、验证集和测试集,分别包含6837、498和469个样本。数据集来源于DLKcat,已经去除了重复和短序列,并且酶的多反应kcat值被平均化。
This dataset contains enzyme sequences and labels corresponding to their catalytic efficiency. The sequences (denoted as 'seqs') are of string type, while the labels (denoted as 'labels') are log10-normalized float64 values with the unit of log10(1/s). The dataset is split into training, validation, and test sets, which contain 6837, 498, and 469 samples respectively. This dataset is sourced from DLKcat, where redundant and short sequences have been removed, and the multi-reaction kcat values of enzymes have been averaged.
数据集概述
数据集信息
- 特征:
seqs: 序列数据,类型为字符串 (string)labels: 标签数据,类型为浮点数 (float64)
- 分割:
train: 训练集,包含6837个样本,占用2933951字节valid: 验证集,包含498个样本,占用217038字节test: 测试集,包含469个样本,占用204262字节
- 下载大小: 2178499字节
- 数据集总大小: 3355251字节
配置
- 配置名称:
default- 数据文件路径:
train:data/train-*valid:data/valid-*test:data/test-*
- 数据文件路径:
数据处理
- 数据来源:
- kcat值:
- kcat值经过log10归一化处理,单位为log10(1/s)。
- 由于kcat值在反应中被平均化且存在反应模糊性,因此它只是一个催化速率的通用代理,数值越高表示催化速率越快。
数据处理代码
python import pandas as pd from datasets import Dataset, DatasetDict, concatenate_datasets
def process_dataset(dataset_dict): precedence = [train, valid, test] # 为每个数据集添加split列 for split in dataset_dict.keys(): dataset_dict[split] = dataset_dict[split].add_column(split, [split]*len(dataset_dict[split])) # 将所有分割合并为一个数据集 all_data = concatenate_datasets([dataset_dict[split] for split in dataset_dict.keys()]) # 转换为pandas DataFrame df = all_data.to_pandas() # 移除长度小于50的序列 df[seq_length] = df[seqs].apply(len) df = df[df[seq_length] >= 50] # 按seqs分组以查找重复项并平均标签 def aggregate_group(group): avg_label = group[labels].mean() # 将序列分配到其出现的最高优先级分割 for p in precedence: if p in group[split].values: selected_split = p break return pd.Series({labels: avg_label, split: selected_split}) df_grouped = df.groupby(seqs).apply(aggregate_group).reset_index() # 将DataFrame拆分为原始分割,且不包含重叠序列 new_dataset_dict = DatasetDict() for split in precedence: df_split = df_grouped[df_grouped[split] == split] new_dataset_dict[split] = Dataset.from_pandas(df_split[[seqs, labels]], preserve_index=False) return new_dataset_dict