
企秒云云OS系统token消耗统计数据集
收藏官方服务:
资源简介:
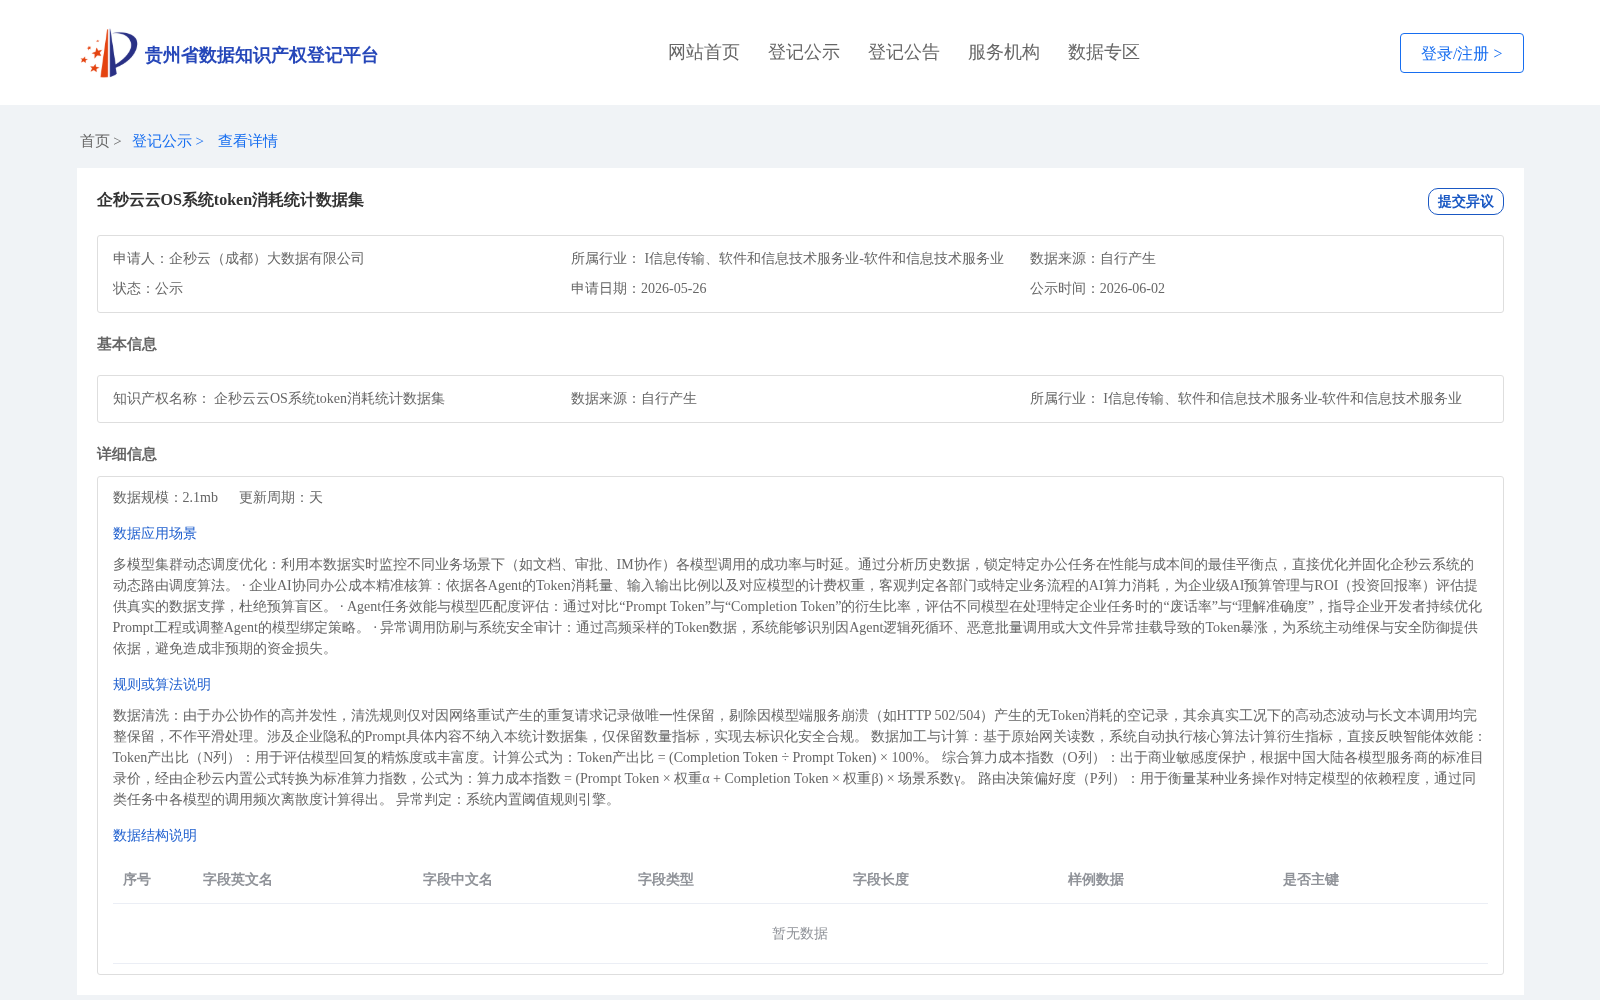
数据清洗:由于办公协作的高并发性,清洗规则仅对因网络重试产生的重复请求记录做唯一性保留,剔除因模型端服务崩溃(如HTTP 502/504)产生的无Token消耗的空记录,其余真实工况下的高动态波动与长文本调用均完整保留,不作平滑处理。涉及企业隐私的Prompt具体内容不纳入本统计数据集,仅保留数量指标,实现去标识化安全合规。 数据加工与计算:基于原始网关读数,系统自动执行核心算法计算衍生指标,直接反映智能体效能: Token产出比(N列):用于评估模型回复的精炼度或丰富度。计算公式为:Token产出比 = (Completion Token ÷ Prompt Token) × 100%。 综合算力成本指数(O列):出于商业敏感度保护,根据中国大陆各模型服务商的标准目录价,经由企秒云内置公式转换为标准算力指数,公式为:算力成本指数 = (Prompt Token × 权重α + Completion Token × 权重β) × 场景系数γ。 路由决策偏好度(P列):用于衡量某种业务操作对特定模型的依赖程度,通过同类任务中各模型的调用频次离散度计算得出。 异常判定:系统内置阈值规则引擎。
提供机构:
企秒云(成都)大数据有限公司创建时间:
2026-05-26
搜集汇总
数据集介绍
背景与挑战
背景概述
该数据集记录了企秒云云OS系统中各Agent调用大模型时的Token消耗情况,涵盖Prompt Token与Completion Token等原始指标,并衍生出Token产出比、综合算力成本指数及路由决策偏好度等关键维度。数据经过去重、剔除空记录和去标识化处理,仅保留数量指标,旨在支持多模型调度优化、企业AI成本核算、Agent任务效能评估及异常调用审计等应用场景。
以上内容由遇见数据集搜集并总结生成
相关数据集

暂无相关数据集


