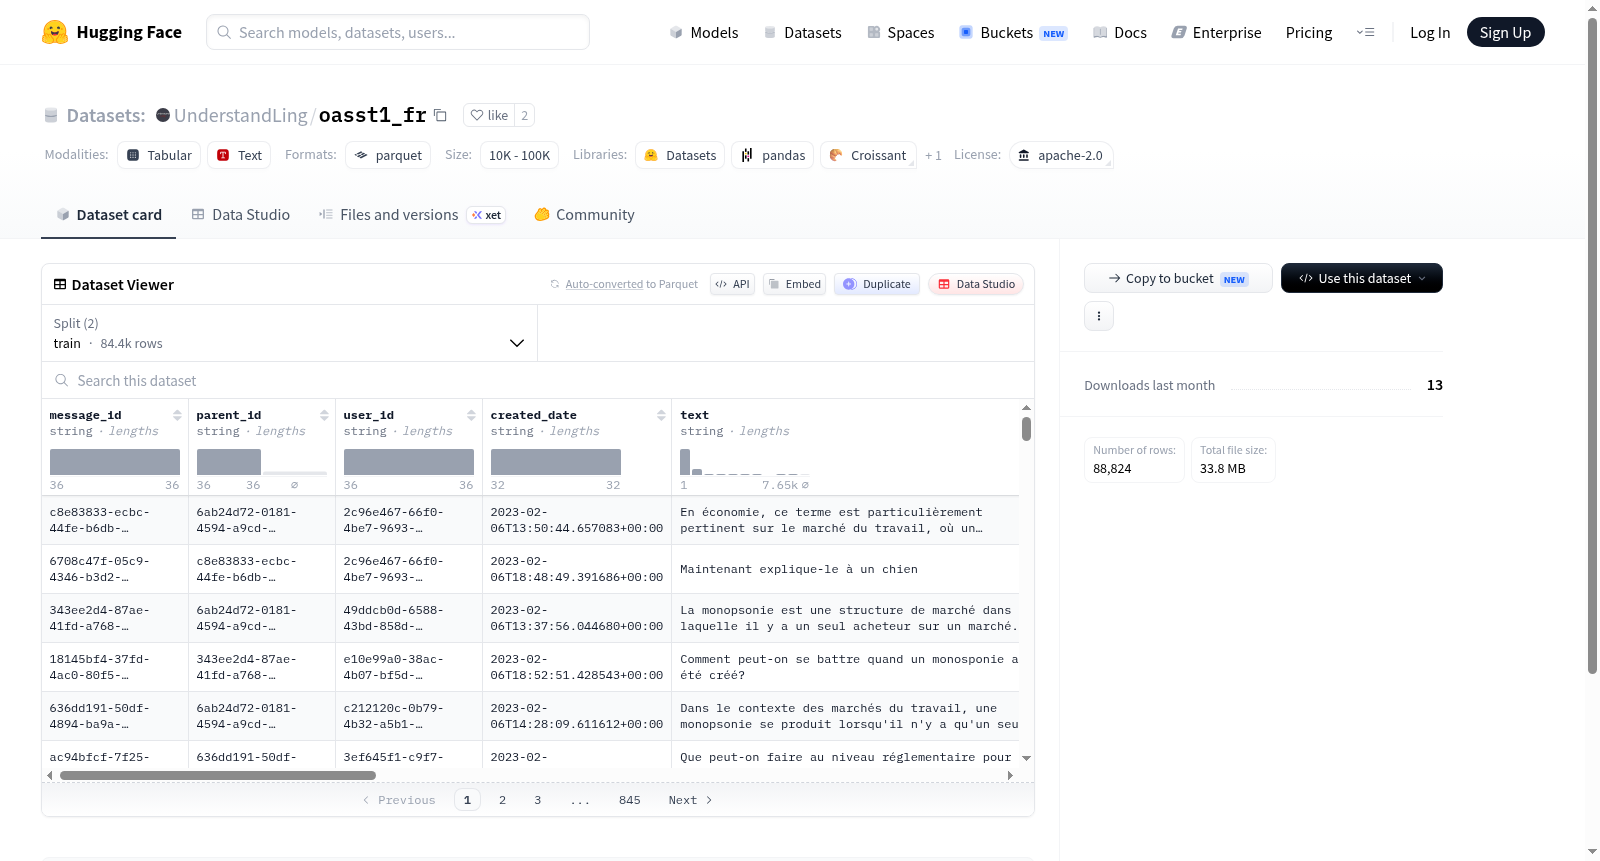
UnderstandLing/oasst1_fr
收藏资源简介:
--- license: apache-2.0 dataset_info: features: - name: message_id dtype: string - name: parent_id dtype: string - name: user_id dtype: string - name: created_date dtype: string - name: text dtype: string - name: role dtype: string - name: lang dtype: string - name: review_count dtype: int64 - name: review_result dtype: bool - name: deleted dtype: bool - name: rank dtype: float64 - name: synthetic dtype: bool - name: model_name dtype: 'null' - name: detoxify struct: - name: identity_attack dtype: float64 - name: insult dtype: float64 - name: obscene dtype: float64 - name: severe_toxicity dtype: float64 - name: sexual_explicit dtype: float64 - name: threat dtype: float64 - name: toxicity dtype: float64 - name: message_tree_id dtype: string - name: tree_state dtype: string - name: emojis struct: - name: count sequence: int64 - name: name sequence: string - name: labels struct: - name: count sequence: int64 - name: name sequence: string - name: value sequence: float64 splits: - name: train num_bytes: 93639983 num_examples: 84424 - name: validation num_bytes: 4907489 num_examples: 4400 download_size: 33824444 dataset_size: 98547472 configs: - config_name: default data_files: - split: train path: data/train-* - split: validation path: data/validation-* ---
许可证:Apache License 2.0 数据集信息: 特征: - 名称:消息ID(message_id),数据类型:字符串 - 名称:父消息ID(parent_id),数据类型:字符串 - 名称:用户ID(user_id),数据类型:字符串 - 名称:创建日期(created_date),数据类型:字符串 - 名称:文本内容(text),数据类型:字符串 - 名称:角色(role),数据类型:字符串 - 名称:语言(lang),数据类型:字符串 - 名称:审核次数(review_count),数据类型:64位整型 - 名称:审核结果(review_result),数据类型:布尔型 - 名称:是否已删除(deleted),数据类型:布尔型 - 名称:排名(rank),数据类型:64位浮点型 - 名称:是否为合成数据(synthetic),数据类型:布尔型 - 名称:模型名称(model_name),数据类型:空值(null) - 名称:毒性检测(detoxify),结构体包含以下字段: - 名称:身份攻击评分(identity_attack),数据类型:64位浮点型 - 名称:辱骂评分(insult),数据类型:64位浮点型 - 名称:淫秽内容评分(obscene),数据类型:64位浮点型 - 名称:严重毒性评分(severe_toxicity),数据类型:64位浮点型 - 名称:色情内容评分(sexual_explicit),数据类型:64位浮点型 - 名称:威胁评分(threat),数据类型:64位浮点型 - 名称:总体毒性评分(toxicity),数据类型:64位浮点型 - 名称:消息树ID(message_tree_id),数据类型:字符串 - 名称:消息树状态(tree_state),数据类型:字符串 - 名称:表情符号(emojis),结构体包含以下字段: - 名称:计数(count),数据类型:整型序列 - 名称:名称(name),数据类型:字符串序列 - 名称:标签(labels),结构体包含以下字段: - 名称:计数(count),数据类型:整型序列 - 名称:名称(name),数据类型:字符串序列 - 名称:取值(value),数据类型:浮点型序列 数据集划分: - 划分集:训练集(train),字节数:93639983,样本数:84424 - 划分集:验证集(validation),字节数:4907489,样本数:4400 下载总大小:33824444 数据集总存储大小:98547472 配置项: - 配置名称:默认配置(default),数据文件: - 训练集划分:数据路径为data/train-* - 验证集划分:数据路径为data/validation-*
数据集概述
数据集特征
- message_id: 字符串类型
- parent_id: 字符串类型
- user_id: 字符串类型
- created_date: 字符串类型
- text: 字符串类型
- role: 字符串类型
- lang: 字符串类型
- review_count: 整数类型
- review_result: 布尔类型
- deleted: 布尔类型
- rank: 浮点数类型
- synthetic: 布尔类型
- model_name: 空值类型
- detoxify: 结构体类型,包含以下子特征:
- identity_attack: 浮点数类型
- insult: 浮点数类型
- obscene: 浮点数类型
- severe_toxicity: 浮点数类型
- sexual_explicit: 浮点数类型
- threat: 浮点数类型
- toxicity: 浮点数类型
- message_tree_id: 字符串类型
- tree_state: 字符串类型
- emojis: 结构体类型,包含以下子特征:
- count: 序列整数类型
- name: 序列字符串类型
- labels: 结构体类型,包含以下子特征:
- count: 序列整数类型
- name: 序列字符串类型
- value: 序列浮点数类型
数据集划分
- train: 数据大小为93639983字节,包含84424个样本
- validation: 数据大小为4907489字节,包含4400个样本
数据集大小
- 下载大小: 33824444字节
- 数据集大小: 98547472字节
配置信息
- config_name: default
- data_files:
- train: 路径为data/train-*
- validation: 路径为data/validation-*