
jablonkagroup/ChemFuse
收藏官方服务:
资源简介:
该存储库包含用于ChemFuse中的训练、评估和下游任务的数据集。
This repository contains the datasets used for training, evaluation, and downstream tasks in the ChemFuse.
提供机构:
jablonkagroup搜集汇总
数据集介绍
构建方式
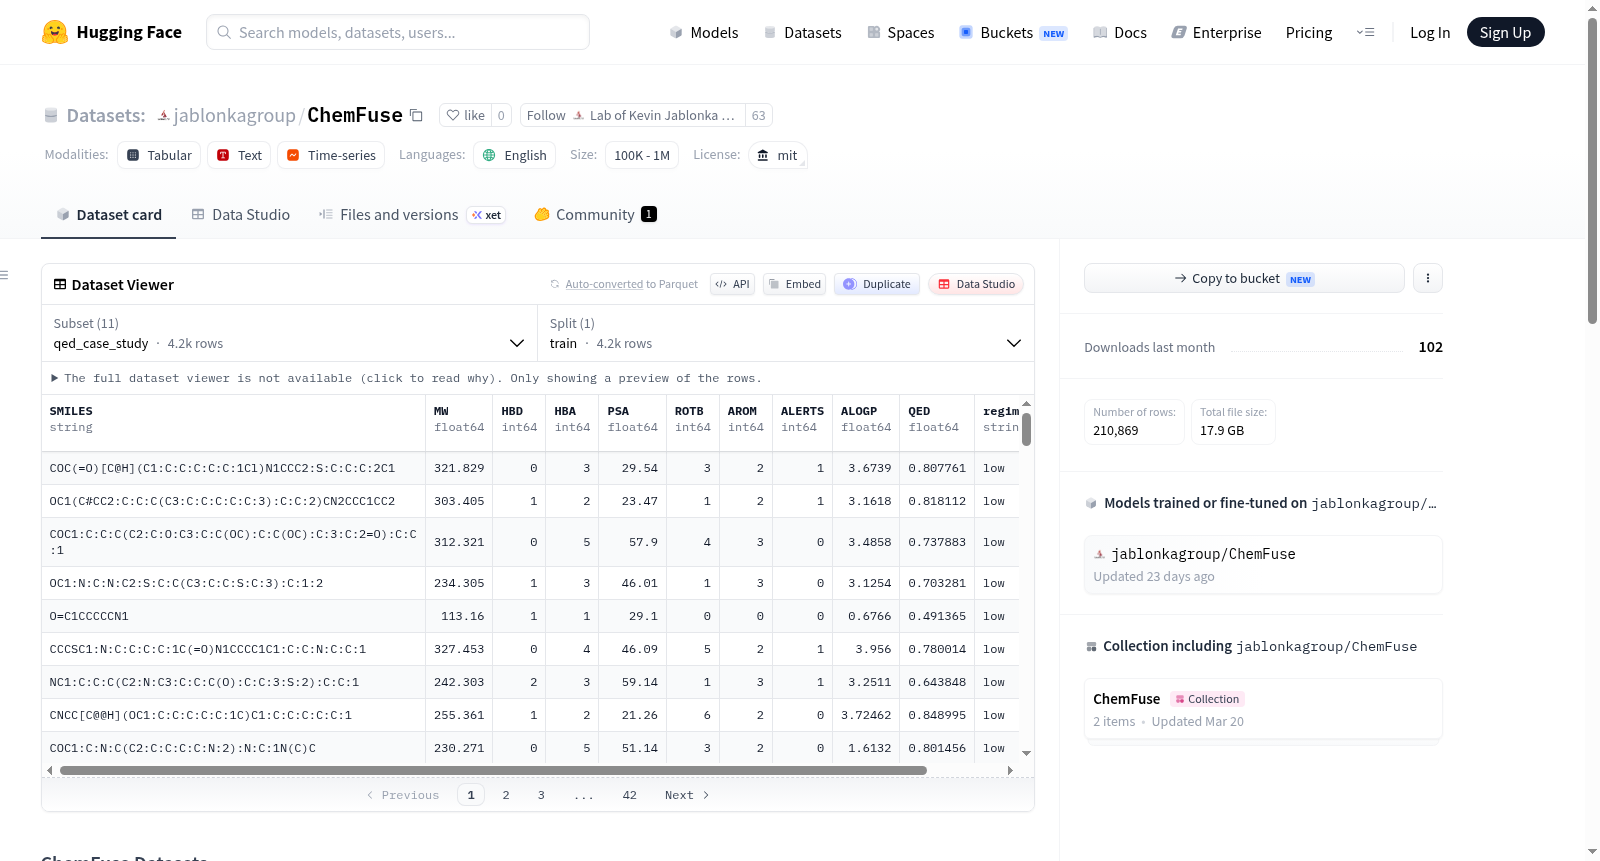
ChemFuse数据集由Jablonka课题组精心构建,旨在为化学多模态学习提供统一的基准平台。该数据集整合了聚合物、金属有机框架(MOFs)以及小分子三大类化学物质的海量无标签数据,并在此基础上扩展了若干有监督的下游任务数据集。构建过程中,分别利用PSMILES、BigSMILES和聚合物名称表征聚合物,采用MOFid、粉末X射线衍射(pXRD)和晶体结构三种模态描述MOFs,同时为小分子提供SMILES与核磁共振氢谱(HNMR)等多种表征形式。各模态数据以Parquet或CSV格式存储于HuggingFace仓库,并通过预定义的配置名称(如polymer_unlabelled、mof_unlabelled_mofid)组织,便于按需加载。
特点
ChemFuse数据集的突出特点在于其跨化学体系的模态融合能力与广泛的覆盖规模。涵盖超过百万条数据记录,囊括聚合物、MOFs和小分子三大核心化学领域,每种物质均配备多种互补的表征方式,如聚合物的SMILES序列与名称、MOFs的晶体结构与衍射图谱,以及小分子的光谱信息。这种多模态对齐设计为自监督学习与多视角表示学习提供了理想的数据基础。此外,数据集包含一系列精心标注的下游任务,如玻璃化转变温度、熔点、溶解度及气体吸附量等关键物性预测,使其既适用于预训练也便于评测模型性能。
使用方法
使用ChemFuse数据集时,研究者可通过HuggingFace Datasets库便捷加载。例如,加载聚合物无标签数据使用'ChemFuse'数据集名称并指定配置为'polymer_unlabelled',将自动获取训练与测试集的CSV文件。对于MOFs数据,可根据模态选择'mof_unlabelled_mofid'、'mof_unlabelled_pxrd'或'mof_unlabelled_crystal_structure'配置。下游任务数据集同样通过对应配置名称(如'molecule_melting_point'、'mof_pure_uptake_co2_298k_16bar')加载,返回的每个样本包含相应的分子表征嵌入和物性标签。数据格式支持直接与PyTorch或TensorFlow框架集成,方便用于表示学习或微调实验。
背景与挑战
背景概述
ChemFuse数据集由Jablonka课题组于近期构建并发布,旨在解决材料科学领域中多模态数据融合的难题。该数据集的核心研究问题是如何将聚合物、金属有机框架(MOF)及小分子等不同化学实体在多种表征形式(如SMILES、MOFid、粉末X射线衍射图谱、晶体结构等)下的信息进行统一表征与建模。通过整合超过百万条未标记样本与涵盖玻璃化转变温度、熔点、溶解度及气体吸附能力等多类性质的下游任务标注数据,ChemFuse为多模态化学基础模型的预训练与评估提供了标准化基准。其提出不仅推动了化学信息学向多模态、多任务学习范式演进,也为材料基因组学和药物设计等领域的高通量虚拟筛选开辟了新路径,在学术界与工业界均展现出显著影响力。
当前挑战
ChemFuse所面临的挑战首先源自领域问题的复杂性:不同化学实体(小分子、聚合物、MOF)的表示方式差异巨大,如何设计跨模态对齐机制使得模型能同时理解SMILES序列、二维图谱与三维晶体结构,是材料信息学长期未解的难题。其次,构建过程中遭遇了多重障碍:数据异构性强,各子集来源于不同文献与数据库,元数据格式与质量参差不齐;标签稀疏且不平衡,部分性质的实验测量值极为稀缺,需依赖模拟或推算数据进行扩充;此外,大规模多模态数据的存储与高效检索亦对索引结构与硬件算力构成严苛考验。这些挑战共同定义了当前多模态化学数据集构建的技术边界,也是ChemFuse旨在突破的核心瓶颈。
常用场景
经典使用场景
ChemFuse数据集以其多模态、多尺度的化学信息融合特性,成为材料科学与化学信息学领域内预训练与表示学习的标杆性资源。该数据集最经典的使用场景在于为跨分子、聚合物与金属有机框架(MOFs)的统一嵌入学习提供训练基础,研究人员可借助其未标注的原始数据(如SMILES、PSMILES、BigSMILES、MOFid、粉末X射线衍射图谱及晶体结构)构建自监督或对比学习模型,从而捕捉不同化学实体间的深层结构关联。
实际应用
在实际应用中,ChemFuse数据集直接赋能了高通量虚拟筛选与逆向材料设计流程。例如,基于其提供的聚合物玻璃化转变温度标注数据,工业界可快速预测新型热塑性材料的耐热性能;利用MOFs的二氧化碳与甲烷纯组分吸附数据,研究者能高效评估候选吸附剂在碳捕集或天然气存储场景下的潜力。此外,分子熔点和溶解性的综合标注支持药物候选化合物的理化性质预测,加速药物研发的早期优化环节,显现出从基础科研到产业落地的广泛实用价值。
衍生相关工作
基于ChemFuse数据集,已衍生出多项标志性研究工作,尤以ChemFuse框架本身为代表,该工作首次提出了一种跨分子、聚合物与MOFs的通用多模态融合架构,并展示了其在零样本性质预测上的突破性表现。此外,研究人员利用该数据集中的未标注光谱与结构数据,开发了针对MOFs的对比学习预训练模型,显著提升了气体吸附容量的预测准确率。在药物化学领域,该数据集中的QED案例研究促进了基于多描述符融合的药物相似性评估新方法,推动了化学语言模型在分子优化中的应用边界。
以上内容由遇见数据集搜集并总结生成


