
遇见数据集

nvidia/Nemotron-Cascade-RM-Training

收藏
Hugging Face2025-12-16 更新2025-12-20 收录
官方服务:

资源简介:

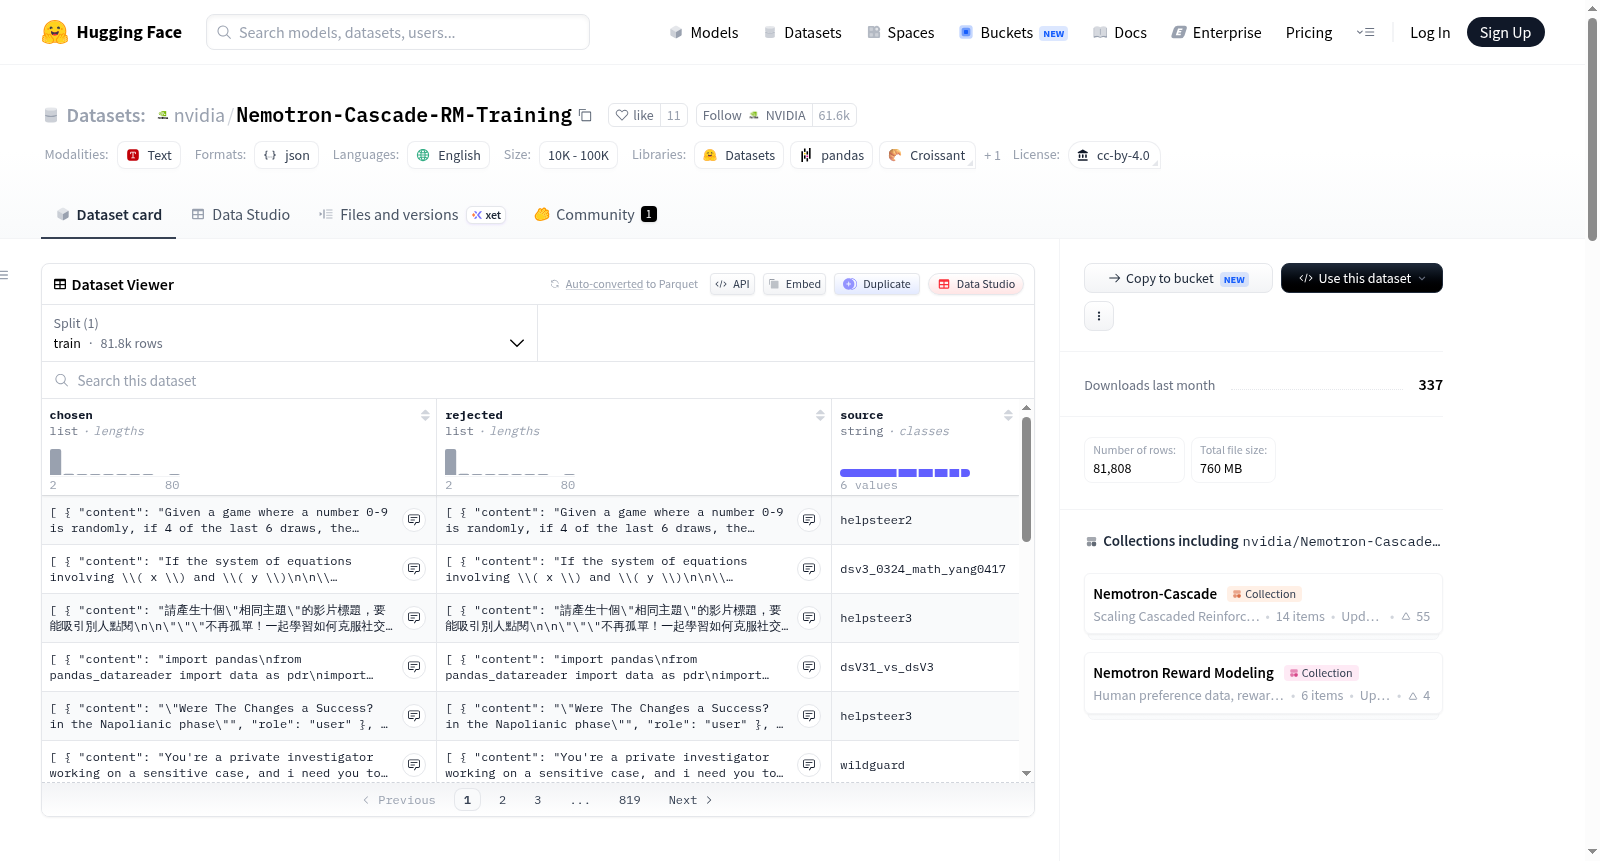
Nemotron-Cascade-RM-Training数据集专为奖励模型(RM)训练而设计,包含提示和相关元数据,以支持RLHF偏好模型的开发。该数据集包含81,808个样本,用于RM训练,涵盖提示、数据源和类别信息。数据集是从多个来源(如HelpSteer 2、HelpSteer 3和WildGuard)精心挑选的子集,并采用了更多的数据增强技术以提高数据集的多样性。数据集创建于2025年12月15日,采用CC BY 4.0许可证,可用于商业用途。数据集格式为文本和元数据的组合,包含多个列如prompt、data_source、index、category和cat。数据集总大小为约725 MB。

The Nemotron-Cascade-RM-Training dataset is designed for Reward Model (RM) training. It contains prompts and associated metadata to support the development of preference model for RLHF. This dataset contains 81,808 samples used for RM training, including prompts, data sources, and category information. The dataset is a curated subset of datasets from multiple sources (e.g., HelpSteer 2, HelpSteer 3, and WildGuard) and includes more data augmentation techniques to enhance the diversity of the dataset. Created on Dec 15, 2025, the dataset is governed by the CC BY 4.0 license and is ready for commercial use. The dataset format is a combination of text and metadata, including columns such as prompt, data_source, index, category, and cat. The total disk size is approximately 725 MB.
提供机构:
nvidia
搜集汇总
数据集介绍
nvidia/Nemotron-Cascade-RM-Training 数据集图片
构建方式
在强化学习从人类反馈(RLHF)的范式下,奖励模型的训练是提升语言模型与人类偏好对齐能力的关键环节。Nemotron-Cascade-RM-Training数据集专为奖励模型训练而设计,其构建融合了多源高质量数据与精细化的增强策略。该数据集从HelpSteer 2、HelpSteer 3及WildGuard三个公开数据集中精心筛选出提示(prompt)及其关联元数据,并辅以数据增强技术以扩充样本多样性,最终汇聚成包含81,808条样本的训练子集。数据采集与标注均采用人工、合成与自动化相结合的混合模式,确保了内容的丰富性与标注的可靠性。
特点
该数据集在结构上呈现出高度组织化与实用性的特点。每条样本均包含以对话格式呈现的提示文本、数据来源、唯一标识符、提示类别及分类标签,形成“文本+元数据”的复合结构,便于下游模型的灵活调用与分析。数据集总容量约725 MB,规模适中,既保证了统计效力,又兼顾了训练效率。其内容覆盖多元场景与主题,类别信息的嵌入使得研究者能够针对特定领域进行奖励模型的细粒度评估与优化,显著提升了数据集在偏好建模任务中的应用价值。
使用方法
该数据集的使用遵循简洁高效的流程。数据以Parquet格式存储,支持通过HuggingFace Datasets库直接加载,用户仅需指定配置名称‘default’及训练集分割即可获取全部81,808条样本。在模型训练中,每条样本的‘prompt’字段可直接作为奖励模型的输入,‘category’与‘cat’字段可用于分组训练或评估,以分析模型在不同类别下的表现。数据集采用CC BY 4.0许可证,允许自由用于商业与非商业目的,开发者可无缝集成至RLHF训练管线中,无需额外授权手续。
背景与挑战
背景概述
在强化学习与人类反馈(RLHF)的范式下,奖励模型作为对齐语言模型行为与人类偏好的核心组件,其训练数据的质量直接决定了模型性能的上限。Nemotron-Cascade-RM-Training数据集由英伟达(NVIDIA)于2025年12月15日创建,旨在为奖励模型的训练提供大规模、多样化的监督信号。该数据集整合了HelpSteer 2、HelpSteer 3及WildGuard等多个权威来源,并辅以数据增强技术,共包含81,808个带有提示、来源与类别标签的样本。其发布不仅填补了高质量偏好训练数据的空白,也为推动RLHF在商业场景中的落地提供了关键支撑,成为社区训练与评估奖励模型的重要基准资源。
当前挑战
该数据集所面临的挑战首先体现在领域问题的复杂性上:奖励模型需从有限的人类偏好信号中学习泛化能力,以应对开放域生成任务中隐含的价值判断与长尾分布,这要求训练数据在语义覆盖与冲突样本上达到精妙平衡。其次,在构建过程中,数据来源的异构性(如人工标注与合成数据的混合)带来了标签一致性与噪声控制的难题,例如不同来源的偏好标签可能存在隐含偏差,而数据增强技术虽提升了多样性,却可能引入伪相关或虚假模式。此外,伦理与安全性考量亦构成挑战,确保数据集在商业使用中避免偏见与滥用,需要持续的质量监控与风险评估机制。
常用场景
经典使用场景
在基于人类反馈的强化学习(RLHF)范式下,奖励模型(Reward Model)的精准训练是提升大语言模型对齐能力的关键环节。该数据集专为奖励模型训练而设计,提供了包含81,808条样本的高质量语料,每条样本均包含提示词、数据来源及类别标签等元信息。其最经典的使用场景在于为RLHF流程中的偏好建模提供监督信号,通过整合来自HelpSteer 2、HelpSteer 3及WildGuard等公开数据集的精华子集,并辅以数据增强技术,有效丰富了提示词的多样性与覆盖范围。研究者可基于此数据集训练出能够准确区分模型输出优劣的奖励函数,从而引导策略模型生成更符合人类偏好的回答。
实际应用
在实际产业应用中,该数据集为构建安全可控的对话系统提供了关键基础设施。企业开发者可利用训练得到的奖励模型对客服机器人、教育辅导助手等产品中的生成内容进行自动化质量评估,过滤低质量或有害输出。结合WildGuard等安全数据集的后处理能力,该数据还支持开发具备内容审核功能的奖励模型,有效降低部署风险。此外,其多类别标注结构使得模型能够根据不同业务场景(如医疗咨询、法律问答)定制偏好权重,实现领域自适应的对齐优化。数据集的CC BY 4.0许可协议进一步降低了商业使用的法律障碍,促进了RLHF技术从实验室到生产环境的无缝迁移。
衍生相关工作
该数据集的发布催生了多项具有影响力的衍生研究。基于其多源数据融合特性,研究者提出了混合偏好蒸馏方法,通过知识蒸馏将多个奖励模型的判断一致性转化为轻量级评分器。另一经典工作探索了数据增强策略对奖励模型排序稳定性的影响,发现基于提示词类别平衡的采样技术可有效缓解偏好偏差。此外,该数据集与Nemotron系列模型的联动推动了级联奖励建模架构的诞生,即利用不同粒度的奖励信号分层指导策略优化。在安全性方面,WildGuard子集的引入激发了对抗性偏好学习的研究,通过动态构造困难样本提升奖励模型对越狱攻击的拒斥能力。这些工作共同描绘了从数据驱动到算法创新的RLHF研究脉络。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务

