LLaVA-OneVision-Mid-Data
收藏资源简介:
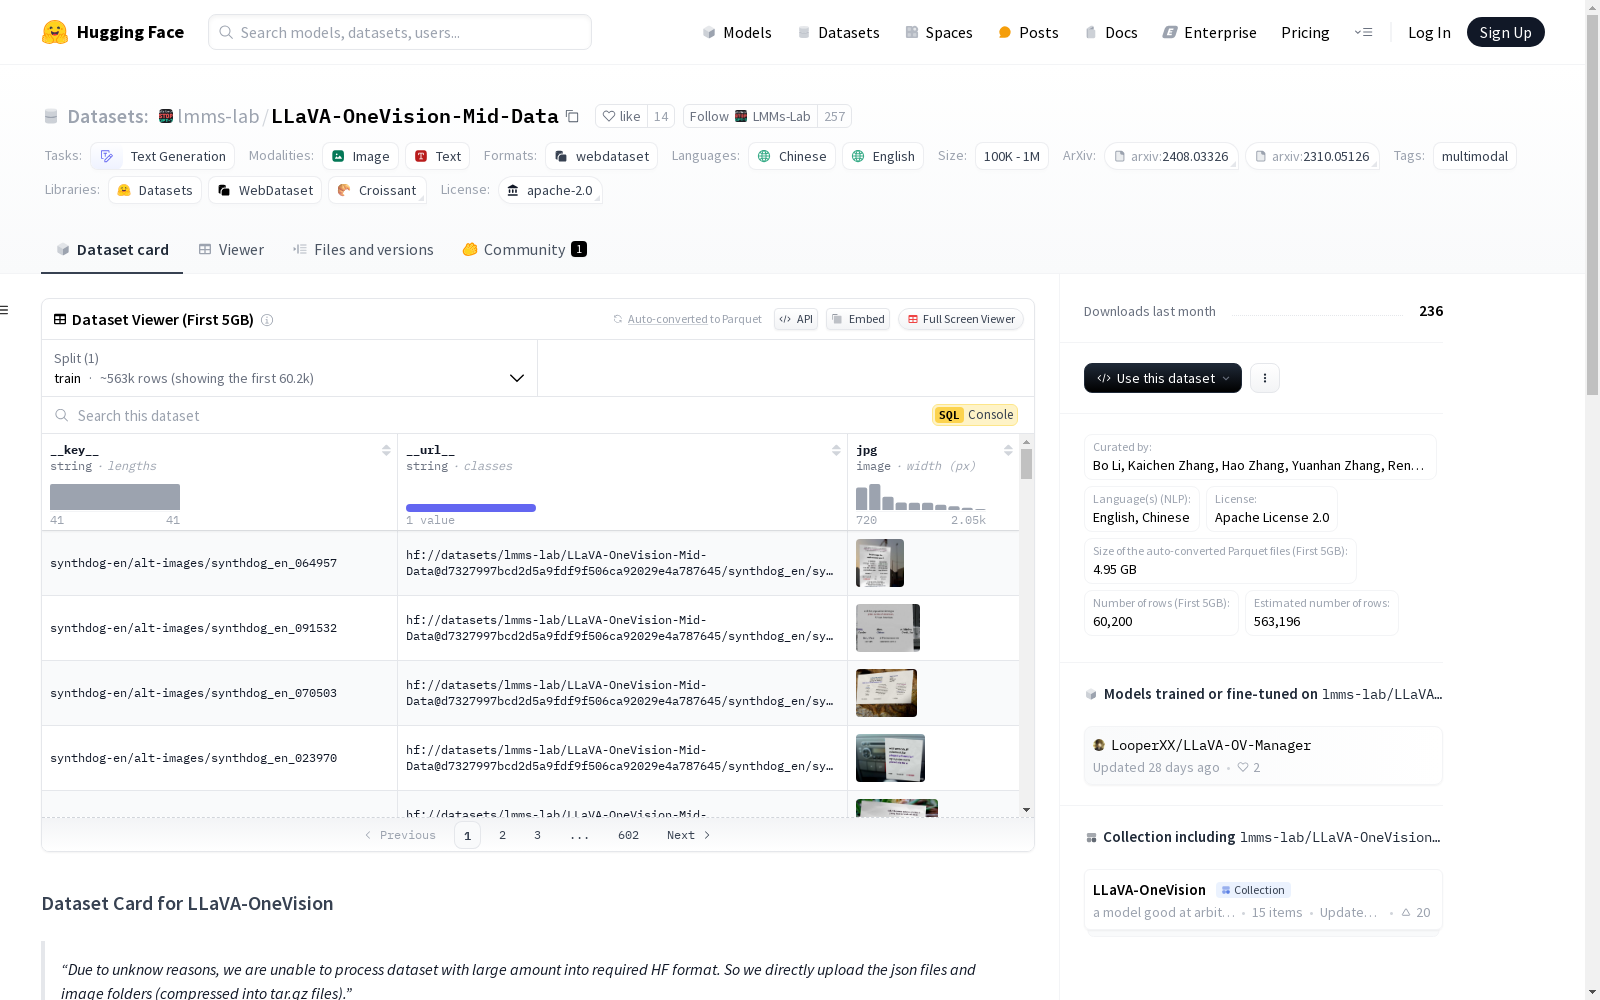
LLaVA-OneVision数据集由Bo Li, Kaichen Zhang, Hao Zhang, Yuanhan Zhang, Renrui Zhang, Feng Li, Dong Guo等人策划,包含用于最终图像阶段和one-vision阶段的数据分割。数据集包括从Cambrian, Cauldron, UReader等现有数据集集合中提取的子集,以及AI2D, OKVQA等单源数据集。该数据集用于训练LLaVA-OneVision中阶段模型,仅允许用于学术研究和教育目的。数据集以Hugging Face Dataset兼容格式上传,使用json和image/video文件夹存储数据。
The LLaVA-OneVision dataset was curated by Bo Li, Kaichen Zhang, Hao Zhang, Yuanhan Zhang, Renrui Zhang, Feng Li, Dong Guo, et al. It contains data splits for the final image stage and the one-vision stage. The dataset includes subsets extracted from existing dataset collections such as Cambrian, Cauldron, and UReader, as well as single-source datasets like AI2D and OKVQA, among others. This dataset is intended for training the staged models in LLaVA-OneVision, and is only permitted for academic research and educational purposes. It is uploaded in a Hugging Face Dataset-compatible format, with data stored in JSON files and image/video folders.
数据集卡片 for LLaVA-OneVision
数据集描述
- 由以下人员策划: Bo Li, Kaichen Zhang, Hao Zhang, Yuanhan Zhang, Renrui Zhang, Feng Li, Dong Guo
- 语言(NLP): 英语, 中文
- 许可证: Apache License 2.0
数据集来源
- 数据集收集: 包含来自现有数据集集合 Cambrian, Cauldron, UReader 的几个子集。由于我们仅使用了这些数据集的几个子集,并进行了清洗和重新标注过程,我们将处理后的版本上传到我们自己的仓库,并感谢原作者提供原始数据集。
- 其他数据集: 对于剩余的单一来源数据集,如 AI2D, OKVQA,我们在论文中引用并链接到原始来源。
用途
该数据集用于训练 LLaVA-OneVision Mid-Stage 模型。我们仅允许将此数据集用于学术研究和教育目的。对于 OpenAI GPT-4 生成的数据,我们建议用户查看 OpenAI 使用政策。
数据集结构
我们在 训练文档 中解释了中阶段和最终阶段的数据组成。
代码指导
为了帮助受众更好地理解我们的数据集,我们将其上传到与 Hugging Face 数据集兼容的格式。在 LLaVA-OneVision 训练期间,我们使用 json 和 image/video 文件夹来存储数据。
以下是转换数据集格式并进行 LLaVA-OneVision 模型训练的代码指导:
python import os from datasets import load_dataset from tqdm import tqdm import json
data = load_dataset("lmms-lab/LLaVA-OneVision-Mid-Data", split="train")
image_folder = "<your_image_folder>"
converted_data = []
for da in tqdm(data): json_data = {} json_data["id"] = da["id"] if da["image"] is not None: json_data["image"] = f"{da[id]}.jpg" da["image"].save(os.path.join(image_folder, json_data["image"])) json_data["conversations"] = da["conversations"] converted_data.append(json_data)
with open("<your_json_file>.json", "w") as f: json.dump(converted_data, f, indent=4, ensure_ascii=False)
数据集卡片作者
该数据集由以下作者策划:
Bo Li, Kaichen Zhang, Hao Zhang, Yuanhan Zhang, Renrui Zhang, Feng Li
数据集卡片联系人
Bo Li: drluodian@gmail.com