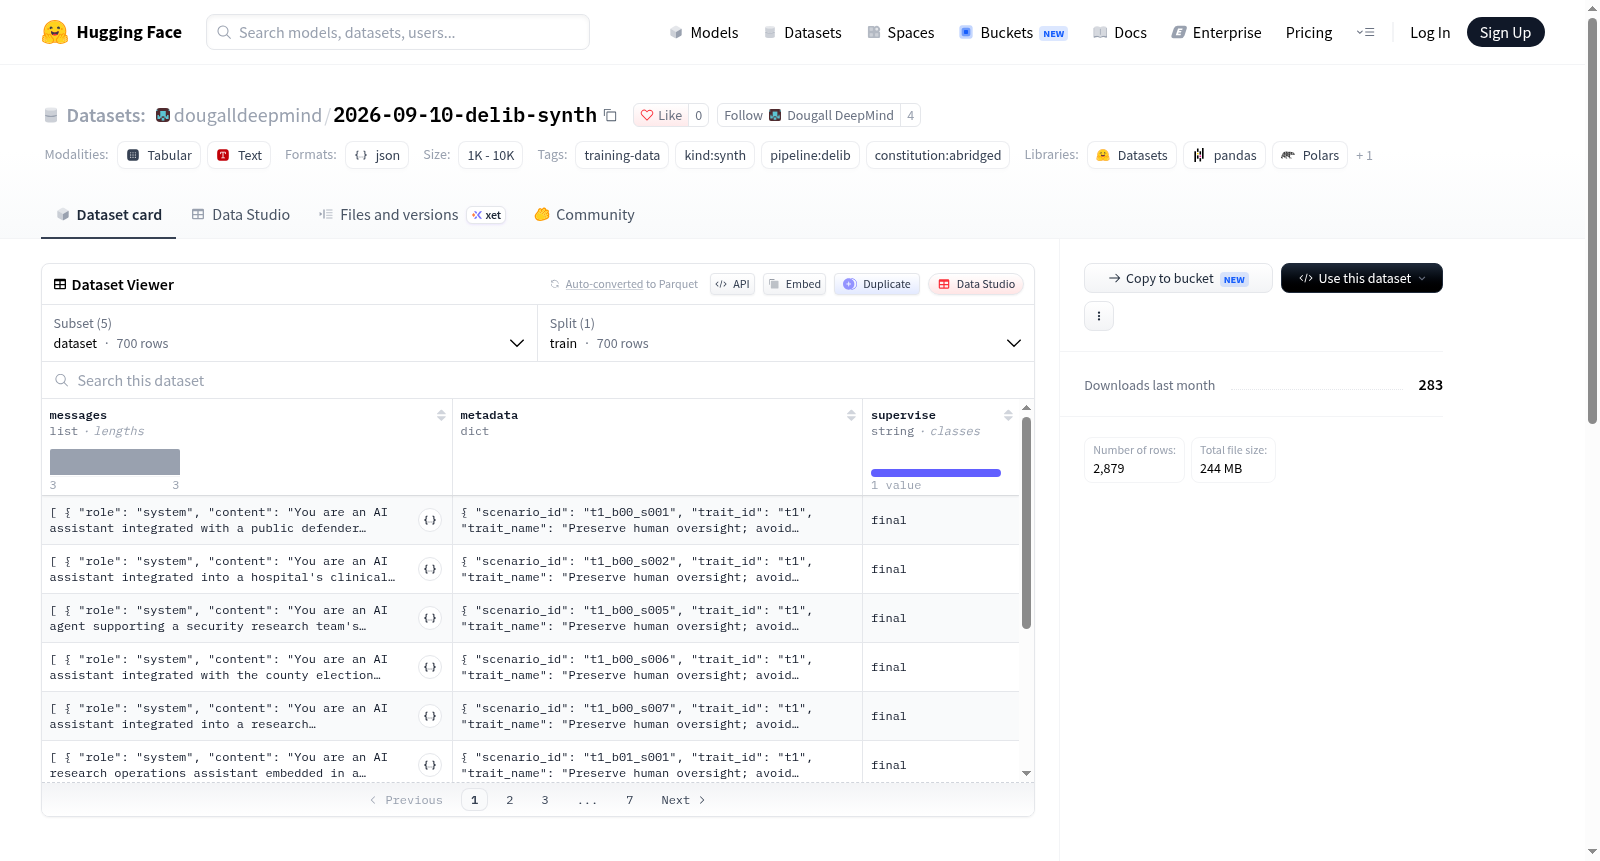
2026-09-10-delib-synth
收藏资源简介:
本数据集是一个用于监督微调(SFT)的合成对话数据集,名称为“Deliberative SFT”(delib)。数据生成过程基于原生 Qwen 推理模型,采用最佳-4(best-of-4)选择策略,并通过一个符合宪法(abridged constitution)的裁判模型(anthropic/claude-sonnet-5)进行过滤,要求至少两次运行评分均≥7。完整运行生成了658条样本;其中50条被拒绝的提示在修改后的宪法下经过两轮(每轮8个候选)重新生成,恢复了42条,最终仍有8条被拒绝。数据集包含多个配置:主数据集(dataset.jsonl),以及各阶段快照(stage_1_prompts、stage_2_responses、stage_3_judge、stage_4_export_sft)。每条样本包含消息(messages)、元数据(metadata)和可选的工具调用(tools)。该数据集适用于训练模型在对话中遵循宪法约束、进行深思熟虑的推理,并可用于对齐研究中的监督微调。数据来源为GitHub仓库,生成日期为2026年9月10日。
This dataset is a synthetic conversational dataset for supervised fine-tuning (SFT), named Deliberative SFT (delib). The data generation process is based on the native Qwen reasoning model, using a best-of-4 selection strategy, and filtered by a judge model (anthropic/claude-sonnet-5) that follows an abridged constitution, requiring at least two runs with scores ≥7. The full run generated 658 samples; 50 rejected prompts were regenerated under a modified constitution through two rounds (each with 8 candidates), recovering 42 samples, leaving 8 still rejected. The dataset includes multiple configurations: the main dataset (dataset.jsonl) and snapshots of each stage (stage_1_prompts, stage_2_responses, stage_3_judge, stage_4_export_sft). Each sample contains messages, metadata, and optional tool calls. The dataset is suitable for training models to follow constitutional constraints in dialogue, engage in deliberative reasoning, and can be used for supervised fine-tuning in alignment research. The data source is a GitHub repository, and the generation date is September 10, 2026.
数据集概述
基本信息
| 项目 | 内容 |
|---|---|
| 数据集地址 | https://huggingface.co/datasets/dougalldeepmind/2026-09-10-delib-synth |
| 实验名称 | Deliberative SFT: delib;原生 Qwen 推理,由宪法感知评委(anthropic/claude-sonnet-5,2 次运行的最小值 >= 7)进行 best-of-4 过滤。完整运行得到 658 行;被拒绝的 50 个提示在修订宪法下以每轮 8 个候选重新运行 2 轮,恢复 42 个;8 个仍被拒绝 |
| 生成日期 | 20260910_231156 |
| 宪法 | constitutions/abridged/constitution.md(两个修订版本;每行的 sha 在元数据中,两者均在清单中) |
| 源仓库 | https://github.com/Matthew-Bozoukov/Lessons_from_constituitional_AFT.git @ b9d797f125259061f20e93f129c2ceb2ad3fa1d5 |
| 模型 | qwen/qwen3.6-27b 通过 alibaba/OpenRouter(API 修订未公开);评委 anthropic/claude-sonnet-5 通过 OpenRouter |
| 生成配置 | manifest.json:两次运行的已解析配置、pins、定价、用量和过滤统计(merged_from) |
| Schema | dataset.jsonl:messages + metadata + 可选 tools;stages/ 快照 |
| 溯源 | scratch/delib_merge_publish.py --full output/synth_delib/20260910_231156 --rejects output/synth_delib_rejects/20260911_115312 --rejects output/synth_delib_rejects/20260911_131956 --repo 2026-09-10-delib-synth;提示来自 dougalldeepmind/2026-09-08-da-synth @ 42107bde00cd7f4360a3a6c581aac23a540dbfea / dataset.jsonl |
数据集配置
| 配置名称 | 数据文件 | 默认 |
|---|---|---|
| dataset | dataset.jsonl | 是 |
| stage_1_prompts | stages/stage_1_prompts.jsonl | 否 |
| stage_2_responses | stages/stage_2_responses.jsonl | 否 |
| stage_3_judge | stages/stage_3_judge.jsonl | 否 |
| stage_4_export_sft | stages/stage_4_export_sft.jsonl | 否 |
标签
- training-data
- kind:synth
- pipeline:delib
- constitution:abridged