
遇见数据集

MSRVTT-I2V

收藏
Hugging Face2026-07-18 更新2026-07-19 收录
官方服务:

资源简介:

MSRVTT-I2V是一个基于MSR-VTT视频数据集构建的图像到视频检索任务专用数据集,来源于UVRB基准,旨在为跨模态检索研究提供标准化的评估数据。数据内容包含查询集(由1,000个从原始视频中预留出的独立视频帧构成)和语料库(对应的1,000个完整的MSR-VTT视频),采用MTEB标准检索格式进行组织,包括语料库文档、查询和相关性判断等标准组件,便于在统一框架下进行检索模型的训练与评估。该数据集适用于图像-视频跨模态检索、表示学习等相关研究任务。

MSRVTT-I2V is a dedicated image-to-video retrieval dataset constructed based on the MSR-VTT video dataset, derived from the UVRB benchmark, aiming to provide standardized evaluation data for cross-modal retrieval research. The dataset includes a query set (composed of 1,000 independent video frames reserved from the original videos) and a corpus (the corresponding 1,000 complete MSR-VTT videos). It is organized in the MTEB standard retrieval format, covering standard components such as corpus documents, queries and relevance judgments, which facilitates the training and evaluation of retrieval models under a unified framework. This dataset is suitable for research tasks such as image-video cross-modal retrieval and representation learning.

创建时间:
2026-07-17
原始信息汇总

数据集概述:MSRVTT-I2V

该数据集是基于 MSR-VTT 构建的图像到视频检索分割数据集,源自 UVRB 基准(arXiv:2510.27571)。

  • 用途:图像到视频检索(Image-to-video retrieval)。
  • 规模
    • 查询(Queries):1,000 个保留的视频帧。
    • 语料库(Corpus):对应的 1,000 个 MSR-VTT 视频。
  • 格式:采用 MTEB 标准检索格式,包含四个配置:
    • corpus:语料库,测试集(test)。
    • queries:查询,测试集(test)。
    • pc:测试集(test)。
    • qrels:相关度判断,测试集(test)。
  • 许可证:其他(msr-vtt-research),详情请参见微软研究院(https://www.microsoft.com/en-us/research/)。
搜集汇总
数据集介绍
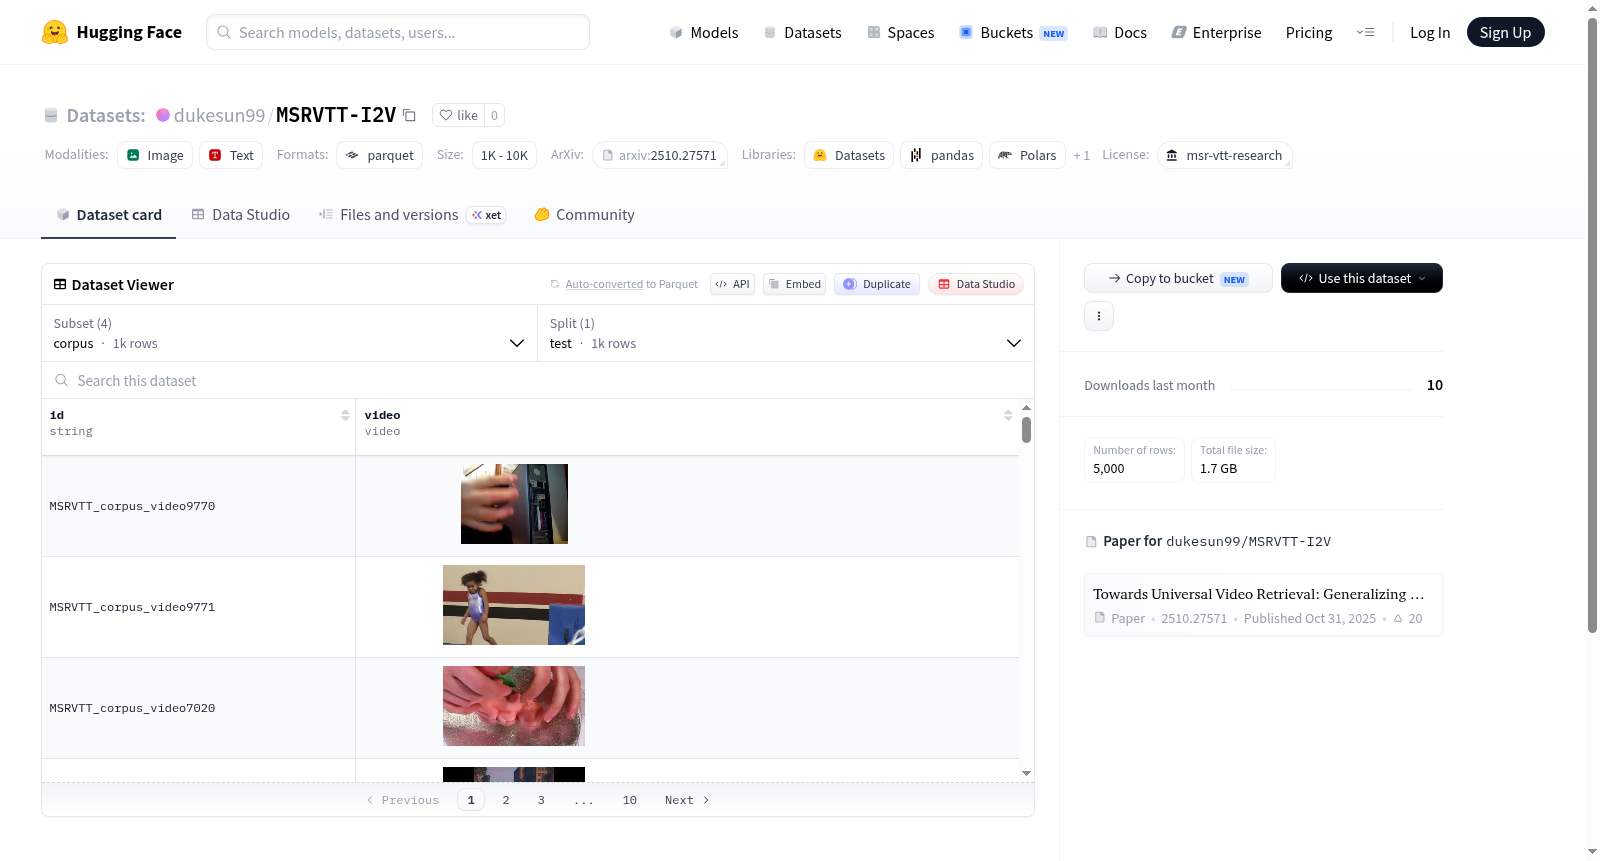
MSRVTT-I2V 数据集图片
构建方式
MSRVTT-I2V数据集基于经典的MSR-VTT视频理解数据集构建,专为图像到视频检索任务设计。其构建过程借鉴了UVRB基准(https://arxiv.org/abs/2510.27571)的划分策略,从MSR-VTT中精心筛选出1,000个视频帧作为查询集(queries),这些帧均来自原始视频中未曾公开的样本。对应的检索语料库(corpus)则包含与查询帧一一匹配的1,000个MSR-VTT视频片段。数据采用MTEB标准检索格式进行封装,分别存储为语料库、查询集、相关判断集(qrels)以及点积相似度矩阵(pc),确保检索任务的完整性与可复现性。
使用方法
使用MSRVTT-I2V数据集时,研究者需加载MTEB标准格式的四个子集:corpus、queries、pc和qrels。具体流程为:首先将查询集中的图像特征与语料库中的视频特征通过合适的视觉编码器(如CLIP、ViT)提取,计算图像与每个视频的特征相似度(如余弦相似度),随后依据qrels中的标注信息评估检索精度(如Recall@K、MRR)。由于数据集规模适中(1,000对样本),适用于快速迭代模型验证,也可作为多模态检索系统的子任务模块进行集成测试。
背景与挑战
背景概述
随着多媒体内容在互联网上的爆炸性增长,跨模态检索技术成为连接视觉与语言信息的关键桥梁。MSRVTT-I2V数据集诞生于2025年,由UVRB基准测试的研究团队基于经典的MSR-VTT数据集构建,核心研究问题聚焦于图像到视频的跨模态检索任务。该数据集筛选出1000个视频帧作为查询,对应1000个MSR-VTT视频形成语料库,旨在评估模型从静态图像中检索动态视频内容的能力。作为UVRB基准的重要组成部分,MSRVTT-I2V为视频理解与检索领域提供了标准化的评估框架,推动了多模态学习算法在细粒度语义匹配上的发展,对视频搜索引擎、智能剪辑等领域具有显著影响力。
当前挑战
MSRVTT-I2V数据集面临的挑战主要来自两个层面。在领域问题层面,图像到视频检索需解决视觉模态间的语义鸿沟,静态图像仅包含空间信息而视频蕴含时间动态,模型需同时捕捉帧内的视觉特征与帧间的时序关联,这对编码器设计提出更高要求。在构建过程中,研究人员需从MSR-VTT的20万对视频-文本数据中精心挑选测试样本,确保图像帧与对应视频在内容上具有语义一致性且避免泄露训练集中出现的场景,同时平衡检索难度以避免评估指标饱和,这些工程细节直接影响基准测试的可靠性。
常用场景
经典使用场景
MSRVTT-I2V数据集专为图像到视频检索任务而设计,其经典使用场景在于从大量视频库中精准定位与给定静态图像语义匹配的视频片段。这一场景源于跨模态检索的核心需求,即如何弥合图像与视频这两种异构视觉表征之间的鸿沟。在学术研究中,该数据集常被用作基准测试,评估模型能否从视频中抽取与图像共享关键视觉元素或动作语义的片段,从而推动视觉语言跨模态理解能力的提升。
解决学术问题
MSRVTT-I2V数据集致力于解决视觉检索领域中图像与视频跨模态对齐的典型难题。传统研究多聚焦于文本与视频或图像之间的交互,而该数据集直接挑战图像作为查询项时如何有效表征其静态语义并匹配视频中的动态时序信息。它揭示了静态视觉提示与动态视觉内容存在语义不对称性的关键问题,其意义在于为研究者提供了标准化的评估框架,以探索更鲁棒的跨模态表征学习策略,对推动细粒度视觉理解技术的发展具有深远影响。
实际应用
在实际应用中,MSRVTT-I2V数据集的能力可赋能多种工业级视觉搜索系统,例如智能视频监控中的通过单帧截图追溯完整事件片段、影视资料库中以关键剧照检索对应视频段落,以及社交媒体平台中基于用户上传照片定位相关视频内容。这些应用场景依赖模型从海量视频中高效提取与查询图像高度相似的视觉特征,该数据集的构建为开发更精确、更快速的图像到视频搜索引擎提供了宝贵的训练和测试资源,显著提升了多媒体信息检索的实用性与鲁棒性。
数据集最近研究
最新研究方向
MSRVTT-I2V数据集作为图像到视频检索领域的标杆性基准,近期研究聚焦于跨模态语义对齐和细粒度时空特征融合。该数据集源自MSR-VTT并采用UV-RB形式(arXiv:2510.27571),将1000个视频帧构建为查询集,对应视频片段构成语料库,为评估多模态理解模型在零样本场景下的检索精度提供了标准化测试平台。前沿方向包括利用对比学习范式强化视觉-文本联合嵌入、探索视频帧序列中的动态语义演化,以及结合扩散模型实现高效跨模态转换。这一数据集推动了视觉语言模型在视频理解任务中的泛化能力研究,尤其在短视频平台内容搜索和智能监控事件回溯等热点应用中影响深远。
以上内容由遇见数据集搜集并总结生成
二维码
社区交流群
二维码
科研交流群
商业服务


